Python爬虫中requests库控制响应与代理配置
本文介绍Python爬虫中利用requests库优化服务器响应速度的方法。通过设置allow_redirects参数控制重定向行为,使用timeout参数限制请求等待时间以避免长时间挂起,并演示如何配置代理服务器以增强爬取稳定性。
2026-10-14
4

本文介绍Python爬虫中利用requests库优化服务器响应速度的方法。通过设置allow_redirects参数控制重定向行为,使用timeout参数限制请求等待时间以避免长时间挂起,并演示如何配置代理服务器以增强爬取稳定性。
本文系统梳理Python Scrapy框架在爬虫开发中的关键注意事项。涵盖利用Redis实现分布式去重与存储、通过Middleware处理代理IP与Headers、合理配置Settings文件、使用FormRequest提交表单数据,以及结合PhantomJS处理动态渲染页面的技术方案。旨在帮助开发者提升爬取效率与稳定性,解决常见技术痛点。
本文详解如何利用Python爬虫技术处理招聘数据。重点讲解如何校正拉勾网与Boss直聘的工作年限描述差异,建立统一的等级标准,并建议舍弃“经验不限”数据以保证统计准确性。同时提供基于PIL库的图片批量筛选代码实例,帮助开发者提升数据处理效率。
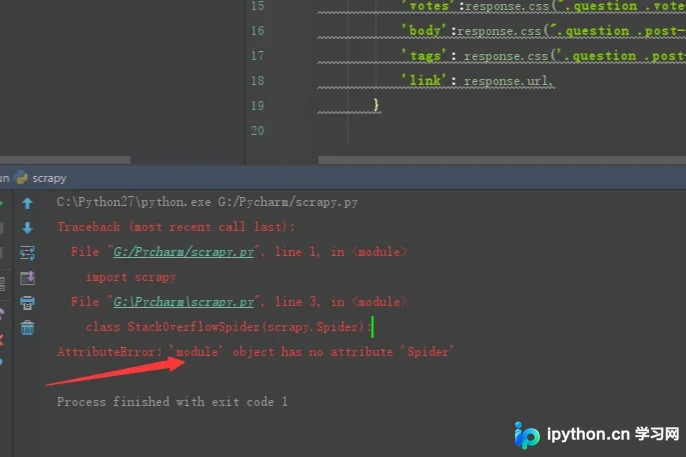
本文针对Python中使用Scrapy框架搭建爬虫时遇到的报错问题,深入分析了错误原因。核心问题在于用户自定义文件命名为scrapy.py,导致与Scrapy官方包名冲突,进而引发Spider属性查找错误。文章提供了具体的解决步骤和命名规范建议,帮助开发者快速定位并修复此类常见搭建错误,确保爬虫项目正常运行。
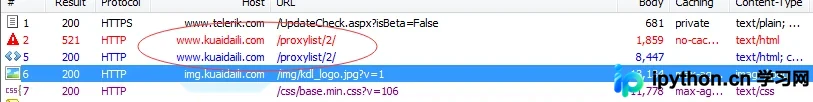
本文详细解析Python爬虫遇到网站返回521状态码及JS加密Cookie的解决方案。通过Fiddler抓包分析,揭示服务端返回混淆JS生成动态Cookie的机制。利用PyV8引擎在Python中执行JS代码,提取并解析Cookie字符串,最终实现携带有效Cookie成功获取数据的全过程。
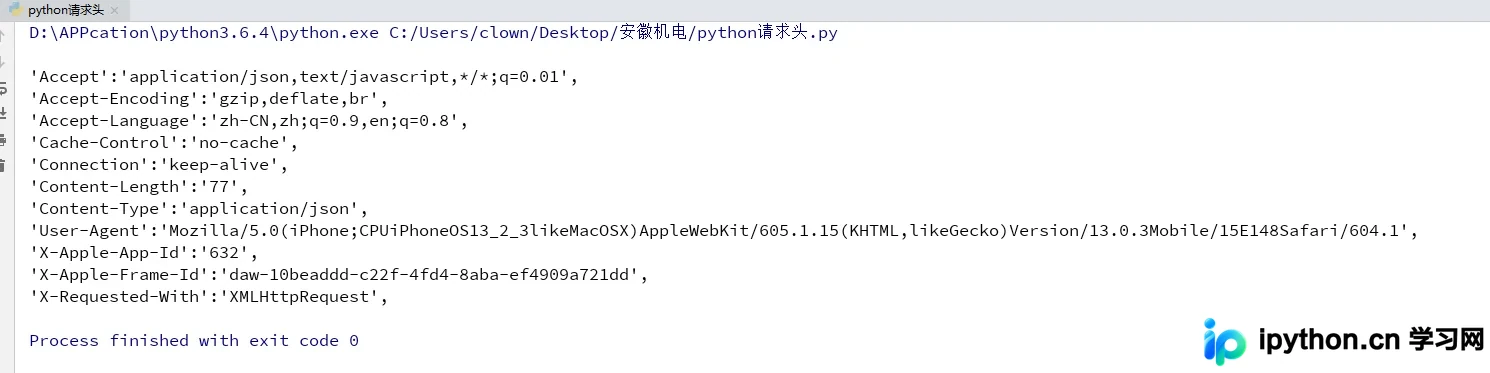
本文详解Python爬虫中Requests库设置Headers请求头的技巧。针对网页反爬限制,通过抓取浏览器真实请求头并模拟User-Agent等关键信息,有效绕过禁止爬取提示。文章提供从获取Headers到代码实现的完整步骤,帮助开发者解决爬虫访问被拒问题。
本文通过10个Python爬虫实例,详解requests库的get、post、put方法及其传参技巧。内容涵盖环境安装、响应对象处理、编码设置、文件保存及图片抓取,并演示如何通过修改User-Agent绕过知乎的反爬机制,适合初学者快速掌握网络数据采集基础。
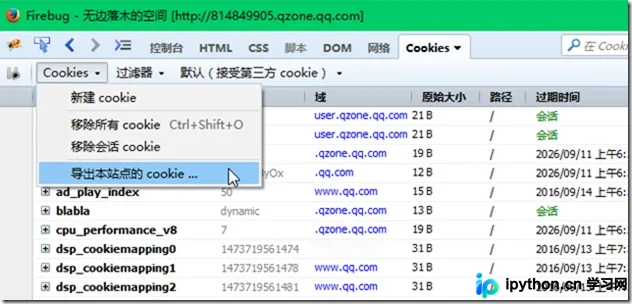
本文详解Python爬虫中Cookie的正确使用方法,解决需登录页面抓取难题。通过Firefox浏览器导出Netscape格式Cookie文件,修正格式错误后配合MozillaCookieJar实现自动登录模拟。文章还提供动态获取Cookie及Header注入两种进阶方案,帮助开发者高效绕过验证码与登录限制。
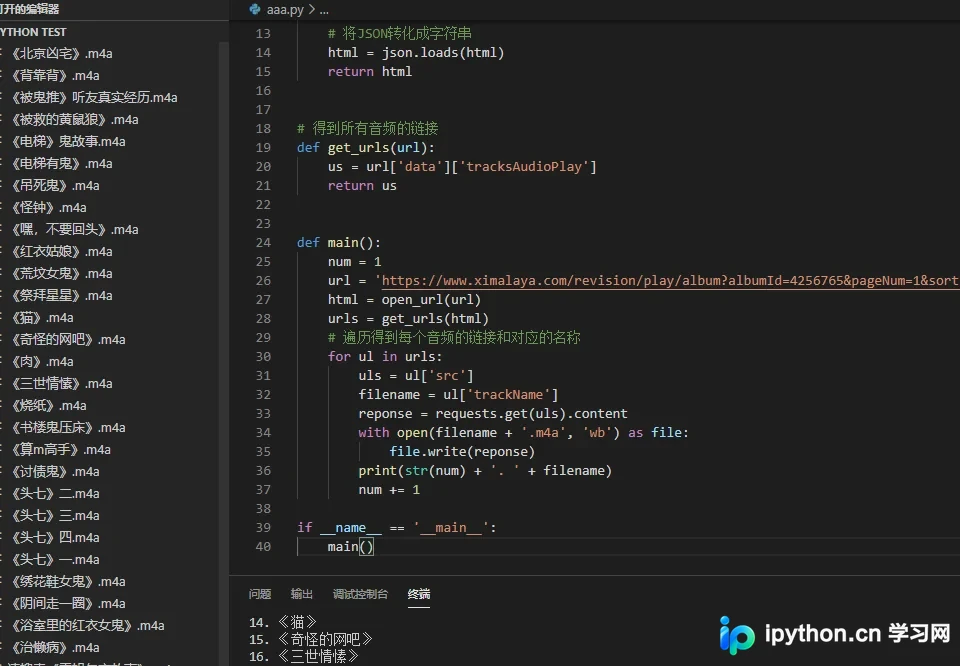
本文介绍如何使用Python编写脚本,从喜马拉雅网站抓取鬼故事专辑的音频文件。通过解析动态生成的JSON数据获取音频链接,并利用requests库实现批量下载保存为m4a格式。代码包含完整的请求头设置、URL解析及文件写入逻辑,适合初学者学习网络爬虫与文件处理。
本文详细记录了使用Charles工具抓取微信小程序数据并配合Python进行解析的全过程。内容涵盖Windows与iPhone的网络环境配置、Charles代理安装、SSL证书在电脑及iOS设备上的正确部署方法,以及针对证书信任失败、网络不通等常见问题的排查方案。通过获取接口URL及参数,可直接利用Python爬虫获取JSON数据,为移动端小程序数据分析提供有效技术手段。
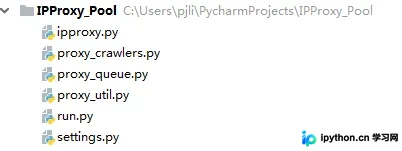
本文详细介绍Python爬虫代理池的搭建流程。针对IP访问频率限制问题,提出通过代理池轮询IP的解决方案。涵盖从代理网站抓取、可用性验证、Redis存储到队列管理的完整代码实现,包含IPProxy类、配置管理及多爬虫基类设计,并提供测试与GitHub源码地址。
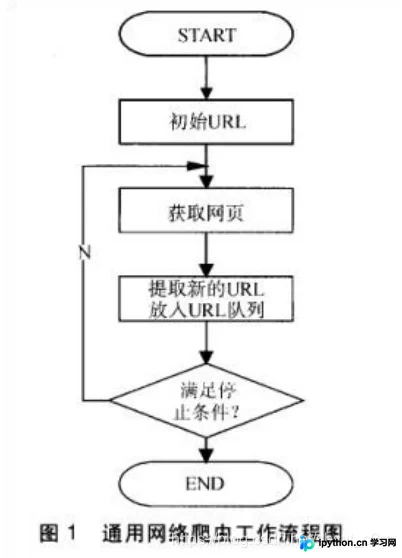
本文深入解析Python网络爬虫的两大核心类型:通用爬虫与聚焦爬虫。详细阐述通用爬虫在搜索引擎中的工作流程,包括种子URL选取、页面抓取、数据存储及预处理(分词、索引构建)等关键步骤,并探讨Robots协议的作用与局限性。同时,介绍聚焦爬虫如何通过主题筛选算法实现精准数据采集,对比两者在覆盖率、资源消耗及应用场景上的差异,并简述常见的反爬虫手段如IP限制与数据投毒,为开发者提供全面的技术参考。