Python Selenium 中 close() 与 quit() 关闭浏览器的区别
本文详解Python Selenium中关闭浏览器的两种方法:close()用于关闭当前窗口,quit()用于关闭所有窗口并释放驱动。通过代码示例展示如何在多窗口场景下遍历句柄并逐一关闭,帮助开发者正确管理浏览器资源。
2026-10-14
5

本文详解Python Selenium中关闭浏览器的两种方法:close()用于关闭当前窗口,quit()用于关闭所有窗口并释放驱动。通过代码示例展示如何在多窗口场景下遍历句柄并逐一关闭,帮助开发者正确管理浏览器资源。
本文详解Python Selenium中处理JavaScript三种弹窗(Alert、Confirm、Prompt)的方法。通过switch_to.alert定位弹窗,利用text获取内容,accept()确认,dismiss()取消,以及send_keys()输入文本。结合百度设置实例,展示完整操作流程与代码实现。
本文详解Python Selenium中多窗口切换的核心方法。通过current_window_handle获取当前句柄,利用window_handles获取所有窗口列表,并结合switch_to.window()实现窗口切换。文章提供完整代码示例,演示从百度首页跳转至注册页后的窗口切换与标题打印逻辑,帮助开发者解决新窗口操作难题。
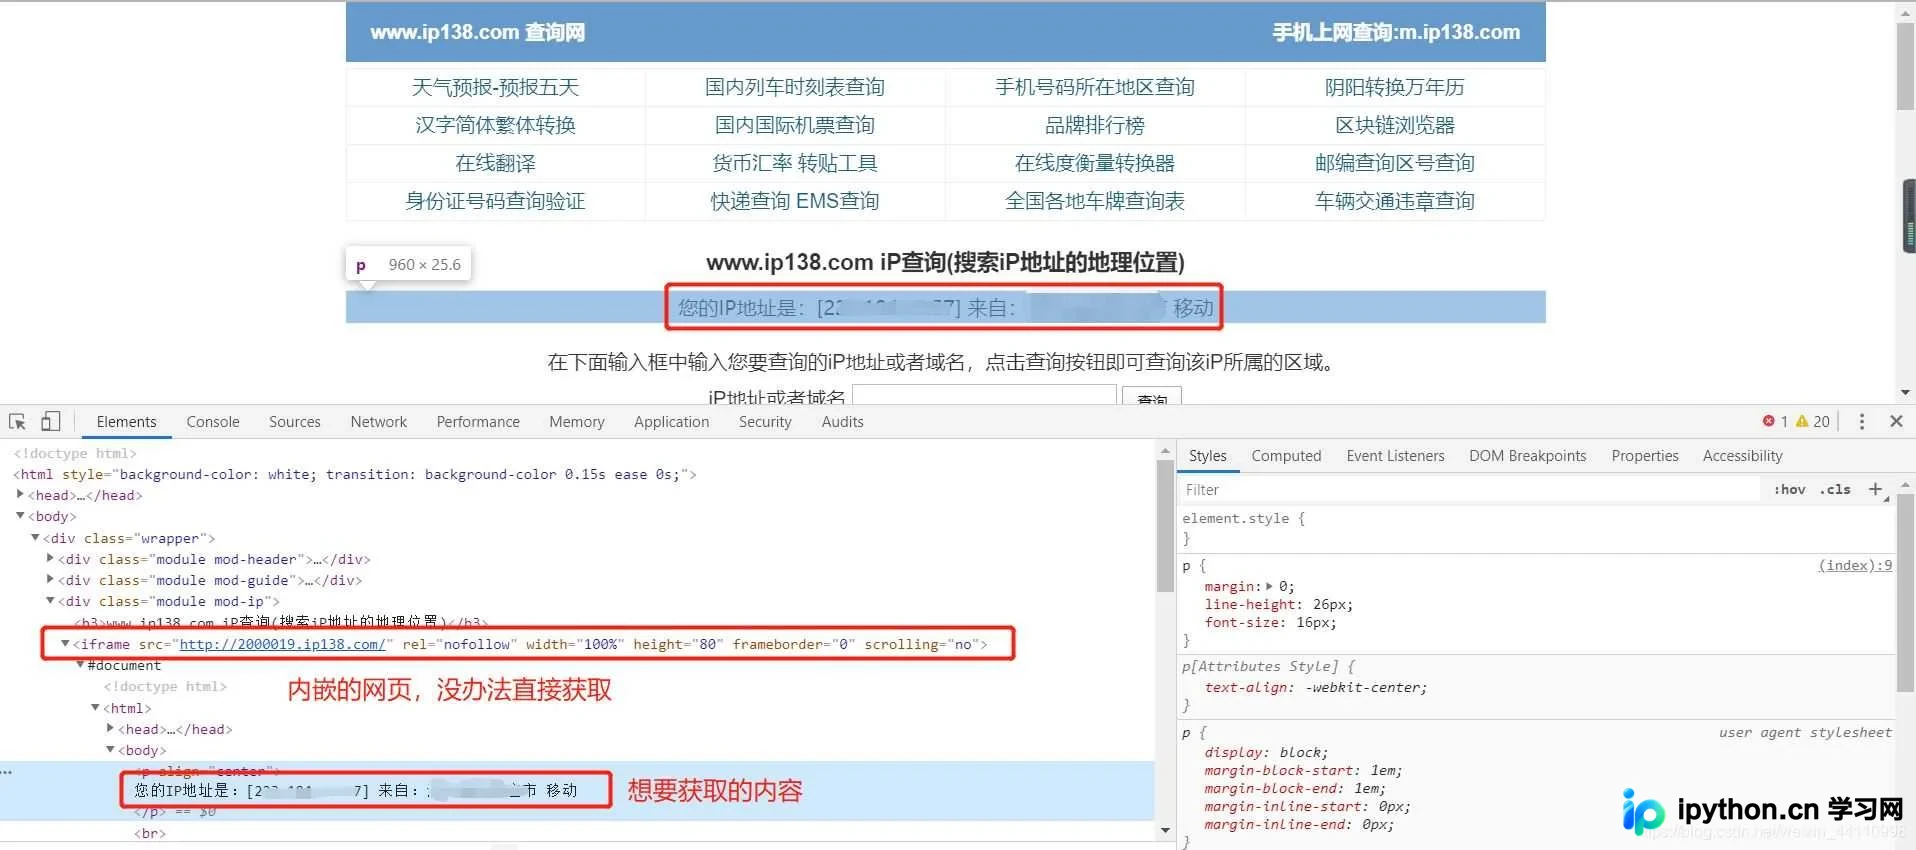
本文介绍在Python Selenium爬虫开发中,如何处理Web页面常见的frame/iframe表单嵌套问题。通过switch_to.frame()方法切换至内嵌页面进行元素定位,并使用switch_to.parent_frame()或default_content()退出嵌套,结合ip138实例代码演示完整操作流程。
本文详细介绍Selenium中ChromeOptions对象的启动参数配置方法。涵盖无界面模式(--headless)、User-Agent设置、窗口尺寸调整及无痕模式等常用选项。同时深入解析如何通过prefs属性禁用图片加载与浏览器通知弹窗,并提供完整的Python代码示例,帮助开发者优化爬虫稳定性与性能。
本文介绍如何利用Python爬虫批量下载Excel中列出的500多个PDF文件。针对Python 3.5环境,修正了旧版代码语法,通过正则表达式匹配特定URL模式,实现自动抓取与保存。
本文详细讲解如何使用Python爬虫获取百度指数数据。针对百度指数接口变更的情况,提供了包含请求头设置、Cookie处理及数据解密逻辑的完整代码示例。通过解析API返回的加密数据,实现关键词搜索量的获取,适用于数据分析及股票趋势观察等场景。
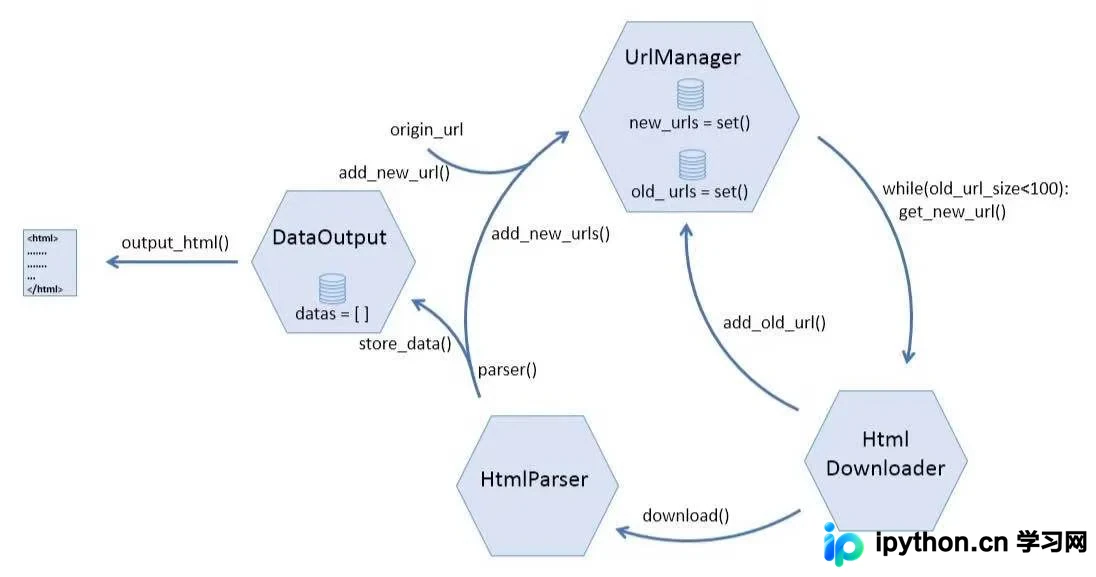
本文详解Python爬虫中URL下载器的实现原理与用法。介绍如何从内置urllib迁移至功能强大的Requests库,通过HtmlDownloader类封装下载逻辑。重点讲解User-Agent伪装、状态码判断及编码处理等关键步骤,帮助开发者构建高效稳定的数据抓取模块。
本文详细介绍Python爬虫中URL管理器的核心功能,重点解析如何利用Python的set()函数实现链接去重。通过对比新旧URL仓库,阐述如何高效识别并过滤重复链接,从而提升爬虫抓取效率。文中提供了完整的UrlManager类代码示例,帮助开发者掌握去重逻辑的具体实现。
本文整理Python爬虫开发中常见的数据采集问题,重点讲解如何通过cookielib模块携带Cookie实现模拟登录以获取受限数据,以及如何处理网站GBK与数据库UTF-8编码不一致导致的乱码问题。通过具体代码示例,提供实用的解决思路与操作代码,帮助开发者避开常见陷阱,提升爬虫稳定性。
本文详解如何在Python爬虫中使用Celery实现定时任务。通过配置Celery Worker与Beat服务,解决爬虫增量抓取及防止Cookie过期等需求。文章涵盖tasks.py配置、Worker重启及Beat启动命令,提供从代码编写到服务运行的完整操作指南,帮助开发者自动化数据获取流程。
本文梳理Python爬虫应对网站反爬措施的实用方法。针对基于知道创宇等安全服务的IP频率限制,通过构造包含User-Agent和Cookie的消息头模拟浏览器行为,利用随机延时(2-5秒)降低请求频率,并结合代理IP池规避IP封禁。旨在帮助开发者建立系统的反爬应对框架,确保数据获取的稳定性与合规性。