

Python爬虫怎么用requests库下载单个文件
本文详细介绍在Python爬虫中使用requests库下载单个文件的完整实现方案。对比小文件直接读取与大文件流式分块下载的内部机制,提供生产级异常处理、防盗链请求头伪装、超时熔断与动态文件名解析示例。
在编写 Python 爬虫时,下载单个文件(如图片、PDF 文档、音频或压缩包)本质上是向目标资源的 URL 发起 HTTP GET 请求,并将服务器返回的二进制数据按原始字节流写入本地磁盘。使用流行的 requests 库,核心区分在于文件的体积:对于几十 KB 到数 MB 的小文件,可以直接获取响应体并整体保存;而对于大文件,则必须开启流式传输(Streaming)分块写入,以防止内存被撑爆。
一、小文件直接写入 vs 大文件流式分块机制
许多初学者直接套用抓取网页 HTML 的习惯,使用 response.text 去接收二进制文件,这往往会导致文件损坏。文本属性 response.text 会尝试根据推测的字符编码对字节进行解码,而图片、压缩包等属于纯二进制字节流,必须使用 response.content 或流式迭代读取。
对于不同体积的目标文件,内存消耗与处理方式有显著差异:
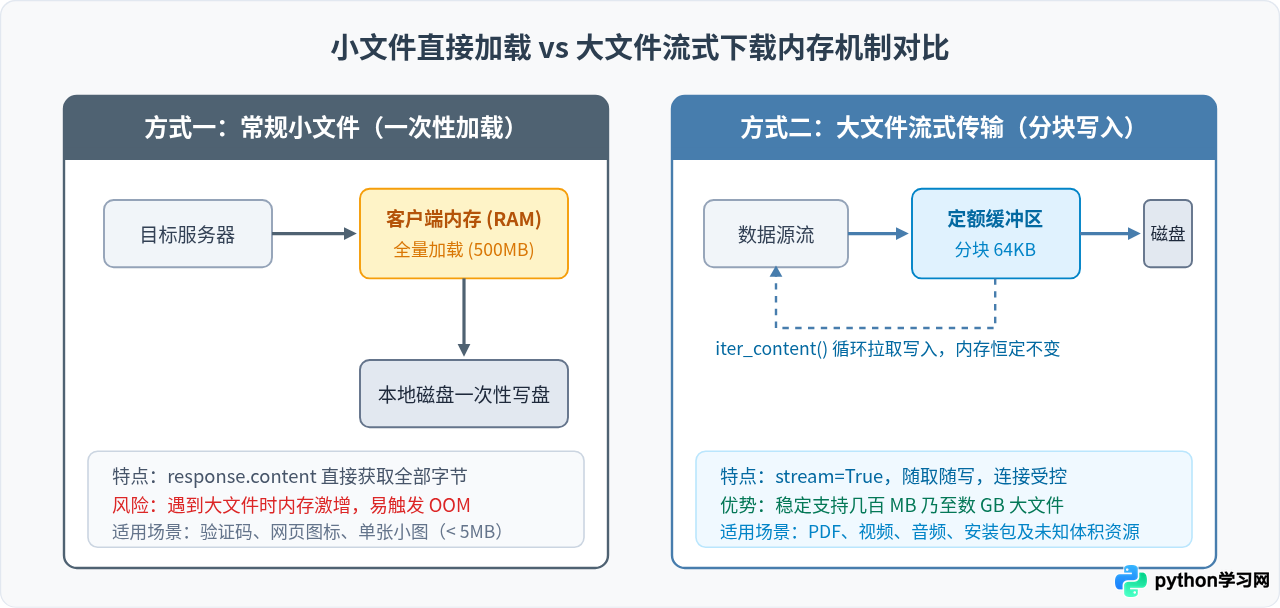
- 小文件直接读取(内存模式):
requests.get()会等待整个响应内容完整传输到客户端的物理内存中。调用response.content拿到完整的bytes对象,再一次性写入磁盘。若文件只有几百 KB,此方式逻辑最简短。 - 大文件流式读取(分块模式):传入参数
stream=True。此时requests仅下载 HTTP 响应头,保持底层 TCP 连接打开,并不会立即将整个文件下载到内存中。通过iter_content()每次仅拉取固定大小的缓冲区(如 64KB),边读边写,内存占用恒定极小。
二、小文件快速下载:直接获取二进制并写入
对于体积较小的静态资源(例如网站图标、头像或验证码),可以直接使用 requests.get() 发起请求,并通过内建的 open() 函数以二进制写入模式("wb")保存。
import requests

url = "https://example.com/images/logo.png"
output_path = "logo.png"

# 设置基础请求头,避免被简单的反爬机制拦截
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

try:
    response = requests.get(url, headers=headers, timeout=10)
    # 检查 HTTP 状态码,如果不是 200 会抛出 HTTPError 异常
    response.raise_for_status()

    # 以二进制写入模式保存文件
    with open(output_path, "wb") as f:
        f.write(response.content)

    print(f"文件已成功保存至: {output_path}")

except requests.exceptions.RequestException as err:
    print(f"下载失败,网络错误: {err}")
避坑提示:必须使用 "wb"(Write Binary)模式打开文件。如果误用 "w" 文本模式,写入 response.content 时 Python 会直接报错 TypeError: a bytes-like object is required, not 'str';若试图通过 f.write(response.text) 强行写入文本,由于换行符转换和字节截断,下载得到的图片或音频文件将无法正常打开。
三、通用稳健方案:流式分块下载(Streaming)
在生产级爬虫中,推荐优先采用流式下载作为通用实现。因为爬虫抓取的远程资源体积往往是动态的,流式下载能够保证不论目标文件是 100KB 还是 5GB,程序的内存占用始终稳定在几十 KB。
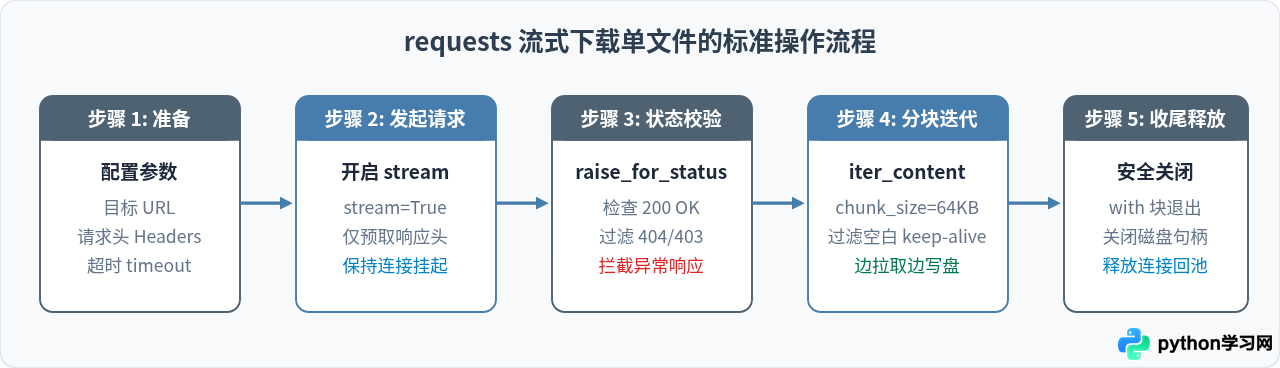
1. 流式下载标准操作步骤
- 在
requests.get()中传入stream=True参数。 - 使用
with上下文管理器包裹响应对象,确保下载完成或异常中断时底层连接被正确释放。 - 调用
response.iter_content(chunk_size=...)遍历二进制分块。 - 过滤掉 Keep-Alive 维持的长连接空数据块(通过
if chunk:判断)。 - 持续追加写入磁盘文件。
2. 流式下载完整代码示例
import os
import requests

def download_file(url: str, save_path: str, chunk_size: int = 64 * 1024) -> bool:
    """
    使用流式传输稳健下载单个文件
    :param url: 文件下载链接
    :param save_path: 本地保存的目标绝对或相对路径
    :param chunk_size: 每次读取的缓冲区大小(默认 64KB)
    :return: 下载成功返回 True,失败返回 False
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    # 确保目标文件夹存在
    folder = os.path.dirname(save_path)
    if folder and not os.path.exists(folder):
        os.makedirs(folder, exist_ok=True)

    # 使用 .tmp 后缀进行临时下载,避免网络中断留下损坏的半截文件
    temp_path = save_path + ".tmp"

    try:
        # 关键点 1: 必须配置 stream=True,设置连接超时与读取超时
        with requests.get(url, headers=headers, stream=True, timeout=(5, 60)) as resp:
            resp.raise_for_status()

            with open(temp_path, "wb") as f:
                # 关键点 2: 循环按块迭代读取写入
                for chunk in resp.iter_content(chunk_size=chunk_size):
                    if chunk:  # 过滤掉保持连接的心跳空块
                        f.write(chunk)

        # 下载成功后重命名为正式文件名
        if os.path.exists(save_path):
            os.remove(save_path)
        os.rename(temp_path, save_path)
        print(f"下载成功: {save_path}")
        return True

    except requests.exceptions.RequestException as e:
        print(f"网络请求异常: {e}")
    except IOError as e:
        print(f"本地文件写入异常: {e}")
    finally:
        # 清理未完成的临时文件
        if os.path.exists(temp_path):
            os.remove(temp_path)

    return False

if __name__ == "__main__":
    target_url = "https://httpbin.org/bytes/1048576"  # 示例 1MB 测试二进制文件
    download_file(target_url, "downloads/sample_data.bin")
四、爬虫实操中的关键细节与防御策略
真实网络环境错综复杂。爬虫下载单个文件时,常常面临防盗链拦截、连接挂死、URL 无后缀名、文件下载残损等隐患。必须在代码层构建全面的防御措施。
1. Referer 防盗链穿透
很多图片或附件服务器(如特定图床、资源站)会验证 HTTP 请求头中的 Referer。如果直接请求文件 URL,服务器发现 Referer 为空或非站内域名,会直接返回 403 Forbidden 错误页面。处理方法是在 headers 中手动指定来源网页的 URL:
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) ...",
    "Referer": "https://example.com/article/12345.html"
}
2. 双超时设置(防止爬虫任务无限挂死)
如果请求时不传 timeout,当服务器由于防火墙或负载过重丢弃 TCP 包时,Python 进程会默认无限期阻塞等待。建议将超时拆分为元组形式:timeout=(5, 30)。前一个数值 5 表示建立连接的最长等待秒数,后一个数值 30 表示两个数据包之间接收的最长等待秒数。
3. 如何从响应头动态提取文件名
很多下载链接是动态生成的(例如 https://example.com/download?id=9872),URL 尾部并不包含文件扩展名。此时可以通过解析服务器返回的 Content-Disposition 响应头来获取实际文件名:
import re
from urllib.parse import unquote

def extract_filename(response, default_name="downloaded_file.bin"):
    cd = response.headers.get("Content-Disposition", "")
    if cd:
        # 匹配 filename="example.pdf" 或 filename=example.pdf
        matches = re.findall(r'filename\*?=(?:UTF-8\'\')?["\']?([^"\';\n]+)["\']?', cd, re.IGNORECASE)
        if matches:
            return unquote(matches[0].strip())

    # 若无 Header,则尝试从 URL 路径截取
    url_path = response.url.split("?")[0].split("/")[-1]
    return url_path if url_path else default_name
五、单文件下载策略决策树与常见问题速查
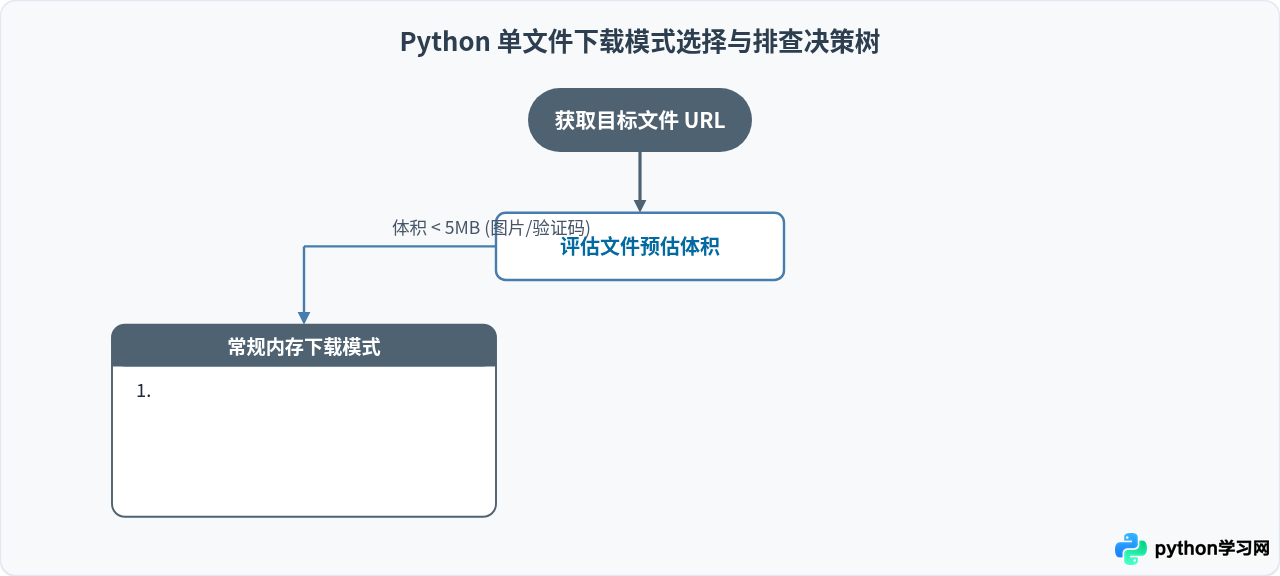
在不同项目和网络环境下,如何快速做出正确的方案选型?以下决策图与速查表可作为实用参考:
常见错误及排查清单
| 常见现象 / 报错 | 核心原因分析 | 具体解决方法 |
|---|---|---|
HTTP 403 Forbidden |
目标服务器配置了 User-Agent 拦截或 Referer 防盗链校验。 | 在请求头中伪装真实的浏览器 User-Agent,并补充宿主网页的 Referer 地址。 |
| 下载的图片/PDF 损坏打不开 | 错误使用了 response.text,或使用 "w" 文本模式写盘导致字节编码失真。 |
严格使用 response.content 或 iter_content,并以 "wb" 二进制模式写入。 |
| 爬虫脚本长时间卡住不动 | 未配置 timeout 参数,遭遇服务器死链或 TCP 丢包时无限阻塞。 |
配置双超时参数,如 timeout=(5, 30)。 |
ChunkedEncodingError |
分块传输期间网络波动导致连接异常中断,数据包接收不完整。 | 结合 try...except 捕获重试,配合 .tmp 临时文件机制防止写入损坏文件。 |
| 爬虫下载多个文件后内存溢出 | 对体积较大的文件直接执行了多次 response.content,导致 RAM 堆积。 |
必须启用 stream=True 配合 iter_content 边读边写,利用 with 及时释放连接。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









