

Python爬虫五步法中常见的编码与异常处理技巧
围绕Python爬虫经典的五步流程,深度剖析网络请求、响应解码、内容解析、数据持久化与流程调度中高频出现的编码陷阱与异常,提供立即可用的代码模式与防御方案。
编写一个在本地几行代码就能跑通的爬虫并不困难,但要让爬虫程序面对成千上万个目标网页持续稳定运行,考验的则是对异常情况的防御能力和对字符编码细节的掌控。爬虫从启动到落盘,本质上由“发送请求、获取响应、解析数据、持久化存储、调度重试”这五个基本环节构成,也就是常说的“爬虫五步法”。在真实的网络环境中,任何一环的疏忽——无论是未捕获的网络断连,还是历史网页中五花八门的文件编码,都可能导致整批任务崩溃或产出毫无价值的乱码数据。本文将严格拆解这五个阶段,逐一剖析最常见的编码与异常痛点,并提供工程中被验证有效的防御模式。
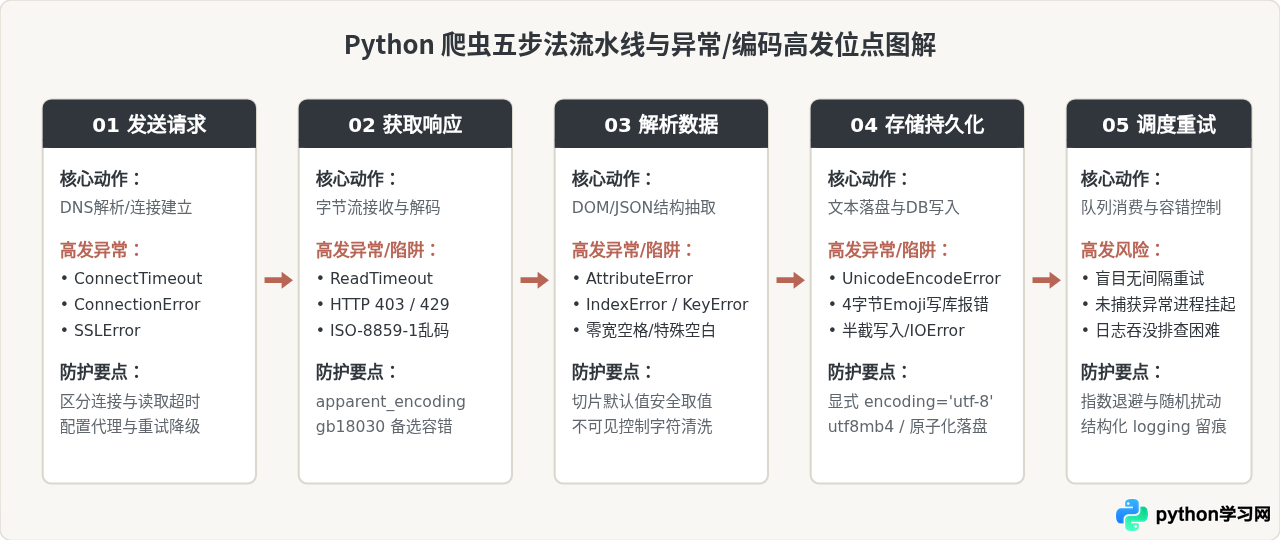
第一步:发送请求阶段的网络异常防御与超时控制
很多爬虫初学者在发送请求时习惯直接调用 requests.get(url),却未显式指定超时参数。在默认情况下,requests 不设置超时时间,若目标服务器由于负载过高未能响应握手,或者网络链路上出现黑洞丢包,爬虫进程将在此处无限期挂起阻塞。更糟糕的是,如果外部调度程序没有强杀机制,整个并发任务队列将迅速被停滞的连接占满。
在网络层,必须区分两类截然不同的超时:连接超时(Connect Timeout)与读取超时(Read Timeout)。连接超时是指客户端与服务器建立 TCP 三次握手所耗费的上限;读取超时则是连接建立后,客户端等待服务器发送第一个字节或相邻两个数据块之间的等待上限。在 requests 中,可以通过传入二元元组 timeout=(5.0, 15.0) 分别指定这两者。
import requests
from requests.exceptions import (
    ConnectTimeout,
    ReadTimeout,
    SSLError,
    ConnectionError,
    RequestException
)

def fetch_url(url: str, headers: dict = None) -> requests.Response:
    # 明确划分连接超时 5 秒,读取超时 15 秒
    timeout_config = (5.0, 15.0)
    try:
        response = requests.get(
            url,
            headers=headers or {"User-Agent": "Mozilla/5.0"},
            timeout=timeout_config
        )
        # 针对 4xx 和 5xx 状态码主动抛出 HTTPError 异常
        response.raise_for_status()
        return response
    except ConnectTimeout:
        # 网络不通、目标端口被防火墙静默拦截
        raise RuntimeError(f"连接目标服务器超时: {url}")
    except ReadTimeout:
        # 服务端已建立连接但未能按时吐出数据,通常是服务端过载
        raise RuntimeError(f"等待服务器返回响应超时: {url}")
    except SSLError as e:
        # 目标站证书过期或中间人代理证书未受信
        raise RuntimeError(f"SSL证书握手失败: {e}")
    except ConnectionError as e:
        # DNS 解析失败、目标主动拒绝连接 (RST)
        raise RuntimeError(f"网络连接建立失败: {e}")
    except RequestException as e:
        # requests 库顶级异常兜底
raise RuntimeError(f"请求发生未预期异常: {e}")在异常处理策略中,应当遵循粒度由细到粗的捕获顺序。RequestException 是 requests 库所有网络异常的基类,必须放在最后兜底;如果将其置于顶部,特定子异常的处理分支将永远不会被触发。此外,调用 response.raise_for_status() 可以把 HTTP 404、403、500 等协议层错误统一转换为可捕获的 HTTPError,避免带有错误信息的响应体被当成正常数据流入后续解析。
第二步:获取响应阶段的字符编码识别与乱码根治
当网络请求成功返回后,爬虫进入第二步:从原始字节流(response.content)还原出可读的文本字符串(response.text)。这也是乱码问题频发的主战场。许多开发者发现抓取国内某些政企或论坛网站时,中文全变成问号(???)或“锟斤拷”、“烫烫烫”等字符,根本原因在于错误信任了 HTTP 响应头中的字符集声明。
根据 HTTP/1.1 规范(RFC 2616),如果服务端返回的 Content-Type 标头为 text/html 且未明确声明 charset 参数,HTTP 客户端默认应当将其视为 ISO-8859-1(即 Latin-1)。requests 严格遵循了该历史规范。然而,中文网页实际上多采用 UTF-8 或 GBK / GB2312 / GB18030 编码,如果强行用单字节的 ISO-8859-1 进行映射,就会引发灾难性的乱码。
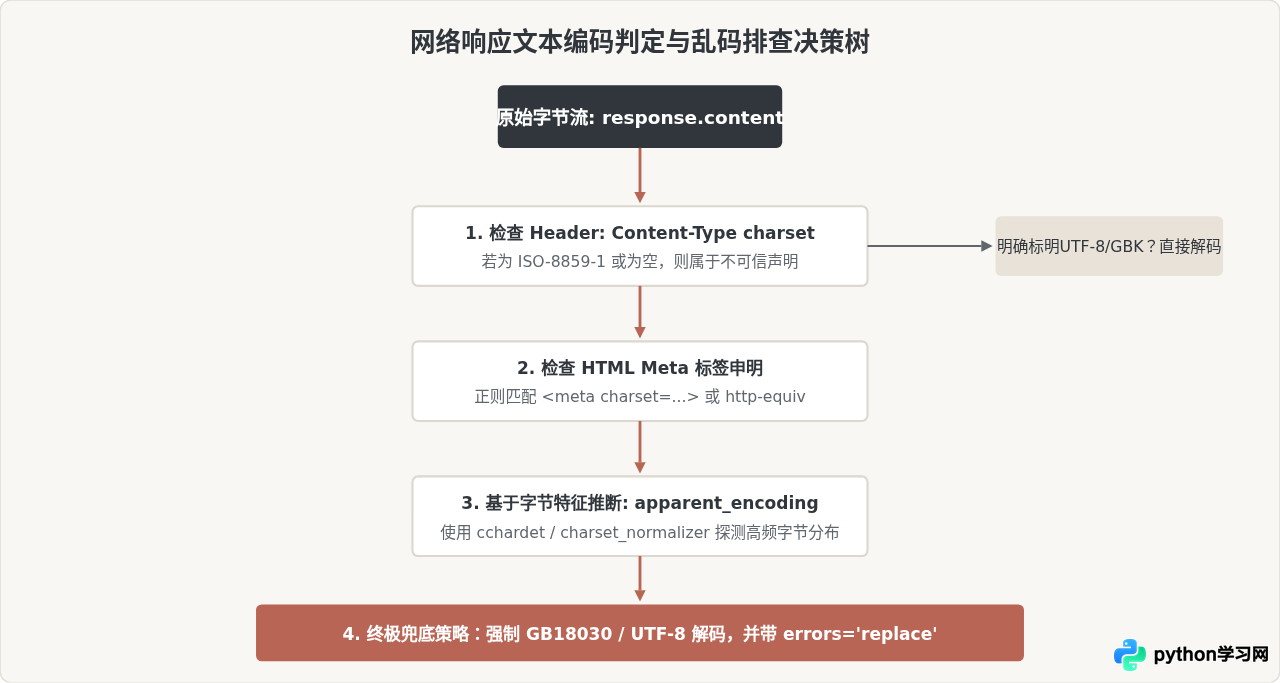
为了彻底解决响应乱码,应当建立一套按优先级递进的解码策略:
- 优先检查有效的 Header 声明:如果 Header 中的
charset明确存在且不属于ISO-8859-1,则直接采纳。 - 解析 HTML 头部 Meta 标签:部分旧系统网页由服务端模板直接吐出,Header 缺失但 HTML 内部包含
<meta charset="gb2312">。 - 利用
response.apparent_encoding统计推断:requests内部依赖字符探针库对原始字节流进行统计学分析。如果推断出的编码为GB2312或GBK,在 Python 中强烈建议直接统一替换为GB18030。因为GB18030是中国国家标准的超集,完全兼容GB2312与GBK,且收录了生僻字和少数民族字符,能有效防止因少量罕见字触发UnicodeDecodeError。 - 带容错策略的手动字节解码:在遭遇严重损坏的文本时,直接调用
response.content.decode('utf-8', errors='replace'),避免进程直接因坏字节抛出异常中断。
import re
import requests

def safe_decode_response(response: requests.Response) -> str:
    raw_bytes = response.content
    if not raw_bytes:
        return ""

    # 1. 如果 requests 自带识别不是默认的 ISO-8859-1,先尝试
    encoding = response.encoding
    if encoding and encoding.lower() != "iso-8859-1":
        try:
            return raw_bytes.decode(encoding)
        except (UnicodeDecodeError, LookupError):
            pass

    # 2. 检查 HTML 内容中的 meta 标签
    # 截取前 2048 字节通常足以涵盖全部 head 标签
    head_prefix = raw_bytes[:2048].decode("ascii", errors="ignore")
    meta_match = re.search(r'charset=["\']?([a-zA-Z0-9_\-]+)', head_prefix, re.I)
    if meta_match:
        meta_encoding = meta_match.group(1).lower()
        if meta_encoding in ("gb2312", "gbk"):
            meta_encoding = "gb18030"
        try:
            return raw_bytes.decode(meta_encoding)
        except (UnicodeDecodeError, LookupError):
            pass

    # 3. 使用 apparent_encoding 探测
    detected = response.apparent_encoding
    if detected:
        if detected.lower() in ("gb2312", "gbk"):
            detected = "gb18030"
        try:
            return raw_bytes.decode(detected)
        except (UnicodeDecodeError, LookupError):
            pass

    # 4. 终极容错方案:优先尝试 utf-8,其次 gb18030,最后用 replace 替换坏字节
    for enc in ("utf-8", "gb18030"):
        try:
            return raw_bytes.decode(enc)
        except UnicodeDecodeError:
            continue

    return raw_bytes.decode("utf-8", errors="replace")
第三步:解析提取阶段的结构变动与脏数据异常控制
当获取到干净的纯文本后,第三步通常使用 lxml、BeautifulSoup 或 json 模块抽取关键字段。该阶段引发异常的核心原因是“目标页面结构的不确定性”。在批量抓取中,目标站点可能存在部分文章没有作者、商品没有折扣标签、反爬机制注入假节点,或者页面完全是空白等情况。
直接访问列表首个元素 elements[0] 容易抛出 IndexError;直接调用 node.text 会在 node 为 None 时触发 AttributeError;直接用字典中括号取值 data['price'] 会在缺失字段时触发 KeyError。编写解析代码必须秉持防御式编程的原则:
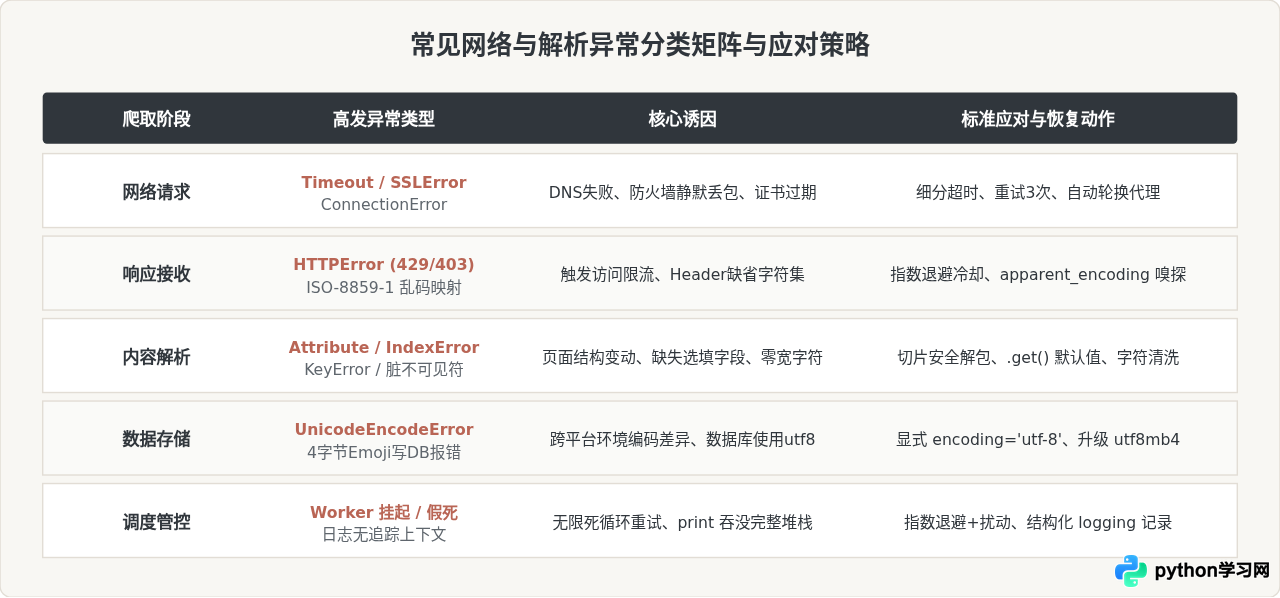
除了结构性异常外,提取阶段还需要注意字符层面的“隐形脏数据”。网页中常常混入不间断空格( 对应的 \xa0)、零宽连字符(\u200b、\ufeff)以及全角空格(\u3000)。这些字符在普通的肉眼观察中无法分辨,但在按分隔符切分字段、比对关键字或计算哈希值时,会导致逻辑完全失灵。
import unicodedata
from bs4 import BeautifulSoup

def clean_invisible_characters(text: str) -> str:
    if not text:
        return ""
    # 将兼容格式的字符规范化(如将不间断空格 \xa0 转换为标准空格)
    normalized = unicodedata.normalize("NFKC", text)
    # 剔除零宽空格及不可见控制字符
    cleaned = "".join(
        ch for ch in normalized
        if ch not in ("\u200b", "\u200c", "\u200d", "\ufeff")
    )
    return cleaned.strip()

def parse_item(html_content: str) -> dict:
    soup = BeautifulSoup(html_content, "lxml")

    # 技巧 1:利用切片解包防范 IndexError
    title_nodes = soup.select("h1.post-title")
    title = clean_invisible_characters(title_nodes[0].get_text()) if title_nodes else "未知标题"

    # 技巧 2:链式判断节点,避免 'NoneType' has no attribute 'get_text'
    price_node = soup.select_one("span.goods-price")
    price = clean_invisible_characters(price_node.get_text()) if price_node is not None else "0.00"

    return {
        "title": title,
        "price": price
    }
第四步:数据持久化阶段的文件与数据库编码陷阱
数据清洗完毕后,进入第四步持久化。很多开发者在 macOS 或 Linux 上调试爬虫一切正常,但将代码部署到 Windows 服务器或提供给同事运行后,瞬间抛出 UnicodeEncodeError: 'gbk' codec can't encode character...。这是因为在 Python 3 中,调用 open(filename, 'w') 若未指定 encoding 参数,系统会自动使用操作系统的默认本地编码(Windows 中文版通常是 cp936/GBK)。一旦抓取的数据包含生僻字、特殊标点或 Emoji 表情符号,GBK 码表中由于没有对应的映射点,就会立刻引发编码错误导致任务中断。
- 强制显式声明 UTF-8:任何文件读写必须显式传入
encoding="utf-8"。 - 序列化 JSON 禁止 ASCII 转义:使用
json.dump(..., ensure_ascii=False),避免将中文转义为\u4e2d\u6587这种膨胀格式,保证文本直观可读且体积紧凑。 - MySQL 数据库必须配置 utf8mb4:MySQL 原生的
utf8编码仅支持最多 3 字节的 Unicode,一旦抓取到 4 字节的 Emoji 表情或特殊符号,数据库驱动会直接报错Incorrect string value。数据表与连接字符集必须一律升级为utf8mb4。
import json
import os
import tempfile

def atomic_save_json(data: list, target_file_path: str):
    """
    采用原子写入模式保存数据:
    先完整写入同目录下的临时文件,成功后再原子替换目标文件。
    避免爬虫在写入过程中异常终止导致目标文件损毁成残缺的半截JSON。
    """
    dir_name = os.path.dirname(target_file_path) or "."
    os.makedirs(dir_name, exist_ok=True)

    temp_fd, temp_path = tempfile.mkstemp(dir=dir_name, prefix=".tmp_crawl_")
    try:
        with os.fdopen(temp_fd, "w", encoding="utf-8") as f:
            # ensure_ascii=False 保留原始中文字符,缩进排版保持可读性
            json.dump(data, f, ensure_ascii=False, indent=2)
        # 原子替换,确保目标文件始终处于完整有效状态
        os.replace(temp_path, target_file_path)
    except (IOError, OSError) as e:
        if os.path.exists(temp_path):
            os.remove(temp_path)
        raise RuntimeError(f"数据持久化失败: {e}")
第五步:调度重试阶段的退避算法与可观测性
爬虫五步法的最后一步是调度控制:当某一任务在前面的四个步骤中遭遇偶发异常时,系统该如何响应?
简单粗暴的死循环 while True: try... except... 会给目标服务器造成雪崩式打击,并导致本机 IP 被瞬间封禁;而放任不管则会造成大量数据空缺。健壮的爬虫调度应具备指数退避(Exponential Backoff)与随机抖动(Jitter)机制。重试等待时间随着失败次数指数级递增(例如 1s, 2s, 4s, 8s...),并加上一定范围的随机浮动,打散同一批次任务重试对服务端的脉冲压力。
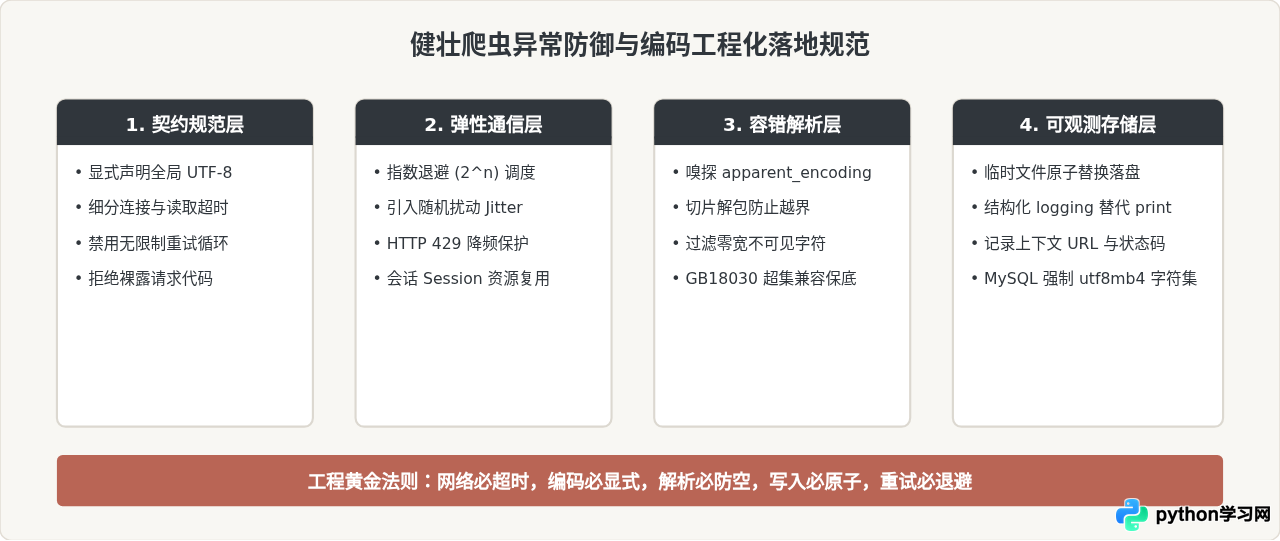
同时,在工程化项目中,坚决弃用简单的 print 打印。必须使用 Python 标准库 logging,不仅能够区分 DEBUG、INFO、WARNING、ERROR 级别,还能通过 logger.exception() 自动记录完整的 Traceback 调用栈和报错现场变量,为后续的排错提供确凿的日志凭据。
import time
import random
import logging
from functools import wraps

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] [%(name)s] %(message)s"
)
logger = logging.getLogger("CrawlerEngine")

def retry_with_backoff(max_retries: int = 3, base_delay: float = 1.5, max_delay: float = 20.0):
    """
    通用网络请求重试装饰器:支持指数退避与随机抖动
    """
    def decorator(func):
        @wraps(func)
        def wrapper(*args, **kwargs):
            attempt = 0
            while attempt < max_retries:
                try:
                    return func(*args, **kwargs)
                except Exception as exc:
                    attempt += 1
                    if attempt >= max_retries:
                        logger.error(f"函数 {func.__name__} 达到最大重试次数 ({max_retries}),任务彻底失败。原因: {exc}")
                        raise

                    # 计算退避时间: base_delay * (2 ^ attempt) + 随机抖动
                    delay = min(base_delay * (2 ** (attempt - 1)), max_delay)
                    jitter = random.uniform(0.1, 0.8)
                    sleep_time = delay + jitter

                    logger.warning(
                        f"第 {attempt} 次执行失败: {exc},将在 {sleep_time:.2f} 秒后重试 (URL: {args[0] if args else '未知'})..."
                    )
                    time.sleep(sleep_time)
        return wrapper
    return decorator
总结与自查清单
排查爬虫故障的本质,就是沿着这五步流水线定位“异常是在哪一步被丢弃的,编码是在哪一步发生错位的”。在将爬虫投入实际批处理前,可以通过以下清单快速自检:
- 请求环节:是否为每个
requests调用传入了显式的timeout=(connect, read)元组?是否捕获了顶级RequestException? - 响应环节:是否避免了直接相信
response.text?是否配置了apparent_encoding或GB18030优先策略? - 解析环节:所有从页面选择出的元素集合在取
[0]时是否有切片或长度判定?提取的字符串是否经过零宽不可见字符的过滤? - 存储环节:本地文件保存是否显式指定
encoding='utf-8'?数据库表与连接字符集是否为utf8mb4?落盘过程是否采用原子替换防止断电残缺? - 调度环节:重试逻辑是否具备指数退避与抖动机制?关键错误是否由
logging完整记录了时间、URL 与堆栈追踪?
将上述技巧固化为项目的统一基础模块,能够将因网络抖动和字符编码引发的突发故障降低 90% 以上,为后续的大规模抓取奠定可靠的基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









