

Python爬虫headers处理及网络超时问题解决方案
本文详解Python爬虫中常见的403禁止访问及网络超时问题。通过模拟浏览器User-Agent解决反爬限制,利用requests模块设置timeout参数处理超时,并演示如何捕获ReadTimeout、HTTPError等具体异常类,提升爬虫稳定性。
2026-10-14
4

本文详解Python爬虫中常见的403禁止访问及网络超时问题。通过模拟浏览器User-Agent解决反爬限制,利用requests模块设置timeout参数处理超时,并演示如何捕获ReadTimeout、HTTPError等具体异常类,提升爬虫稳定性。
本文详解Python爬虫可获取的数据类型,涵盖电商、房产、招聘及社交平台案例。针对初学者常遇的学习误区,提供从基础包使用到分布式爬虫的六步平滑学习路径,帮助零基础上手高效采集数据。
本文针对Windows任务计划频繁挂起的问题,探讨Python爬虫定时任务的实现方案。首先分析基于while True死循环的简单实现及其在复杂场景下的局限性,如多任务并发、网络稳定性及异常处理等。文章指出该方法适用于低频单次执行场景,后续将介绍更稳健的定时任务解决方案,帮助开发者优化爬虫调度策略。
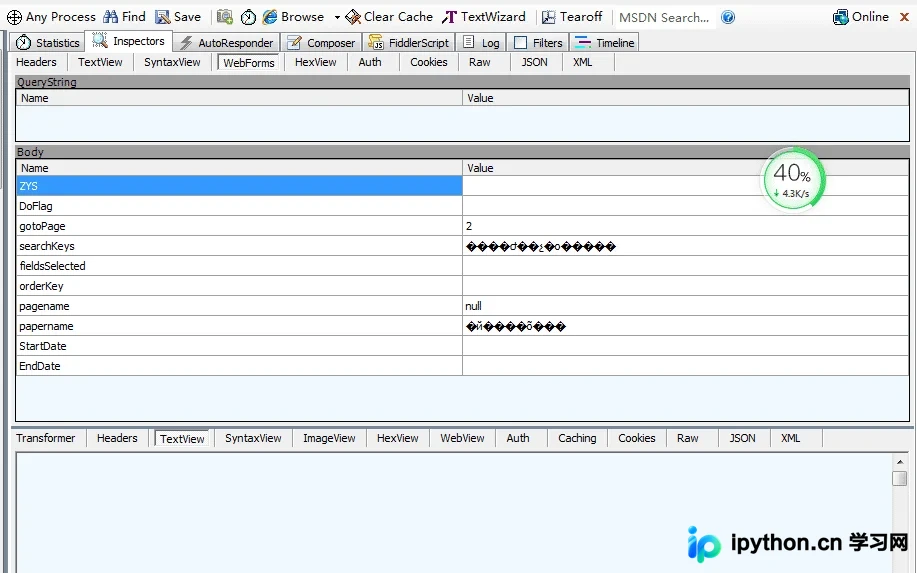
本文解析Python爬虫抓取网站时遇到的URL参数乱码问题。通过示例展示如何将中文字符串按GBK2312编码后进行百分号编码,利用urllib.quote函数生成符合要求的URL参数格式,帮助开发者解决中文请求参数乱码困扰。
本文介绍如何使用Python网络爬虫结合BeautifulSoup库,从绿色呼吸网实时采集天气与空气质量数据。教程涵盖目标网站分析、网页源码定位、关键代码实现及异常处理机制,重点解决部分城市无污染物数据显示时的空值问题。通过PyCharm运行程序,用户可输入城市拼音获取实时AQI、首要污染物及温馨提示,实现便捷的天气信息监控。
本文介绍利用Python编写爬虫程序以提取百度搜索结果的完整代码实例。通过配置User-Agent池防止IP限制,使用urllib2库发起请求并解析HTML返回链接与标题。该示例展示了基础的网页抓取流程,适用于学习Python网络编程及数据提取技术,供开发者参考实现。
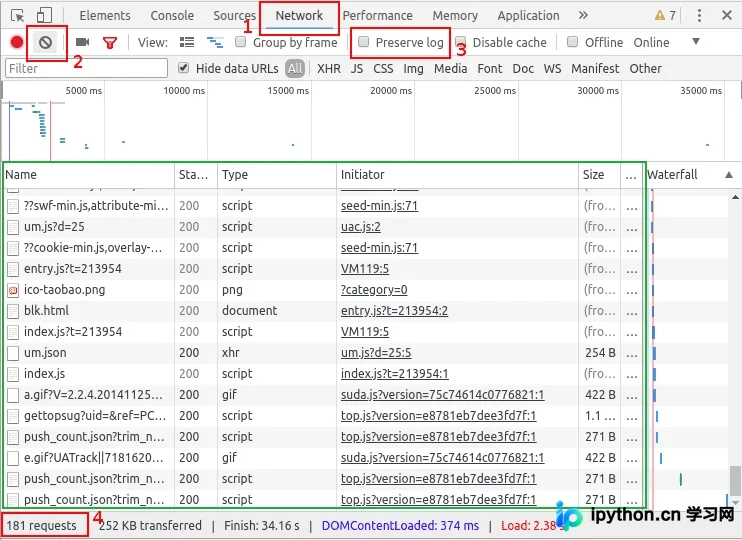
本文详解Python爬虫中Chrome浏览器F12开发者工具的使用。针对网页HTML源码中缺失但页面可见的数据,解析Ajax异步加载原理。通过Network面板筛选请求,利用Headers重建HTTP请求,结合Preview和Response获取目标数据,帮助开发者高效编写爬虫脚本。
本文详解如何使用Python的urllib库爬取网页,并结合BeautifulSoup解析HTML以提取所有URL链接。通过实例代码展示如何遍历a标签、处理相对路径及验证链接有效性,帮助开发者快速掌握网页数据抓取的核心技巧。
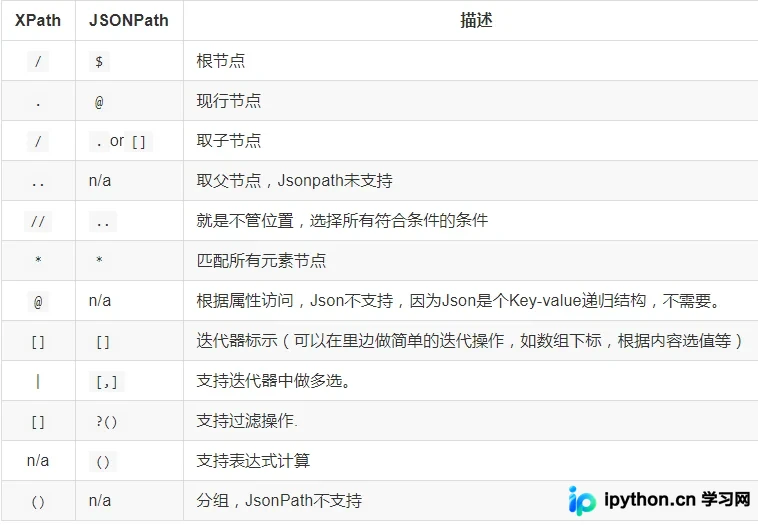
本文详解Python中JSON数据格式及JSONPath信息抽取工具。通过对比JSONPath与XPath语法,展示如何利用jsonpath库从拉勾网和城市数据中提取信息,并结合lxml处理糗事百科HTML内容。文章提供完整代码示例,涵盖JSON字符串转换、列表提取及文件保存操作,帮助开发者掌握Web数据抓取核心技巧。
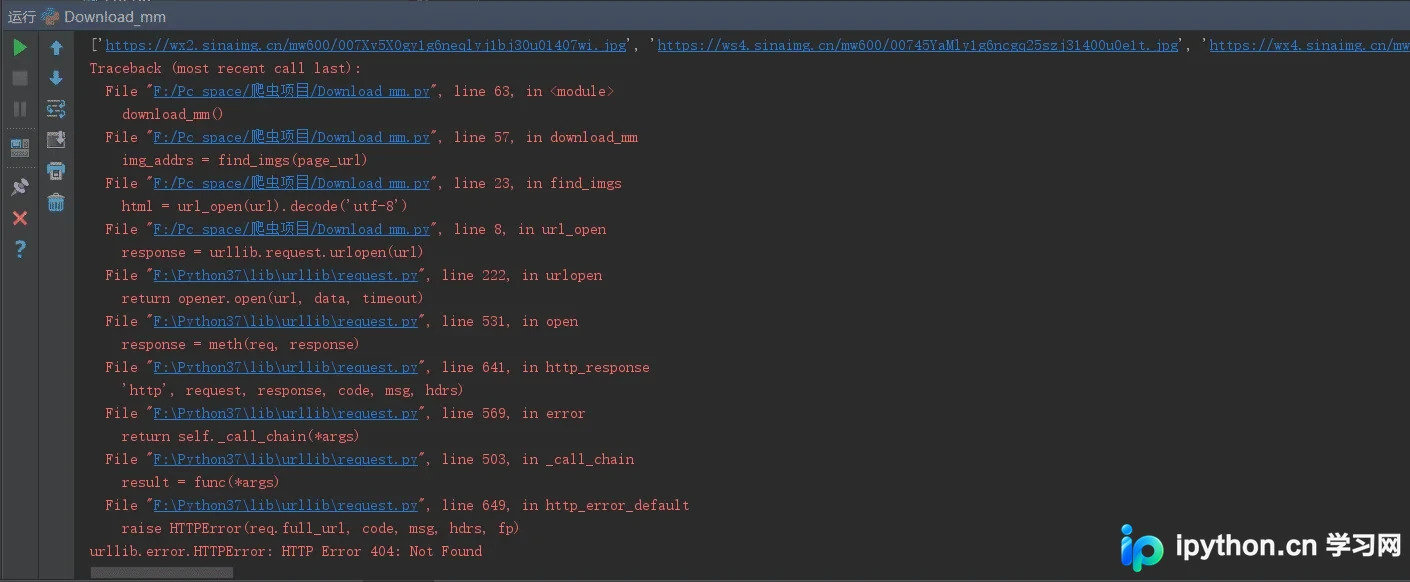
本文详解使用Python爬取煎蛋网图片的完整流程,涵盖urllib.request与os库的应用。重点分析因网页结构变化导致的404错误,通过对比前5面与后5面URL格式差异,定位find()函数匹配失效原因,并提出使用正则或BeautifulSoup优化的建议,帮助开发者规避常见抓取陷阱。
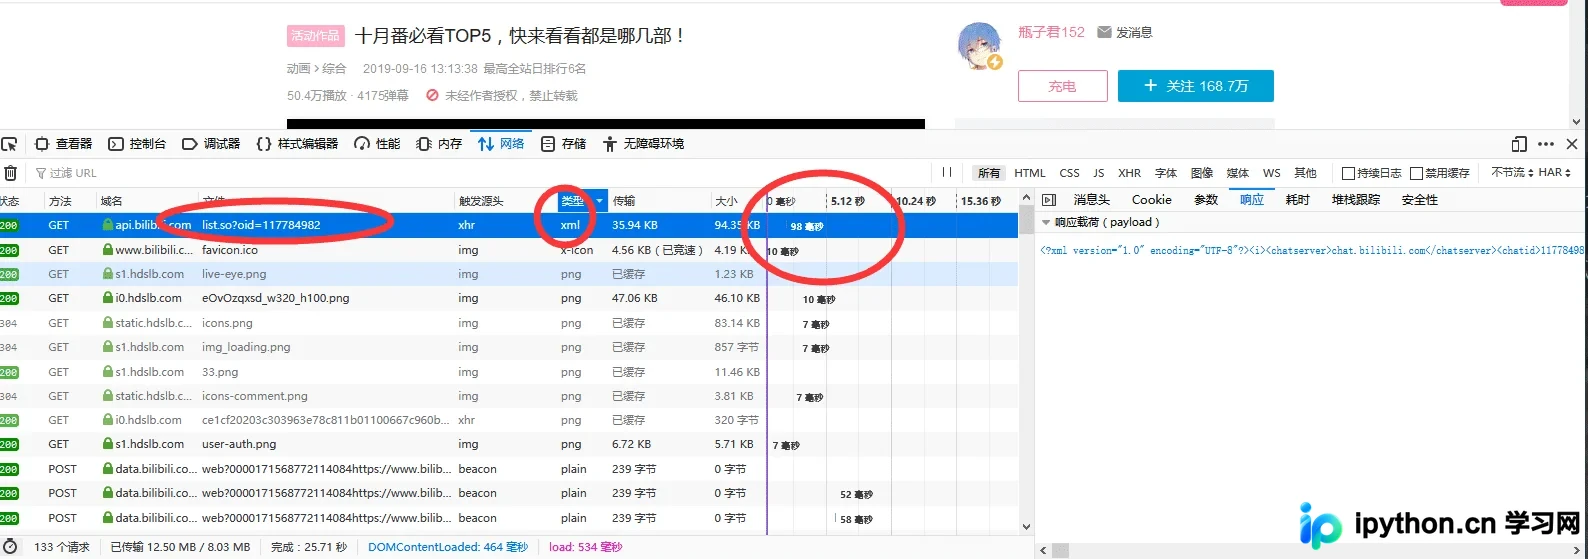
本文解析使用Python抓取B站弹幕的技术流程。针对B站数据异步加载特性,通过浏览器开发者工具定位包含oid的XML请求接口。利用正则表达式从视频页面解析cid和aid,构造API请求获取弹幕文件。文章提供完整代码示例,展示如何从视频链接到最终获取弹幕数据的完整步骤。
本文详解如何使用Python抓取猫眼电影TOP100榜单及电影天堂数据,涵盖静态页面分析、正则表达式提取、User-Agent随机切换及编码处理技巧。重点演示将爬取数据持久化存储至本地CSV文件、MySQL数据库(使用pymysql及executemany批量插入)及MongoDB的具体实现,并提供完整的代码框架与SQL查询示例。