

使用Scrapy框架构建大型Python爬虫项目:结构、Item与Pipeline
深入解析如何基于Scrapy框架构建高可用、易扩展的大型Python爬虫工程,重点剖析多爬虫工程分层结构、Item规范与清洗机制,以及Pipeline管道链设计与批量持久化策略。
构建大规模数据采集系统时,随意堆砌脚本不仅会导致逻辑失控,更会在站点规则变动或吞吐量激增时引发维护灾难。本文针对大型Python爬虫项目的工程化需求,直接围绕工程目录分层规范、Item与ItemLoader数据清洗契约、以及多阶段流水线Pipeline架构三个核心支柱展开,提供一套解耦清晰、可水平扩容且具备高容错能力的Scrapy项目架构设计方案。
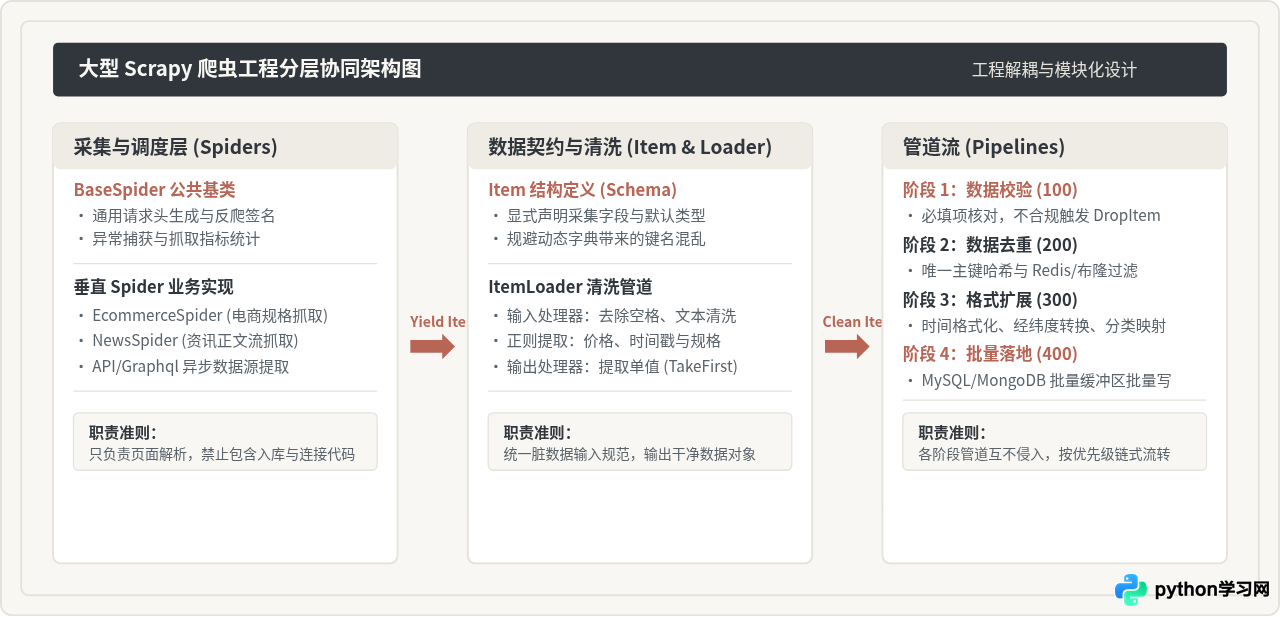
一、大型Scrapy项目的分层架构与目录组织
大型爬虫工程往往需要支撑数十甚至上百个目标站点的抓取任务。传统的单一项目结构容易将业务解析逻辑、网络请求配置、数据处理与底层入库杂糅在一起。为了实现高内聚低耦合,项目必须在工程目录层级进行明确的职责切分。
通常,一个具备扩展性的大型Scrapy工程会包含通用的爬虫基类(用于统一反爬应对、重试信号和通用请求头封装)、统一的Item模型定义、可重用的字段清洗加载器,以及按数据处理阶段串联的管道集合。
推荐的项目工程目录结构
large_crawler_project/
├── scrapy.cfg                   # 部署配置文件
└── crawler_core/                # 核心项目主模块
    ├── __init__.py
    ├── settings/                # 配置拆分:基础配置、测试环境与生产环境
    │   ├── __init__.py
    │   ├── base.py
    │   └── production.py
    ├── common/                  # 通用工具基类与组件
    │   ├── __init__.py
    │   ├── base_spider.py       # 封装公共生命周期与辅助解析的基类
    │   └── proxies.py           # 动态代理轮询与熔断管理
    ├── spiders/                 # 爬虫分类存放(按业务或站点归属)
    │   ├── __init__.py
    │   ├── ecommerce/           # 电商类目标爬虫集
    │   │   ├── jd_goods.py
    │   │   └── tmall_goods.py
    │   └── news/                # 资讯类目标爬虫集
    │       └── sina_news.py
    ├── items/                   # 明确的数据模型契约
    │   ├── __init__.py
    │   ├── ecommerce_items.py
    │   └── news_items.py
    ├── loaders/                 # 字段处理器与清洗管道
    │   ├── __init__.py
    │   └── item_loaders.py
    ├── pipelines/               # 链式处理管道
    │   ├── __init__.py
    │   ├── validation.py        # 字段完备性与合法性校验
    │   ├── deduplication.py     # 基于指纹与布隆过滤的去重
    │   └── storage.py           # 批量异步入库(MySQL/MongoDB)
    └── middlewares/             # 请求与响应拦截层
        ├── __init__.py
        ├── downloader.py
        └── spider.py
在该结构中,spiders/ 内部只专注于网络遍历与结构化选择提取,严格杜绝直接在Spider中编写数据库插入或文件写入代码。所有的持久化和清洗操作全部下沉至 loaders/ 与 pipelines/。
二、Item与ItemLoader:规范数据契约与清洗
在小型爬虫中,开发者习惯直接在解析函数中使用 Python 原生字典(dict)产出数据。这种做法在大型团队和多爬虫项目中会带来极高的隐患:不同爬虫产出的字段名称不统一(例如有的叫 price,有的叫 item_price)、缺失字段无法自省、类型无法约束。
Scrapy 的 Item 提供了类似模型类(Model)的字段契约,而 ItemLoader 提供了将原始脏字符串统一加工为规范字段的流水线机制。
1. 声明清晰的 Item 契约
继承 scrapy.Item 并使用 Field() 声明所有允许的键。未声明的键在赋值时会直接触发 KeyError,在爬虫运行期即可暴露出解析错误。
items/ecommerce_items.py
import scrapy

class ProductItem(scrapy.Item):
    sku_id = scrapy.Field()       # 商品唯一ID(字符串)
    title = scrapy.Field()        # 商品标题(清洗后的纯文本)
    price = scrapy.Field()        # 现价(浮点数)
    origin_price = scrapy.Field() # 原价(浮点数)
    category = scrapy.Field()     # 分类列表
    image_urls = scrapy.Field()   # 主图列表
    crawl_time = scrapy.Field()   # 抓取时间戳
2. 使用 ItemLoader 进行输入/输出解耦清洗
Scrapy 推荐使用 ItemLoader,结合 MapCompose(用于输入阶段的链式处理)和 TakeFirst(用于输出阶段提取第一个元素)将清洗逻辑从 Spider 中彻底抽离。
loaders/item_loaders.py
import re
from itemloaders.processors import TakeFirst, MapCompose, Identity
from scrapy.loader import ItemLoader

def strip_text(value):
    return value.strip() if isinstance(value, str) else value

def parse_price(value):
    if not value:
        return 0.0
    match = re.search(r'(\d+(?:\.\d+)?)', str(value))
    return float(match.group(1)) if match else 0.0

class ProductLoader(ItemLoader):
    # 默认输出提取器:单值字段直接取首个元素
    default_output_processor = TakeFirst()

    # sku_id 清洗
    sku_id_in = MapCompose(strip_text, str)

    # 标题清洗:去首尾空字符、过滤换行符
    title_in = MapCompose(strip_text, lambda x: x.replace('\n', ' ').strip())

    # 价格清洗:正则提取数字并转换为 float
    price_in = MapCompose(parse_price)
    origin_price_in = MapCompose(parse_price)

    # 图片列表:保留多值列表,不使用 TakeFirst
    image_urls_out = Identity()
在爬虫中调用时,代码变得极其简明和高可读:
def parse_detail(self, response):
    loader = ProductLoader(item=ProductItem(), response=response)
    loader.add_xpath('sku_id', '//div[@id="sku"]/@data-id')
    loader.add_css('title', 'h1.product-title::text')
    loader.add_css('price', 'span.price-tag::text')
    loader.add_xpath('image_urls', '//div[@class="gallery"]//img/@src')
    yield loader.load_item()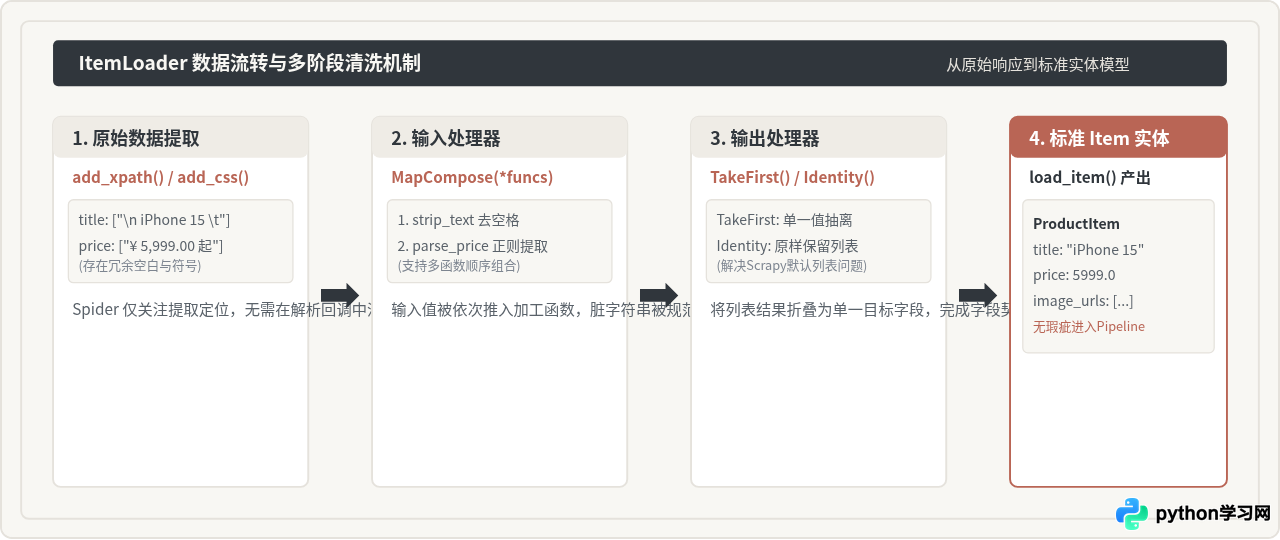
三、Pipeline 架构体系:校验、去重与批量入库
Item Pipeline 是数据离开 Spider 后的唯一集中处理枢纽。在大型项目中,绝对不要把所有存储和逻辑写在一个几十行的 process_item 方法中。Pipeline 应该被拆分为单功能管道,依靠 Scrapy 提供的优先级机制(权重数值越小,执行越早)构成职责清晰的处理流水线。
1. 阶段一:数据合法性校验管道
校验管道承担防守任务,确保进入后续入库逻辑的数据必须包含关键主键与基础合法性。如果不符合要求,使用 DropItem 抛出异常,Scrapy 会自动中断该数据在后续管道中的传递并记录统计。
pipelines/validation.py
from scrapy.exceptions import DropItem

class ValidationPipeline:
    def process_item(self, item, spider):
        # 必须具备核心主键
        if not item.get('sku_id'):
            raise DropItem(f"[{spider.name}] 丢弃缺失主键 sku_id 的 Item: {item}")

        # 检查价格合理性(防止页面结构变化导致的抓取漂移)
        price = item.get('price', 0.0)
        if price <= 0:
            raise DropItem(f"[{spider.name}] 丢弃异常价格 (price={price}): sku={item.get('sku_id')}")

        return item
2. 阶段二:指纹生成与去重过滤管道
在全网抓取或增量监控中,多个页面可能引用同一数据项。去重管道通过构造数据的唯一指纹(如对关键字段计算 SHA256)并在 Redis 或本地布隆过滤器(BloomFilter)中核对,过滤掉已经入库的冗余条目。
pipelines/deduplication.py
import hashlib
from scrapy.exceptions import DropItem

class DeduplicationPipeline:
    def __init__(self):
        self.seen_fingerprints = set()

    def process_item(self, item, spider):
        # 组合唯一字段生成指纹
        unique_string = f"{item['sku_id']}_{spider.name}"
        fingerprint = hashlib.sha256(unique_string.encode('utf-8')).hexdigest()

        if fingerprint in self.seen_fingerprints:
            raise DropItem(f"[{spider.name}] 发现重复 Item (指纹: {fingerprint[:8]}...)")

        self.seen_fingerprints.add(fingerprint)
        # 将指纹追加到 item 中方便存储
        item['fingerprint'] = fingerprint
        return item
3. 阶段三:高性能批量写入与连接池管理
大型项目中最忌讳在 process_item 中每来一条数据就执行一次 INSERT 操作。频繁的网络交互会导致数据库连接池耗尽,拖垮爬虫整体吞吐量。正确的实践是:利用 open_spider 初始化持久连接,在内存中维护固定大小的批处理缓冲区,达到阈值时批量落地,并在 close_spider 中清空剩余缓存。
pipelines/storage.py
from pymongo import MongoClient, UpdateOne

class MongoBatchPipeline:
    def __init__(self, mongo_uri, mongo_db, batch_size=500):
        self.mongo_uri = mongo_uri
        self.mongo_db = mongo_db
        self.batch_size = batch_size
        self.items_buffer = []

    @classmethod
    def from_crawler(cls, crawler):
        return cls(
            mongo_uri=crawler.settings.get('MONGO_URI', 'mongodb://localhost:27017'),
            mongo_db=crawler.settings.get('MONGO_DATABASE', 'crawler_storage'),
            batch_size=crawler.settings.getint('MONGO_BATCH_SIZE', 500)
        )

    def open_spider(self, spider):
        self.client = MongoClient(self.mongo_uri)
        self.db = self.client[self.mongo_db]
        self.collection = self.db[spider.name]

    def close_spider(self, spider):
        # 爬虫结束时将缓冲区剩余项全部写出
        if self.items_buffer:
            self._flush_buffer()
        self.client.close()

    def process_item(self, item, spider):
        self.items_buffer.append(dict(item))
        if len(self.items_buffer) >= self.batch_size:
            self._flush_buffer()
        return item

    def _flush_buffer(self):
        if not self.items_buffer:
            return
        # 使用 bulk_write 进行 upsert 批量原子写入
        operations = [
            UpdateOne(
                {'sku_id': doc['sku_id']},
                {'$set': doc},
                upsert=True
            ) for doc in self.items_buffer
        ]
        self.collection.bulk_write(operations, ordered=False)
        self.items_buffer.clear()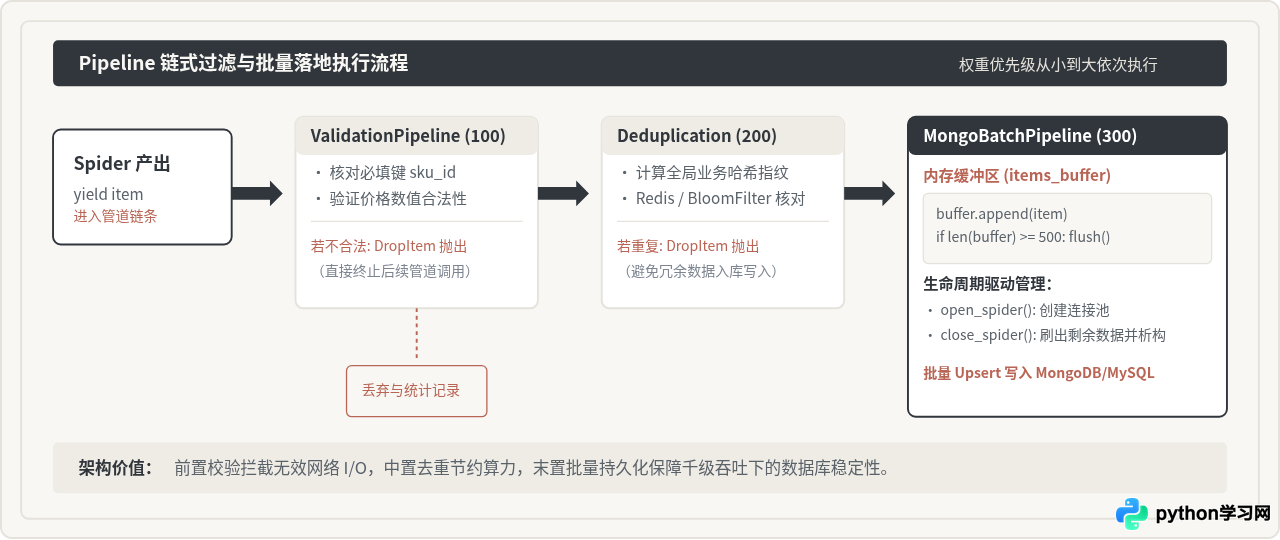
四、配置解耦与并发调优策略
一个优秀的架构除了模块分离,还依赖于严谨的全局配置机制。在大型项目中,通常将配置项拆分为公用基础配置(base.py)与环境配置(production.py),并明确分配 Pipeline 优先级与核心并发参数。
settings/production.py
# 启用管道并明确配置执行顺序(数字越小越先执行)
ITEM_PIPELINES = {
    'crawler_core.pipelines.validation.ValidationPipeline': 100,
    'crawler_core.pipelines.deduplication.DeduplicationPipeline': 200,
    'crawler_core.pipelines.storage.MongoBatchPipeline': 300,
}

# 并发与反爬控制策略
CONCURRENT_REQUESTS = 32                 # 全局下载器并发限制
CONCURRENT_REQUESTS_PER_DOMAIN = 8       # 单域并发上限,防止触发封禁
DOWNLOAD_DELAY = 0.25                    # 请求间隙(秒)
AUTOTHROTTLE_ENABLED = True              # 启用自适应限速扩展
AUTOTHROTTLE_START_DELAY = 0.5
AUTOTHROTTLE_MAX_DELAY = 10.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 4.0

# 重试与容错机制
RETRY_ENABLED = True
RETRY_TIMES = 3                          # 失败重试次数
RETRY_HTTP_CODES = [500, 502, 503, 504, 408, 429]

# 禁用默认的内存去重以节约千万级请求下的内存占用(可接入 scrapy-redis)
DUPEFILTER_CLASS = 'scrapy.dupefilters.RFPDupeFilter'- 谨慎在单个 Pipeline 中混合异步与同步库:如果使用非异步数据库驱动(例如原生的 pymysql 或 psycopg2),务必通过线程池或批量缓存机制处理,否则单条阻塞查询会导致 Scrapy 的 Twisted Reactor 事件循环停滞。
- 必须在 close_spider 中清空缓冲区:批量写入管道最常见的致命 Bug 是当爬虫结束时,缓冲区中不足
batch_size的最后一部分数据没有被写出。务必在close_spider中显式调用刷新逻辑。
五、核心工程规范总结
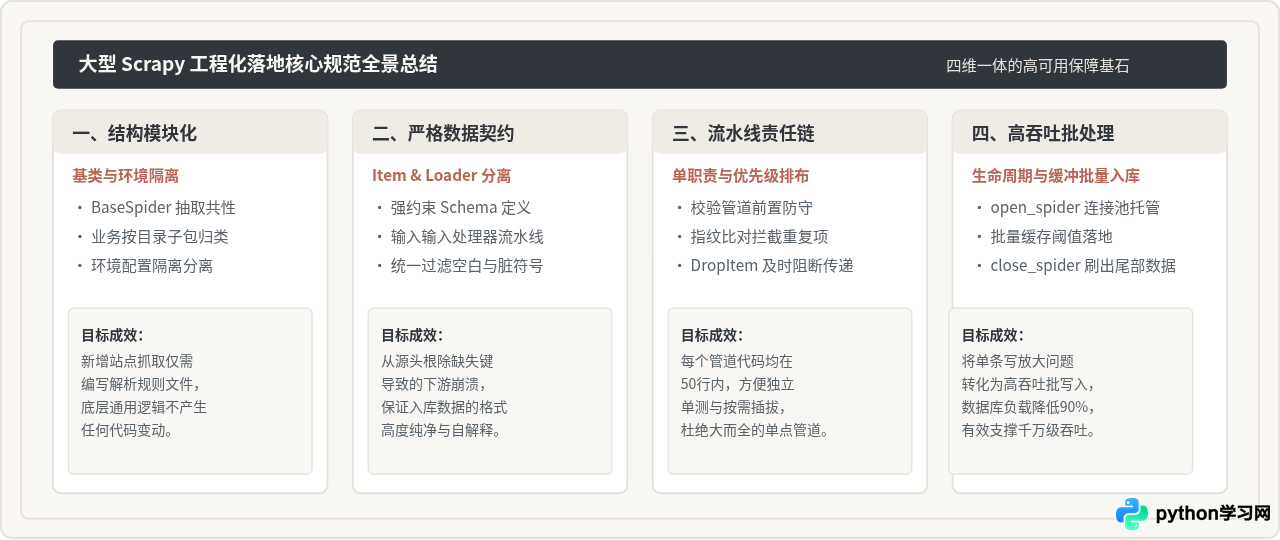
为了方便项目落地实施与日常 Code Review,下表梳理了大型 Scrapy 项目在结构组织、数据模型与持久化管道上的核心工程规范对照要求:
| 规范维度 | 推荐实践做法 | 禁止/警惕的反模式 |
|---|---|---|
| 工程组织 (Structure) | 按业务线隔离 Spider,提取 BaseSpider 公共基类;配置拆分环境;业务逻辑与入库严格解耦。 |
在单个爬虫文件中写死数据库账号密码与入库逻辑;所有爬虫平铺在一个大目录。 |
| 数据契约 (Item) | 使用 scrapy.Item 强类型定义键名;配合 ItemLoader 实现字段抽取与清洗规则分离。 |
在 Spider 解析回调中直接 yield dict;随意自增非规范字段;Spider 内嵌字符串正则清洗。 |
| 管道处理 (Pipeline) | 单一管道单职责;通过权重由小到大链式排列(校验 → 去重 → 格式化 → 批量入库)。 | 写一个几百行的综合 Pipeline;单条解析单次连接数据库并执行同步 INSERT。 |
| 连接与资源 (Resource) | 利用 open_spider 和 close_spider 统一初始化与释放连接池;维护内存批量缓存。 |
在 process_item 中重复打开/关闭数据库连接;爬虫结束时遗漏未写入的尾部数据。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









