

Python爬虫新手入门:从环境搭建到第一个requests请求
面向新手的Python爬虫入门教程,系统讲解开发环境准备、虚拟环境创建、requests库安装与基础用法,并带读者完成第一个HTTP请求与数据解析。
requests 库,理解客户端与服务器之间的 HTTP 交互流程,并成功发送第一个 GET 请求提取网页内容。
一、爬虫的工作机制与 HTTP 交互原理
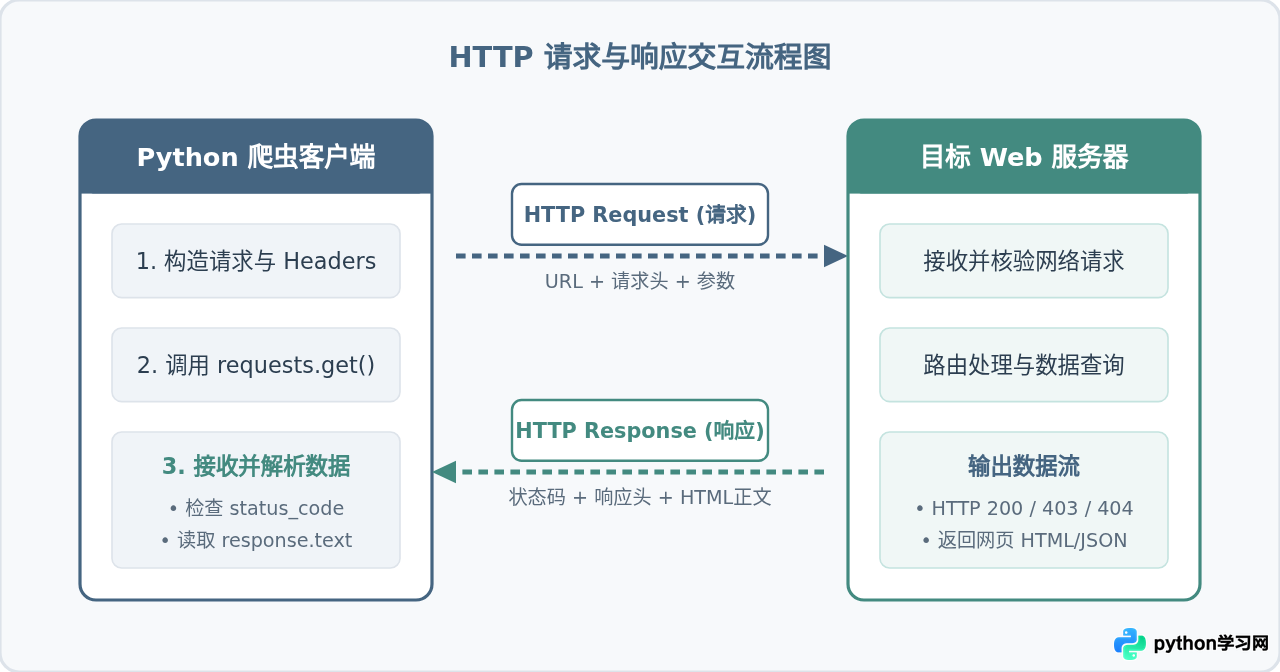
当我们使用浏览器访问某个网站时,浏览器会向托管该网站的服务器发送一个“请求(Request)”。服务器收到请求后进行验证和处理,再返回包含网页源代码的“响应(Response)”。浏览器负责将这些代码渲染为用户可见的图文页面。
Python 爬虫做的事情在本质上与浏览器完全一致,区别在于爬虫跳过了繁重的图形渲染环节,直接通过代码模拟网络请求并接收原始数据。因此,搞清楚 HTTP 交互的关键环节是编写任何爬虫程序的基础前提。
二、搭建干净的本地开发环境
在正式写代码之前,规范的环境配置能避免 80% 的依赖冲突与路径报错。推荐使用 Python 自带的 venv 模块为每个爬虫项目建立隔离的虚拟环境。
步骤 1:确认 Python 版本
打开终端(macOS/Linux)或命令提示符(Windows PowerShell),输入以下命令检查 Python 安装情况:
# 检查 Python 解释器版本(建议 3.8 及以上)
python3 --version
# 如果在 Windows 上,可能直接输入:
python --version
若终端正确输出形如 Python 3.10.x 或更高版本信息,说明 Python 环境已经就绪。
步骤 2:创建并激活项目专属虚拟环境
虚拟环境能够将项目所需的第三方库安装在指定文件夹内,不会污染系统全局环境。进入你规划的项目目录后执行:
# 1. 创建名为 crawler_env 的虚拟环境目录
python3 -m venv crawler_env

# 2. 激活虚拟环境
# macOS / Linux 执行:
source crawler_env/bin/activate

# Windows PowerShell 执行:
# crawler_env\Scripts\Activate.ps1
激活成功后,命令行提示符前方会出现 (crawler_env) 前缀。
步骤 3:安装 requests 第三方库
Python 标准库虽然内置了 urllib,但其 API 较为繁琐,需要手动处理编码、Cookie 和重定向等细节。而 requests 库被广泛称为“人类专用的 HTTP 库”,封装了简洁明了的调用方式。在已激活的环境中运行:
# 安装 requests 库
pip install requests

# 验证是否安装成功
python -c "import requests; print('requests版本:', requests.__version__)"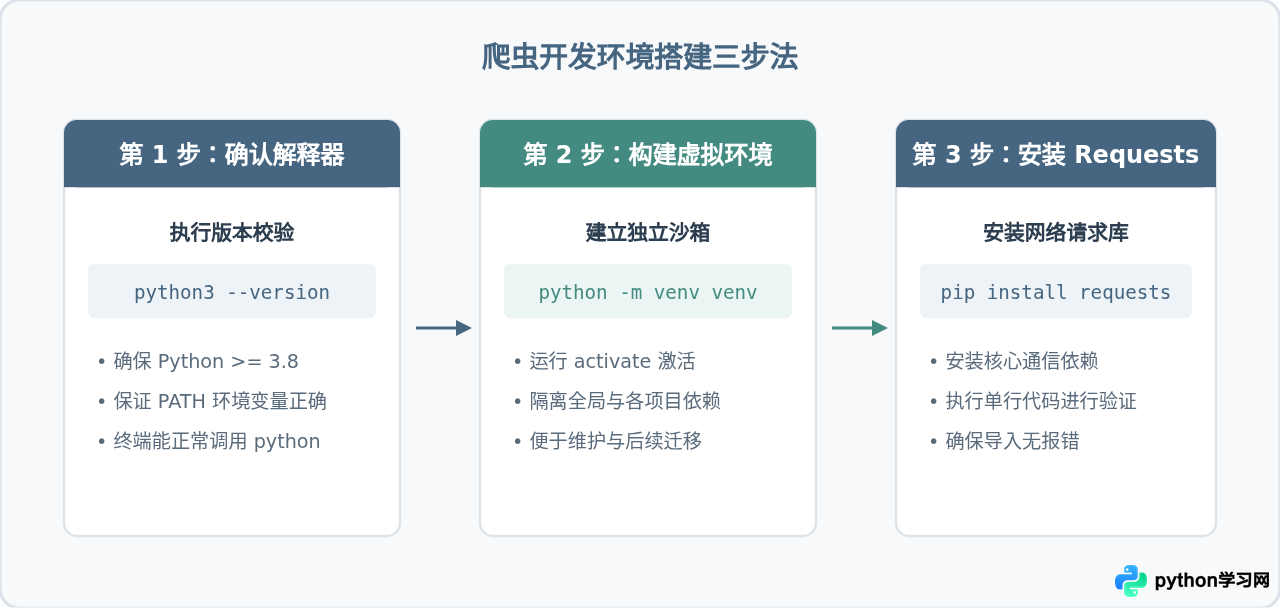
三、编写并运行第一个 requests 请求
我们新建一个名为 first_spider.py 的脚本文件。在这个入门例子中,我们请求一个专门供开发者进行 HTTP 测试的公开网站 https://httpbin.org/get。
1. 基础请求代码
import requests

# 目标测试接口
target_url = "https://httpbin.org/get"

# 发送 HTTP GET 请求
response = requests.get(target_url, timeout=10)

# 输出状态码与响应内容
print(f"响应状态码: {response.status_code}")
print("响应内容(前 300 字符):")
print(response.text[:300])在终端中运行该文件:python first_spider.py
# 终端示例输出:
响应状态码: 200
响应内容(前 300 字符):
{
  "args": {},
  "headers": {
    "Accept": "*/*",
    "Accept-Encoding": "gzip, deflate",
    "Host": "httpbin.org",
    "User-Agent": "python-requests/2.31.0"
  },
  "origin": "x.x.x.x",
  "url": "https://httpbin.org/get"
}
2. 代码剖析与核心概念
requests.get(url, timeout=10):发起标准的 HTTP GET 方法。参数timeout=10表示如果服务器在 10 秒内未返回数据,则主动终止等待并抛出超时异常,防止程序卡死。response.status_code:服务器返回的状态码。数字200明确代表本次请求成功;如果看到403则代表禁止访问,404代表资源不存在,500则代表服务器内部错误。response.text:服务器返回的文本主体(HTML 源代码或 JSON 文本)。requests会自动根据 HTTP 标头推测编码并解码为字符串。
3. 关键改进:伪装请求头(Headers)
细心的读者在上面的示例输出中会发现,User-Agent 显式显示为 python-requests/2.31.0。大多数商业网站为了防止爬虫消耗服务器资源,会直接拦截带有此标识的请求。
因此,在真实开发中,第一步永远是为请求加上伪装的浏览器 User-Agent:
import requests

url = "https://httpbin.org/get"

# 自定义请求头,模拟真实浏览器
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

# 传入 headers 参数
response = requests.get(url, headers=headers, timeout=10)

if response.status_code == 200:
    print("请求成功,已成功模拟浏览器访问!")
    print(response.text[:200])
else:
    print(f"请求失败,状态码为: {response.status_code}")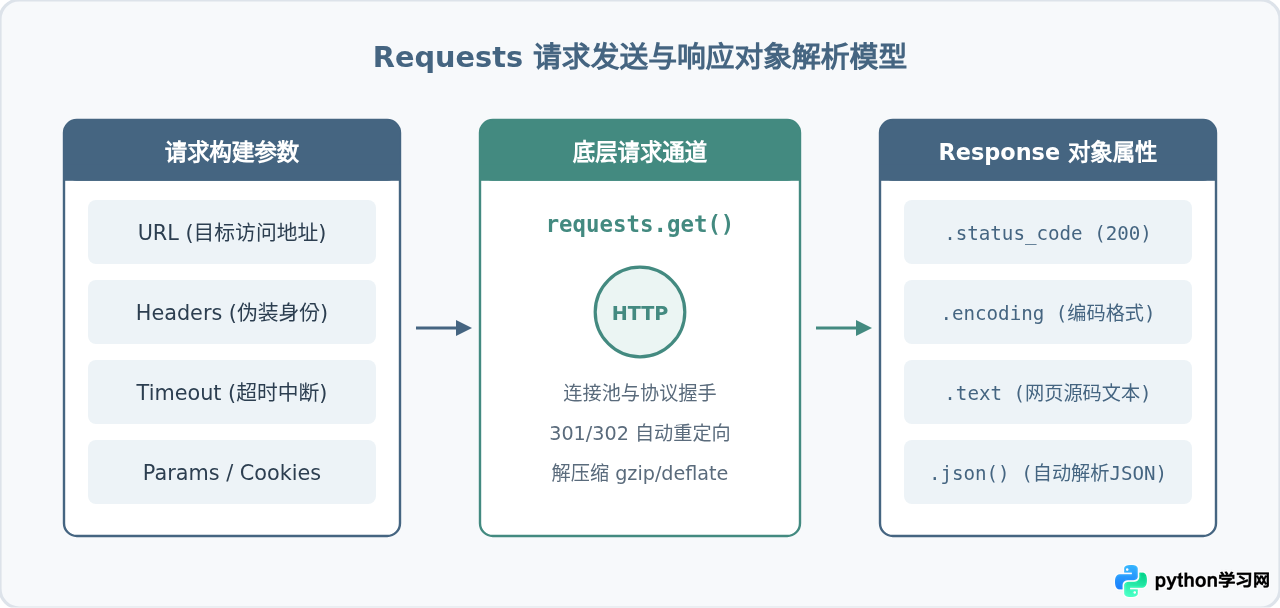
四、常见新手问题与排查指南
1. 打印内容出现中文乱码
有时打印 response.text 会出现 ä½ å¥½ 这类无意义符号。这是因为 requests 默认通过 HTTP 标头猜测编码(如 ISO-8859-1),而网页实际采用的是 UTF-8 或 GBK。
解决方法:在读取 response.text 前显式指定编码,或者借助 apparent_encoding 自动检测:
# 方案 A:手动指定常用中文编码
response.encoding = "utf-8"

# 方案 B:由 chardet/charset_normalizer 自动推测实际内容编码
response.encoding = response.apparent_encoding
2. 遭遇 403 Forbidden 报错
遇到 403 意味着服务器理解了请求但拒绝提供服务,通常触发了目标站点的反爬风控机制。排查顺序为:
- 检查请求头中是否遗漏了
User-Agent。 - 检查是否需要携带
Referer(指明上级来源页面)或Cookie。 - 确认请求频率是否过高触发了 IP 限速。
3. 网络异常与超时保护
爬虫在批量运行时难免遇到目标站点临时宕机、DNS 解析失败或网络丢包。为了保证程序在单次请求失败时不崩溃,需要使用 try...except 捕获 requests.exceptions.RequestException:
import requests
from requests.exceptions import RequestException, Timeout

try:
    response = requests.get("https://httpbin.org/get", timeout=5)
    response.raise_for_status()  # 若状态码非 200 则直接抛出 HTTPError
    print("获取数据成功!")
except Timeout:
    print("请求超时,请检查网络或放宽超时时间限制")
except RequestException as err:
    print(f"发生网络异常: {err}")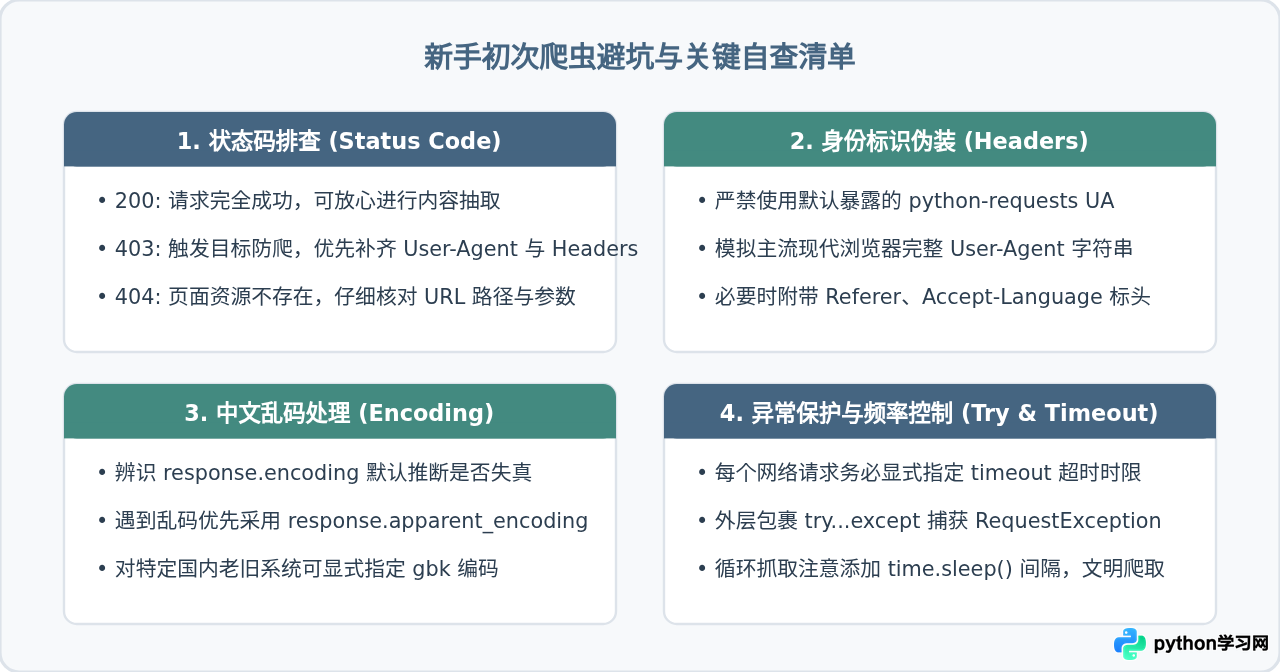
五、总结与后续进阶路径
回顾本文的内容,我们完成了爬虫开发中最核心的起步工作:
- 理解了爬虫本质上是在程序级别发起合法的 HTTP GET 请求并接收响应。
- 掌握了通过
venv创建项目隔离环境及安装requests库的操作规范。 - 学会了在请求中加入
headers伪装浏览器身份,并对status_code与字符编码进行妥善处理。 - 构建了带有超时保护和异常捕获的稳健请求骨架。
当成功拿到网页源代码后,下一步就是从原始 HTML 字符串中提取出所需要的结构化信息(如标题、价格、文章正文)。读者接下来可以进一步学习基于 DOM 树解析的工具库(例如 BeautifulSoup4 或 lxml 的 XPath 语法),进而完成从“获取数据”到“清洗存储数据”的完整闭环。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









