

Python 50行代码实现图灵图书爬虫与数据提取
本文详细解析如何使用Python的requests库进行网页请求,结合BeautifulSoup解析HTML结构,从图灵网抓取图书列表并提取详情页链接。文章通过具体代码示例,演示了如何从列表页解析链接,并从详情页提取书名、定价及电子书价格等关键信息,提供了完整的爬虫实现思路与代码片段。
2026-10-13
5

本文详细解析如何使用Python的requests库进行网页请求,结合BeautifulSoup解析HTML结构,从图灵网抓取图书列表并提取详情页链接。文章通过具体代码示例,演示了如何从列表页解析链接,并从详情页提取书名、定价及电子书价格等关键信息,提供了完整的爬虫实现思路与代码片段。
本文详细介绍如何使用Python结合BeautifulSoup4库爬取名言网top10标签下的名言数据,并将包含名言、作者及标签的信息存储至MySQL数据库。代码涵盖网页解析、分页处理及数据库插入操作,适合Python初学者参考学习。
本文详细解析Python爬虫中常见的Headers、IP限制及User-Agent反爬策略,并提供代理池与随机UA解决方案。重点讲解如何通过F12开发者工具定位XHR数据包,抓取民政部行政区划、豆瓣电影及腾讯招聘等网站的Ajax动态加载数据,结合正则与XPath实现增量抓取与完整数据提取。
本文详解Python中urllib模块的核心用法,涵盖urlopen发起请求、Request设置User-Agent伪装、urlencode处理查询参数及quote编码等关键步骤。通过百度贴吧多页数据抓取的完整案例,演示如何构建爬虫类、拼接URL并保存HTML文件,帮助开发者掌握基础网络数据采集技能。
本文介绍如何使用Selenium结合PhantomJS模拟浏览器行为,以绕过豆瓣读书严格的反爬机制。针对直接请求导致的数据缺失和报错问题,通过模拟浏览器加载获取完整页面信息,并解析存储书籍数据。
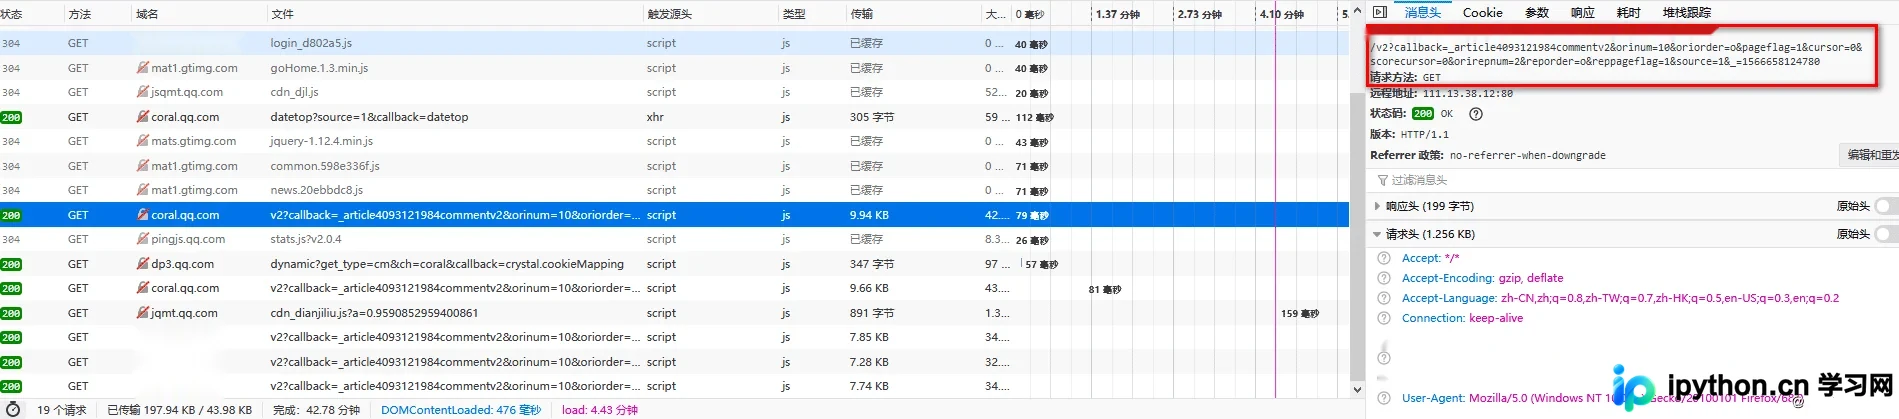
本文解析如何使用Python抓取2019年《中国好声音》第六期在腾讯视频的公开评论数据。通过逆向分析接口参数,实现分页评论、用户昵称及地区信息的自动化采集。随后利用jieba库进行中文分词,结合WordCloud生成主题词云,并通过Matplotlib绘制国内各地区参与用户分布直方图,完整展示从数据抓取到可视化分析的技术流程。
本文通过两个Python爬虫实例详解XPath技术的应用。案例一演示如何从图片列表页提取内页链接,进而获取百度网盘地址与提取码,涉及函数传参、循环控制及异常跳过逻辑。案例二针对豆瓣读书评论,解析为何直接获取节点无效,并指出使用/text()提取文本内容的正确方法。文章涵盖requests与lxml库的基础用法及常见错误排查。
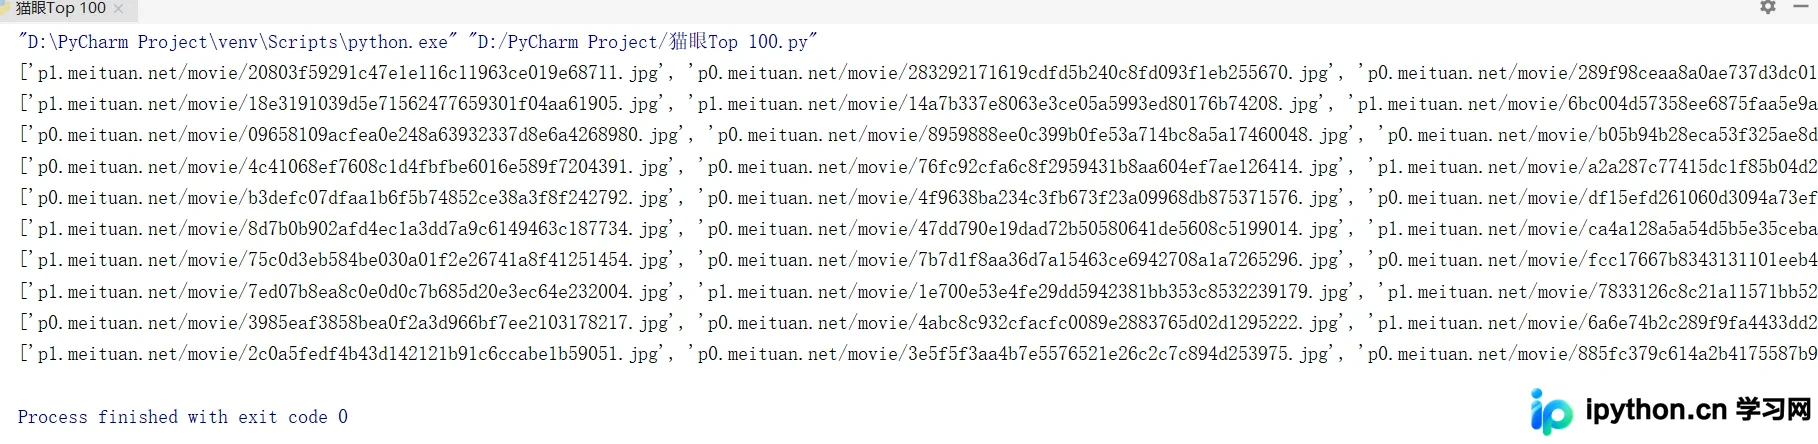
本文通过Python爬虫实战,演示如何使用正则表达式从猫眼电影Top100榜单批量下载电影封面图。文章详细解析了页面元素分析、URL规律观察及正则匹配策略,结合requests与re模块实现数据提取,并探讨该方法的优缺点及与其他爬虫技术的对比。
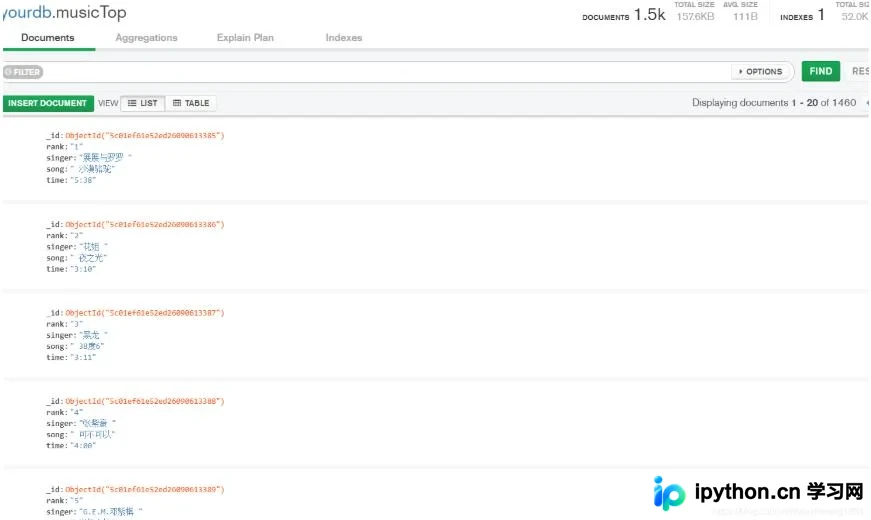
本文介绍如何使用Python3编写爬虫程序,自动抓取酷狗音乐TOP500榜单中的排名、歌曲名及时长信息。通过构造分页URL批量获取数据,并利用MongoDB数据库进行持久化存储,实现自动化数据采集与保存。
本文介绍使用Python爬虫批量下载Zabbix官方文档的方法。通过requests获取页面链接,利用正则表达式解析目录结构,并拼接导出PDF参数实现批量下载。代码包含错误处理与延时机制,适合需要离线查阅技术文档的场景。
本文详解Python爬虫中User-Agent(UA)的作用及反爬原理。通过对比默认urlopen与自定义Request对象,演示如何获取浏览器UA并封装进headers字典,成功伪装爬虫身份以绕过网站检测。包含搜狗搜索抓包获取UA及完整代码示例,帮助开发者解决基础反爬问题。
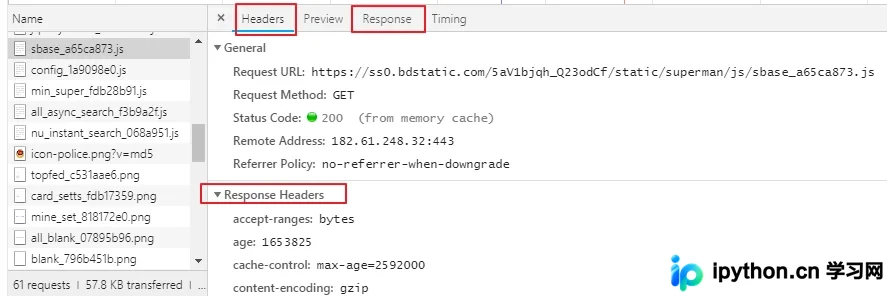
本文详解Python中Requests模块发起GET请求的两种常见场景:携带查询参数与自定义请求头。通过搜狗首页及搜索接口的实战代码,演示如何利用params字典传递URL参数,以及通过headers参数设置User-Agent以模拟浏览器访问,帮助开发者掌握基础爬虫请求构造技巧。