

Python3 爬取酷狗TOP500音乐信息并存储至MongoDB

发布时间:2026-10-13| 5人浏览过
本文介绍如何使用Python3编写爬虫程序,自动抓取酷狗音乐TOP500榜单中的排名、歌曲名及时长信息。通过构造分页URL批量获取数据,并利用MongoDB数据库进行持久化存储,实现自动化数据采集与保存。
爬取目标与数据字段说明
本示例旨在抓取酷狗音乐TOP500榜单中的关键信息,具体包括歌曲的当前排名、歌曲名称以及歌曲时长。
酷狗榜单URL分页规律分析
由于酷狗网页版不支持手动翻页操作,我们需要通过观察URL规律来构造请求。以第一页的URL为例:
http://www.kugou.com/yy/rank/home/1-8888.html
通过测试发现,将URL中home/后的数字1修改为2,即可访问第二页内容;修改为3则访问第三页。由此可知,该数字代表页码。鉴于每页展示22首歌曲,TOP500榜单共需生成23个不同的URL地址进行遍历爬取。
Python爬虫代码实现与MongoDB存储
import requests
from bs4 import BeautifulSoup
from time import sleep
import pymongo
#连接数据库
client = pymongo.MongoClient(‘localhost',27017)
mydb = client[‘yourdb']
#创建数据库
musicTop = mydb[‘musicTop']

#使用header是用于伪装为浏览器,让爬虫更稳定
Headers = {
‘User-Agent': ‘Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36'
}
#定义获取信息的函数
def get_info(url):
wd_data = requests.get(url,headers=Headers)
soup = BeautifulSoup(wd_data.text,‘lxml')
#获取排名情况
ranks = soup.select(‘span.pc_temp_num')
#获取标题
titles = soup.select(‘div.pc_temp_songlist > ul > li > a')
#获取时间
times = soup.select(‘span.pc_temp_tips_r > span')
for rank,title,time in zip(ranks,titles,times):
data = {
‘rank':rank.get_text().strip(),
‘singer':title.get_text(),
‘song':title.get_text(),
‘time':time.get_text().strip()
}
musicTop.insert_one(data) #存入数据库中
if name == ‘main':
urls = [‘http://www.kugou.com/yy/rank/home/{}-8888.html'.format(number) for number in range(1,24)]
for url in urls:
get_info(url)
sleep(2)
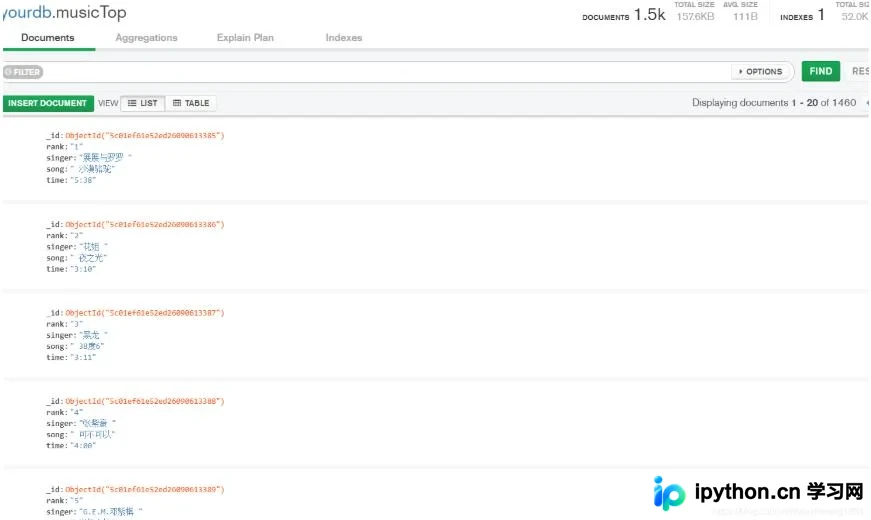
数据存储结果展示
程序运行结束后,从MongoDB数据库中查询到的数据结果如下所示:
以上就是利用Python3爬取酷狗TOP500音乐信息并存储到MongoDB数据库的完整教程。希望本文内容能对大家有所帮助,欢迎继续支持本站获取更多技术分享。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









