

Python爬虫实战:利用requests与urllib抓取今日头条街拍图片
本文详细介绍如何使用Python的requests和urllib库,结合OS模块爬取今日头条街拍美图。通过解析索引页获取图集链接,再深入详情页提取图片URL,最终实现批量保存本地。代码包含完整注释,适合Python爬虫初学者参考学习。
2026-10-13
4

本文详细介绍如何使用Python的requests和urllib库,结合OS模块爬取今日头条街拍美图。通过解析索引页获取图集链接,再深入详情页提取图片URL,最终实现批量保存本地。代码包含完整注释,适合Python爬虫初学者参考学习。
本文介绍使用Python编写简易爬虫并将抓取的数据保存至本地文件的方法。通过urllib获取网页内容,利用正则表达式提取图片链接,最后将图片保存至指定本地目录。文章基于Python 3.5环境,重点讲解了文件存储的实现细节及正则匹配的注意事项,适合初学者参考。
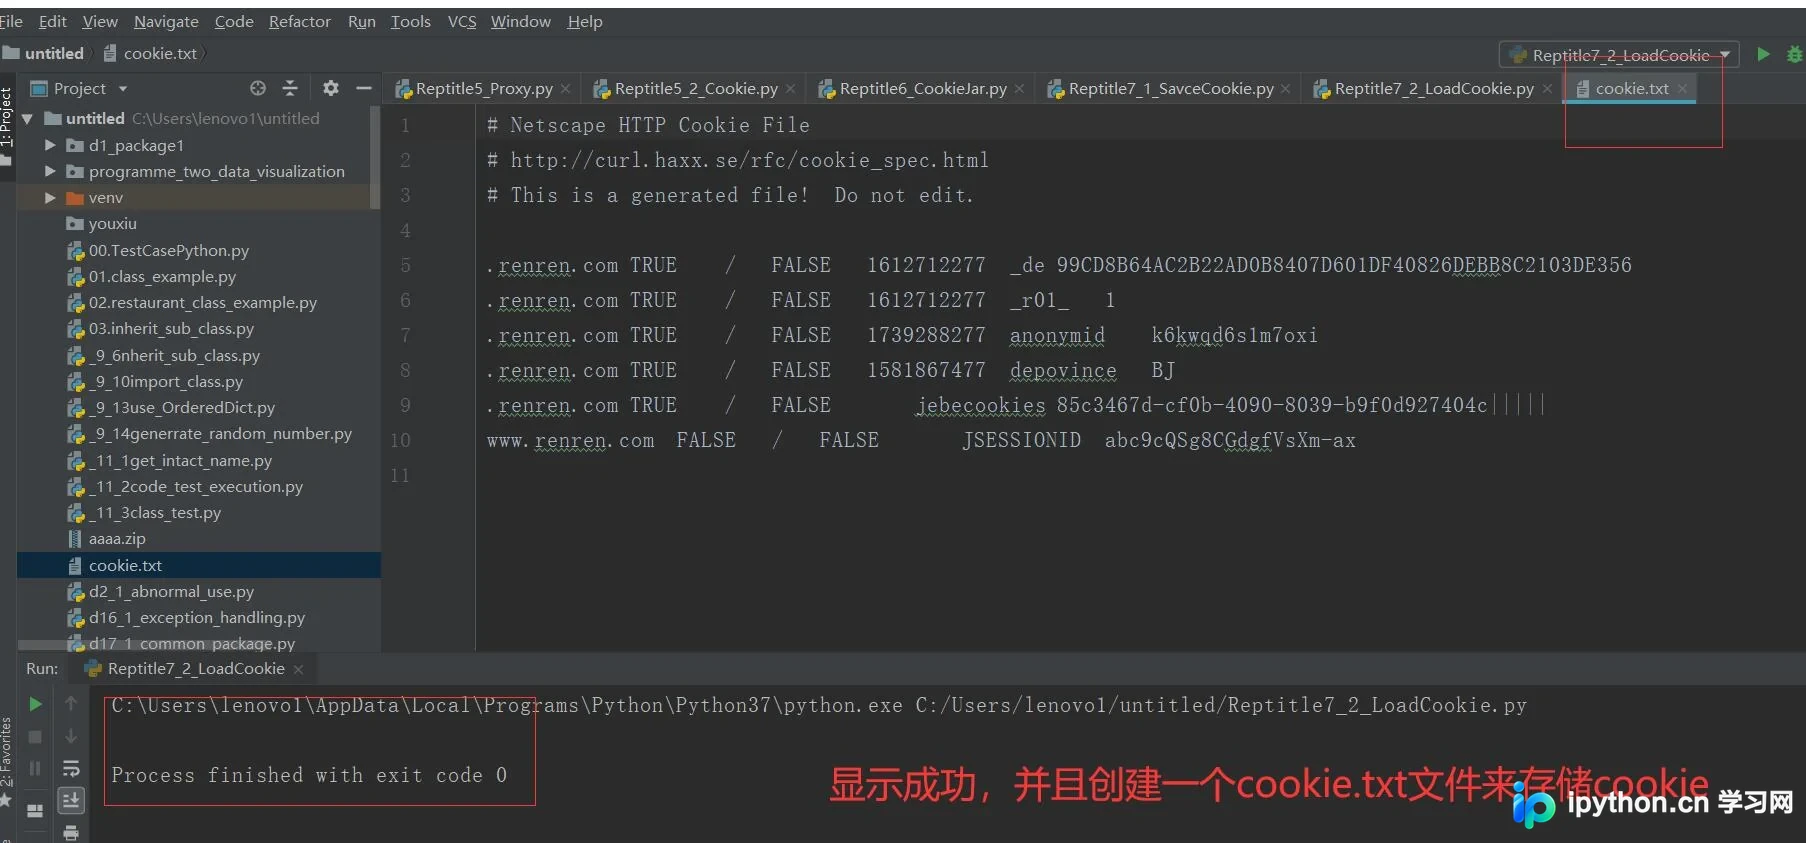
本文详解Python爬虫中Cookie的持久化保存与读取方法,利用FileCookieJar类实现登录状态的文件存储。同时介绍如何处理HTTPS请求中的SSL证书验证问题,通过替换默认上下文环境来忽略不信任的SSL证书,确保爬虫程序在复杂网络环境下的稳定运行。
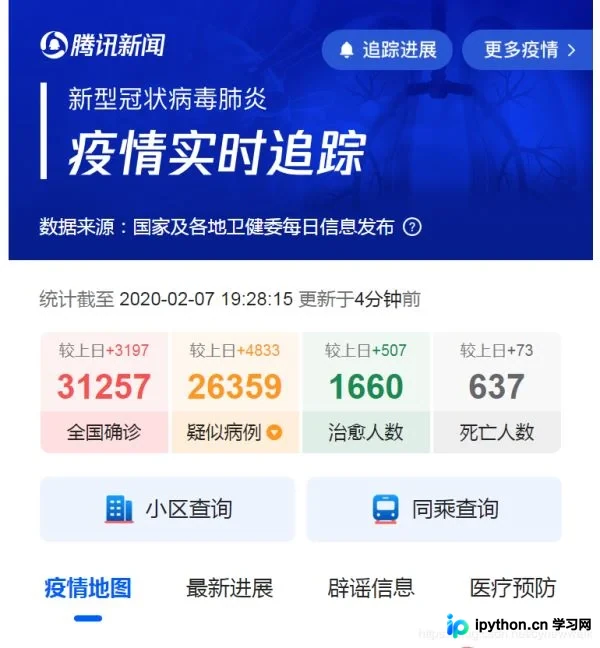
本文提供使用Python爬取疫情数据的完整源码。通过requests库获取接口数据,利用json模块解析嵌套JSON结构,提取全国及各省累计确诊病例等关键指标。代码包含类封装、数据下载与解析逻辑,适合Python初学者参考学习网络爬虫基础及数据抓取技巧。
本文详解Python爬虫中URL管理器的实现方法,重点解析如何利用collections模块中的deque双向队列高效维护待抓取与已抓取URL集合。通过示例代码展示如何判断URL存在性、执行去重逻辑及防止页面跳转死循环,为构建稳定爬虫系统提供核心组件参考。
本文详细解析使用Docker部署Python爬虫项目的完整步骤。内容涵盖Docker环境安装、基础镜像拉取、Python运行环境编译、依赖库处理、Dockerfile编写规范、镜像构建命令及容器启动参数配置,帮助开发者实现爬虫项目的标准化与自动化部署。
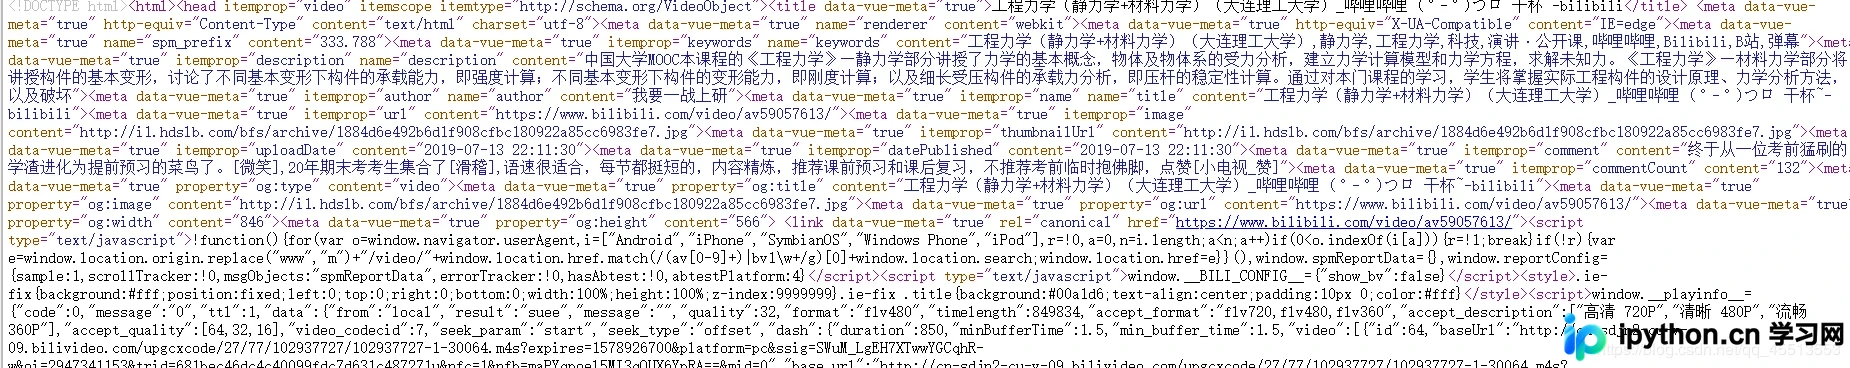
本文介绍利用Python脚本自动获取Bilibili系列视频总时长的方法。通过抓取网页源码中的timelength字段,结合正则表达式解析分集数量,实现批量视频时长的快速统计。文章包含详细操作步骤及完整GitHub源码链接,适合Python初学者参考学习。
本文介绍一种基于Python的自动化脚本,用于监控教务系统成绩更新。通过模拟登录获取加密数据,定时爬取成绩页面并将结果转化为列表进行比对。一旦发现新成绩,脚本立即通过邮件发送通知。该方案解决了教务系统无主动推送功能的痛点,支持将脚本部署在Ubuntu服务器上长期运行,确保用户及时获知成绩发布情况。
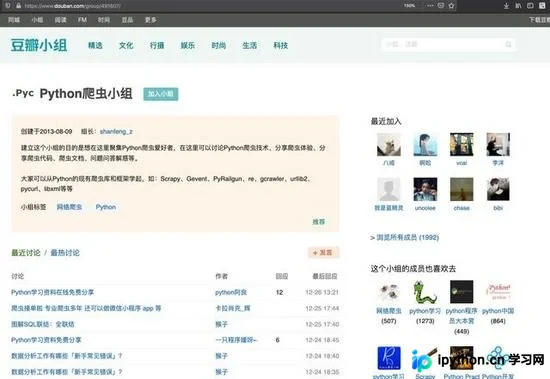
本文详细解析Python中解析HTML网页的四种主流方式:正则表达式、requests-html、BeautifulSoup及lxml XPath。通过豆瓣小组页面抓取实例,对比各库在代码复杂度、执行效率及适用场景上的差异,帮助开发者根据实际需求选择最高效的数据提取工具。
本文详细介绍在Python爬虫开发中如何添加请求头,分别通过requests、urllib以及PhantomJS三种方式给出具体代码示例。内容涵盖常见Header字段的配置方法,如User-Agent、Referer等,帮助开发者绕过基础反爬机制。
本文解析Python爬虫中通过设置User-Agent模拟浏览器访问的方法。通过urllib2构造请求对象并添加Headers,实现伪装浏览器身份进行数据抓取,同时展示获取响应状态码、URL及头部信息的技巧,帮助开发者规避基础反爬限制。
本文深入解析Python3 WebSpider爬虫代理池的源代码测试过程。重点介绍如何利用元类(Metaclass)自动注册抓取函数,通过约定前缀动态生成属性列表,实现抓取逻辑的解耦与扩展。文章包含详细的代码示例及控制台输出日志,展示代理获取器的执行流程与测试结果,为构建可扩展的爬虫系统提供参考。