Python爬虫处理URL中字典与列表参数的编码方案
本文探讨Python爬虫中URL包含字典或列表等非字符串参数时的编码问题。通过对比直接urlencode与先进行json序列化再urlencode两种方法,展示Python2环境下生成的URL差异,并建议当直接编码导致访问失败时,采用json序列化方式以确保参数正确解析。
2026-10-14
5

本文探讨Python爬虫中URL包含字典或列表等非字符串参数时的编码问题。通过对比直接urlencode与先进行json序列化再urlencode两种方法,展示Python2环境下生成的URL差异,并建议当直接编码导致访问失败时,采用json序列化方式以确保参数正确解析。
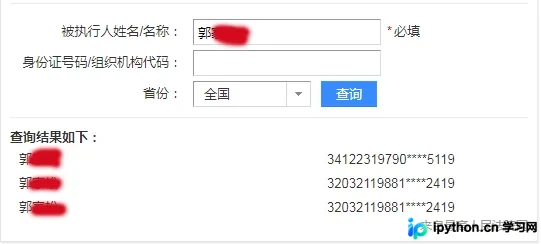
本文介绍如何使用Python编写爬虫程序,通过调用百度公开接口实现全国失信被执行人名单的批量查询功能。文章提供了两个版本的代码示例,分别展示基础姓名与身份证号查询及详细信息抓取,并演示如何将结果去重后保存至Excel文件,供开发者参考学习。
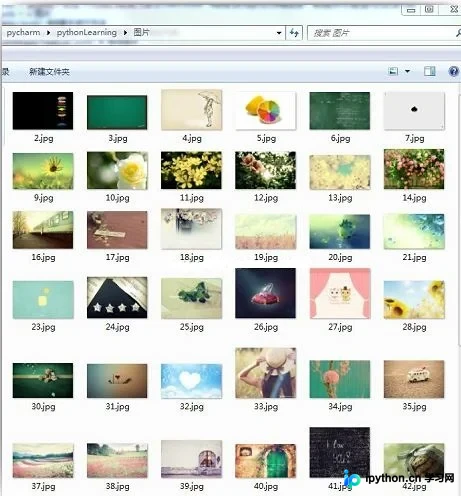
本文详细介绍如何使用Python的urllib和re模块抓取网页图片。通过获取HTML源码,利用正则表达式过滤图片URL,并实现本地保存功能。代码以百度贴吧为例,演示了从获取源码、解析链接到创建文件夹保存多张图片的完整流程,适合Python初学者参考学习。
本文详细记录了使用Python编写小说爬虫的全过程。文章从确定目标网址、分析页面结构入手,重点讲解了如何使用urllib.request获取网页内容,并通过设置Headers解决403 Forbidden错误。同时,针对常见的编码乱码问题,介绍了使用chardet库检测编码及手动指定GBK编码的方法,并结合socket.timeout处理网络超时异常,最终通过正则表达式提取章节内容并写入文件,提供了完整的代码实现参考。
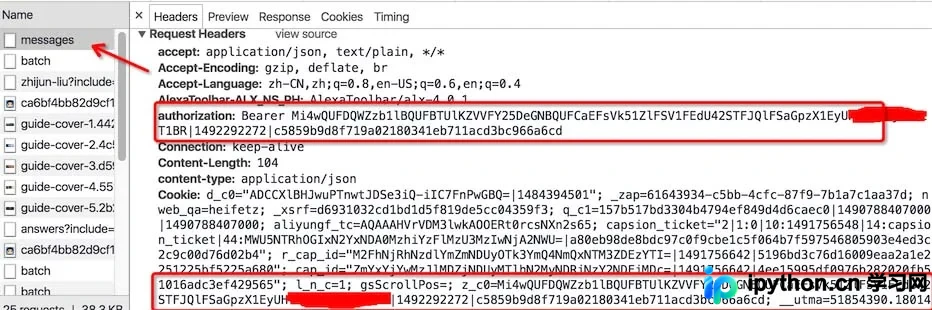
本文基于Python的requests库,详细解析如何构建知乎私信发送API。通过抓包分析HTTP请求头、URL及JSON请求体,获取用户ID与认证信息,实现登录状态下的私信发送功能。教程涵盖从网络请求追踪到代码实现的完整流程,提供获取用户信息、构造请求及调用API的关键代码示例,帮助开发者掌握利用requests模拟浏览器操作的核心技巧。
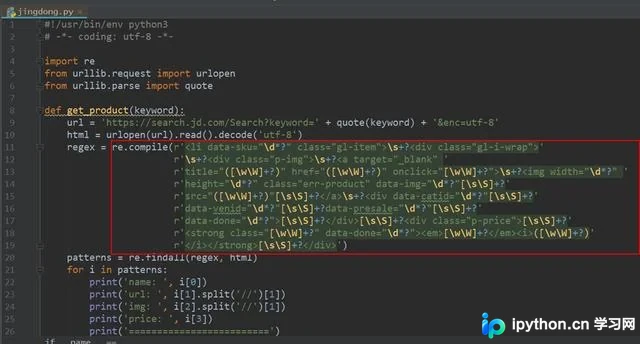
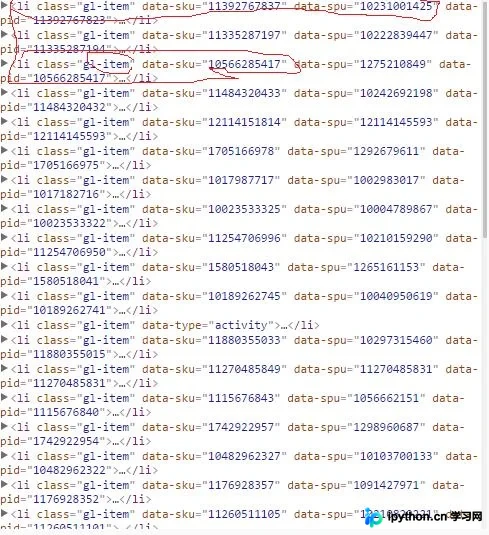
本文详解如何利用Python爬取京东商城商品数据。通过分析Ajax异步加载机制,结合Requests获取HTML源码,使用BeautifulSoup解析DOM结构提取data-pid及图片URL。教程涵盖简化请求URL、处理懒加载图片属性、多线程加速抓取及MySQL/MongoDB存储方案,提供完整代码逻辑与优化建议。
本文详细解析Python爬虫开发中涉及的HTTP请求方法,重点对比GET与POST在参数传递、数据长度及安全性上的核心差异。通过典型请求示例,帮助开发者理解HEAD、PUT、DELETE等方法的适用场景,为构建高效稳定的网络爬虫提供基础理论支持。
本文详解Python爬虫入门必备知识,从爬虫基本概念、互联网抓取逻辑讲起,深入解析浏览网页时的HTML获取过程及URL结构。重点阐述HTTP协议下的请求(Request)与响应(Response)机制,并推荐主流Python开发IDE,帮助初学者快速掌握爬虫基础架构与开发环境搭建。
本文解答Python爬虫是否容易学习的问题,解析网络爬虫的基本概念与工作原理。详细介绍企业数据、购买渠道及公开数据等来源,阐述基于URL、HTML和HTTP协议的抓取流程,并提供使用urllib库获取视频链接的Python代码示例,帮助初学者掌握基础爬虫技能。
本文系统梳理Python爬虫的核心知识点,涵盖从Python基础语法、urllib/urllib2网络请求库,到正则表达式数据提取,再到Scrapy高级框架的完整学习路径。同时解析爬虫背后的HTTP请求、DNS解析及服务器响应机制,帮助初学者建立完整的爬虫知识体系。
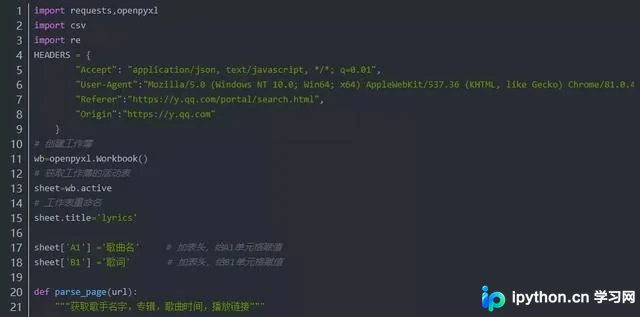
本文详细介绍如何利用Python爬虫技术批量获取QQ音乐歌词。通过浏览器开发者工具分析网络请求,定位搜索接口与歌词接口的URL及参数,编写代码提取歌曲信息与歌词文本,最终使用openpyxl库将结果保存为Excel文件,实现本地化存储与整理。
本文系统总结Python网络爬虫中常用的四种数据提取工具:正则表达式、BeautifulSoup、Lxml及CSS选择器。通过对比分析各模块的安装方式、解析原理、代码构造难度及运行性能,指出Lxml因C语言底层实现而在速度与健壮性上占优,而BeautifulSoup适合轻量级场景。文章提供各选择器的典型用法示例,帮助开发者根据实际需求选择最合适的数据抓取方案。