

Python爬虫实战:抓取百度指数数据的方法与代码解析

发布时间:2026-10-14| 5人浏览过
本文详细讲解如何使用Python爬虫获取百度指数数据。针对百度指数接口变更的情况,提供了包含请求头设置、Cookie处理及数据解密逻辑的完整代码示例。通过解析API返回的加密数据,实现关键词搜索量的获取,适用于数据分析及股票趋势观察等场景。
Python抓取百度指数的背景与价值
部分数据无法直接直观获取,必须通过抓取手段才能取得。提及“指数”一词,部分读者可能感到陌生,通常认为其仅存在于股票领域,涉及数据涨跌分析时往往较为棘手。然而,指数在数据分析环节中具有重要价值。本文将通过Python爬虫技术,详细演示如何抓取指数数据。
百度指数接口变更与代码实现
近期因实际需求需使用该爬虫,发现百度指数的请求机制有所调整,因此对原有代码进行了相应修改:
核心代码解析:请求头与解密逻辑
import requests
import sys
import time
word_url = 'http://index.baidu.com/api/SearchApi/thumbnail?area=0&word={}'
COOKIES = ''
headers = {
 'Accept': 'application/json, text/plain, */*',
 'Accept-Encoding': 'gzip, deflate',
 'Accept-Language': 'zh-CN,zh;q=0.9',
 'Cache-Control': 'no-cache',
 'Cookie': COOKIES,
 'DNT': '1',
 'Host': 'index.baidu.com',
 'Pragma': 'no-cache',
 'Proxy-Connection': 'keep-alive',
 'Referer': 'http://index.baidu.com/v2/main/index.html',
 'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.90 Safari/537.36',
 'X-Requested-With': 'XMLHttpRequest',
}
def decrypt(t,e):
 n = list(t)
 i = list(e)
 a = {}
 result = []
 ln = int(len(n)/2)
 start = n[ln:]
 end = n[:ln]
 for j,k in zip(start, end):
  a.update({k: j})
 for j in e:
  result.append(a.get(j))
 return ''.join(result)

def get_ptbk(uniqid):
 url = 'http://index.baidu.com/Interface/ptbk?uniqid={}'
 resp = requests.get(url.format(uniqid), headers=headers)
 if resp.status_code != 200:
  print('获取uniqid失败')
  sys.exit(1)
 return resp.json().get('data')
def get_index_data(keyword, start='2011-01-03', end='2019-08-05'):
 keyword = str(keyword).replace("'", '"')
 url = f'http://index.baidu.com/api/SearchApi/index?area=0&word={keyword}&area=0&startDate={start}&endDate={end}'
 resp = requests.get(url, headers=headers)
  print('获取指数失败')
 content = resp.json()
 data = content.get('data')
 user_indexes = data.get('userIndexes')[0]
 uniqid = data.get('uniqid')
 ptbk = get_ptbk(uniqid)
 while ptbk is None or ptbk == '':
  ptbk = get_ptbk(uniqid)
 all_data = user_indexes.get('all').get('data')
 result = decrypt(ptbk, all_data)
 result = result.split(',')
 print(result)
if __name__ == '__main__':
 words = [[{"name": "酷安", "wordType": 1}]]
get_index_data(words)
输出结果示例如下:
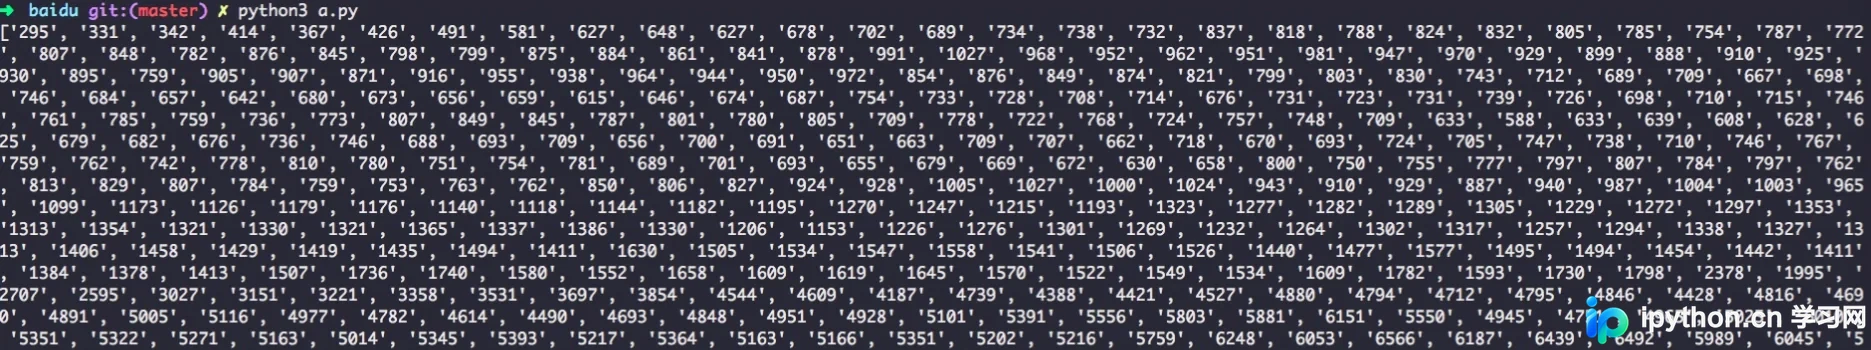
运行结果与应用场景
执行上述代码即可获取目标指数数据。此外,该方法同样适用于股票及其他相关数据的分析操作,利用Python爬虫处理此类需求是较为理想的选择。感兴趣的用户可参考示例进行尝试。
关于Python爬虫抓取指数的实例讲解至此结束。如需了解更多相关Python抓取指数内容,建议查阅本站过往文章或继续浏览后续相关内容。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









