

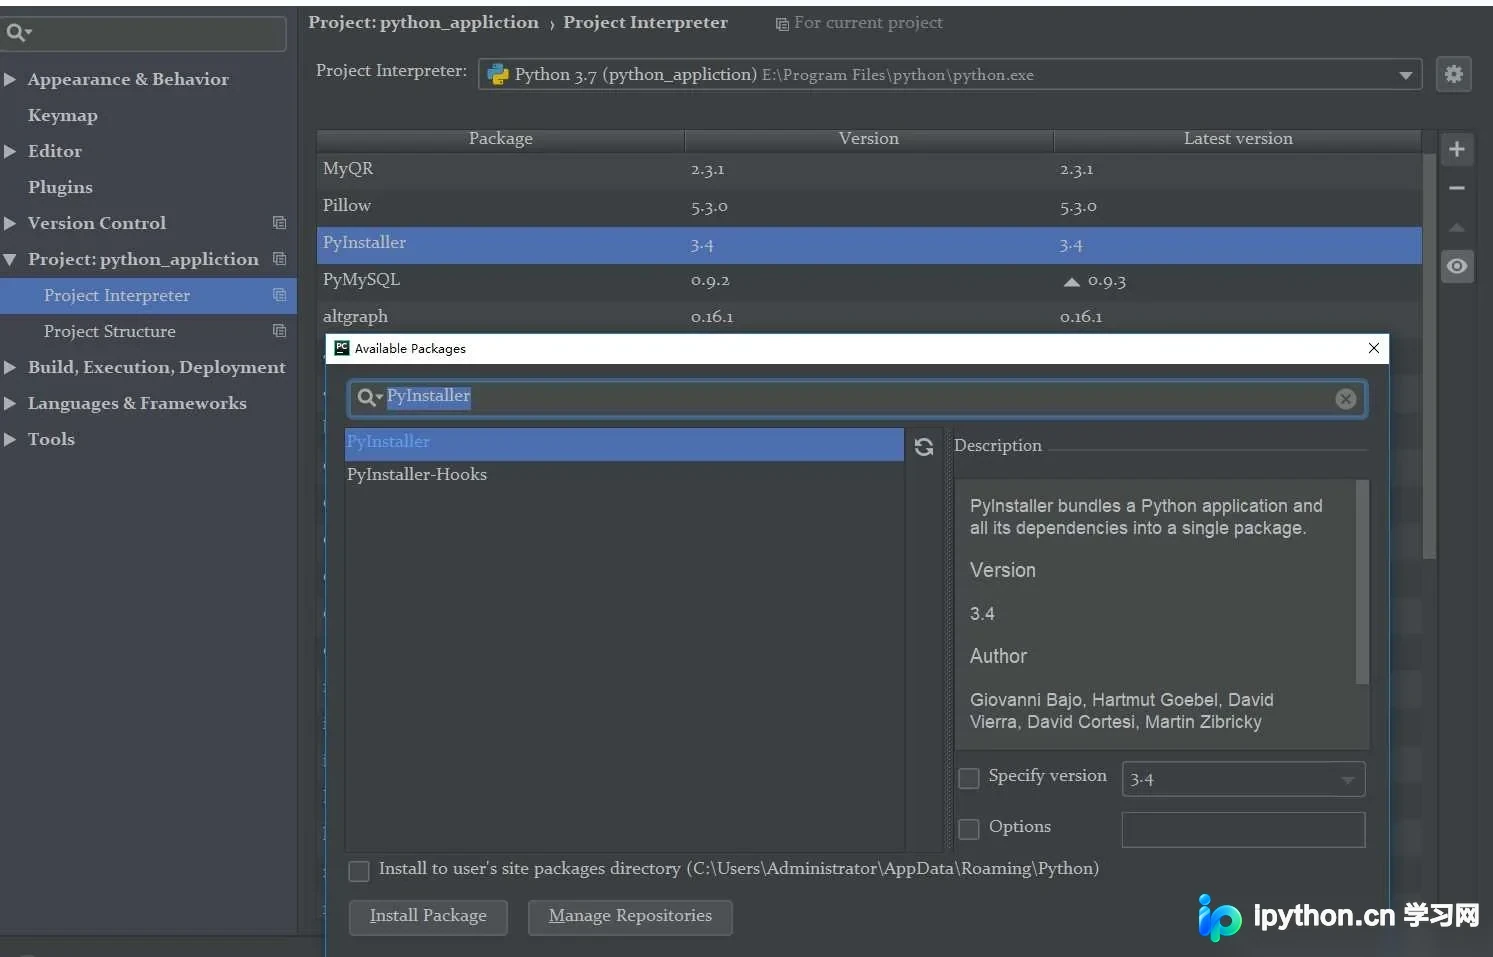
PyCharm中使用PyInstaller打包生成可执行文件教程
本文详细介绍如何在PyCharm中利用PyInstaller插件将Python项目打包为Windows .exe或Linux可执行文件。涵盖从安装插件、终端命令执行到-F和-w参数的具体用法,以及处理本地资源路径的注意事项,帮助开发者快速完成项目部署。
2026-10-13
9

本文详细介绍如何在PyCharm中利用PyInstaller插件将Python项目打包为Windows .exe或Linux可执行文件。涵盖从安装插件、终端命令执行到-F和-w参数的具体用法,以及处理本地资源路径的注意事项,帮助开发者快速完成项目部署。
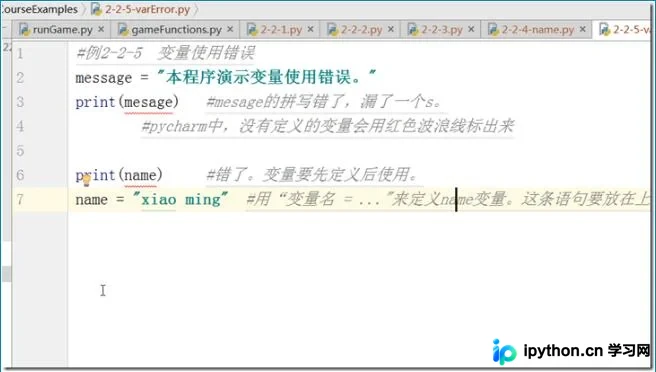
本文详解Python中常见的变量未定义错误,区分语法错误与逻辑错误。通过PyCharm编辑器示例,解析Traceback错误轨迹及NameError的具体含义,并补充input()函数使用时的引号规范,帮助开发者快速定位并修正代码中的拼写或定义问题。
本文详解Python中数字、字符串、列表、字典及元组的空值初始化方式,重点辨析None与空字符串的区别。通过代码示例说明None是特殊常量Nonetype,而空字符串为str类型,两者在布尔判断中均视为False,但比较方式不同,帮助开发者正确选择初始化方案。
本文详解如何使用Python的Beautiful库结合CSS选择器高效抓取京东商品信息。通过解析搜索URL参数、利用urllib.quote编码关键词,并编写具体的CSS提取逻辑,快速获取商品名称、链接、图片及价格。适合希望掌握轻量级网页解析技术的开发者参考。
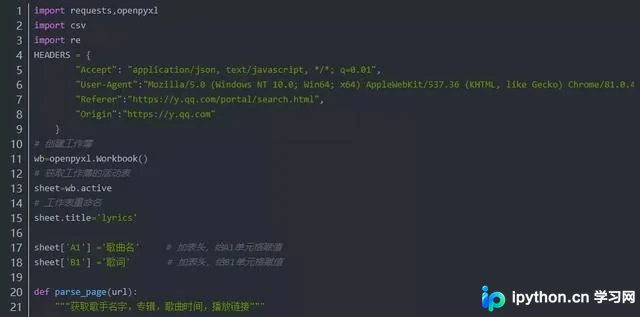
本文详细介绍如何利用Python爬虫技术批量获取QQ音乐歌词。通过浏览器开发者工具分析网络请求,定位搜索接口与歌词接口的URL及参数,编写代码提取歌曲信息与歌词文本,最终使用openpyxl库将结果保存为Excel文件,实现本地化存储与整理。
本文通过Python面向对象编程方法,演示如何实现扑克牌发牌系统。文章定义了Card、Hand和Poke三个核心类,分别代表单张牌、一手牌及整副牌。通过继承Hand类实现Poke类,利用随机洗牌和发牌逻辑,将52张牌均分给4位牌手,并展示完整的代码结构与输出示例。
本文演示如何使用Python的BeautifulSoup库解析京东网页源码。通过构造包含keyword参数的搜索URL,利用urllib.quote进行编码,并解析HTML标签树提取商品名称、链接、图片及价格。文中特别指出处理空图片链接时使用get方法的技巧,对比正则表达式展示了BeautifulSoup的便捷性。
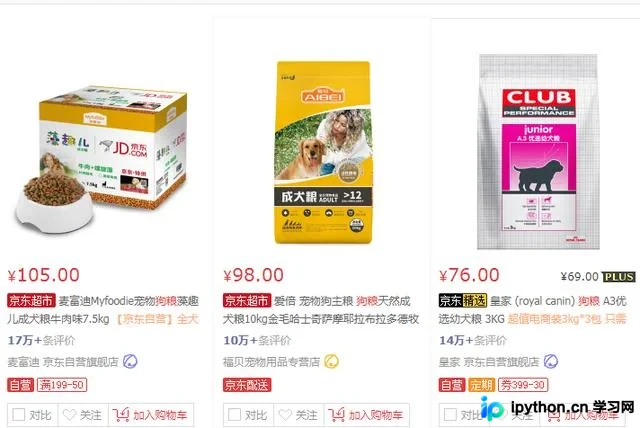
本文详细讲解如何在Python中不使用现成聚类库从零实现K-Means算法。内容涵盖算法核心原理、距离与均值计算逻辑、数据预处理及数据集划分方法。通过手动编写代码,演示如何迭代更新质点并计算训练集与测试集的SSE损失。结合肘部法则(Elbow Method),分析不同K值下的聚类效果,并通过代码示例展示如何利用SSE差值确定最优K值,适合希望深入理解聚类算法底层逻辑的开发者参考。
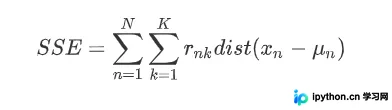
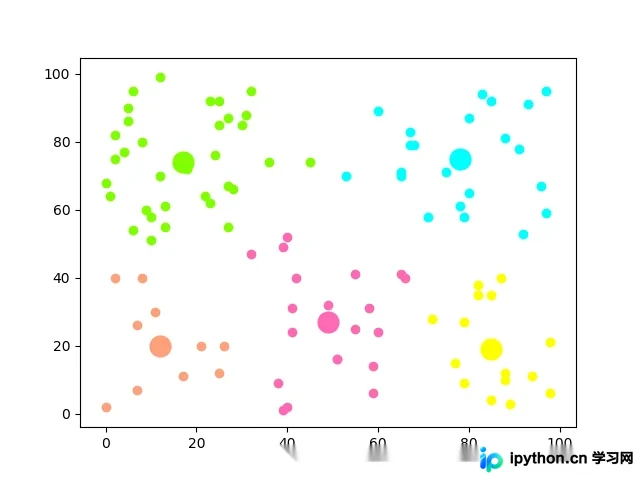
本文详细解析 k-means 聚类算法的核心思想,涵盖从随机初始化聚类中心到迭代更新均值的完整流程。通过 Python 代码展示如何利用 numpy 和 matplotlib 实现聚类过程及结果可视化,帮助开发者理解算法逻辑并快速上手应用。
本文系统总结Python网络爬虫中常用的四种数据提取工具:正则表达式、BeautifulSoup、Lxml及CSS选择器。通过对比分析各模块的安装方式、解析原理、代码构造难度及运行性能,指出Lxml因C语言底层实现而在速度与健壮性上占优,而BeautifulSoup适合轻量级场景。文章提供各选择器的典型用法示例,帮助开发者根据实际需求选择最合适的数据抓取方案。
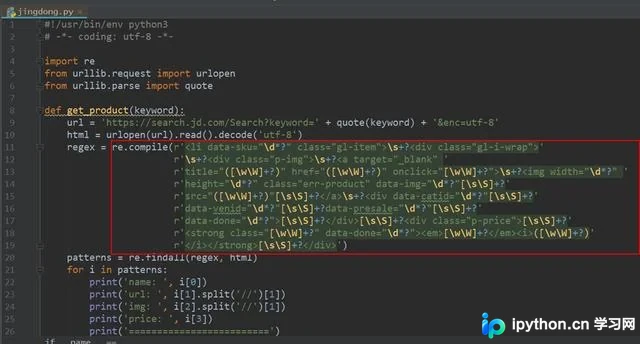
本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
本文详细介绍如何使用Python的Tkinter库制作一个交互式表白程序。通过创建GUI窗口、定义点击触发函数及弹窗逻辑,实现“喜欢”与“不喜欢”按钮的交互反馈。文章提供完整代码示例,包括窗口布局、事件绑定及消息提示功能,帮助开发者快速掌握Python GUI编程基础。