

Python利用BeautifulSoup CSS选择器爬取京东商品信息实战

本文详解如何使用Python的Beautiful库结合CSS选择器高效抓取京东商品信息。通过解析搜索URL参数、利用urllib.quote编码关键词,并编写具体的CSS提取逻辑,快速获取商品名称、链接、图片及价格。适合希望掌握轻量级网页解析技术的开发者参考。
CSS选择器
CSS选择器在爬虫中的应用价值
目前,市面上详细介绍BeautifulSoup使用的技术书籍和网络文章相对有限,其中专门讲解CSS选择器的内容更是稀少。尽管官方文档内容详实,但阅读门槛较高且缺乏精简的演示案例。然而,在网页爬虫的数据解析环节,CSS选择器实际上是一种效率极高的工具。
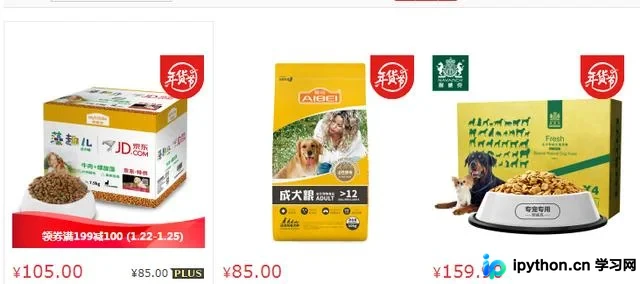
京东商品图
构建京东商品搜索请求
首先访问京东网站,输入目标商品关键词并向服务器发起请求。本文以“狗粮”为例,生成的搜索URL如下:https://search.jd.com/Search?keyword=%E7%8B%97%E7%B2%AE&enc=utf-8。该URL中的keyword参数对应输入的中文关键词,需进行编码处理以获取目标地址。随后请求网页并获取响应,接着利用CSS选择器进行后续的数据采集工作。
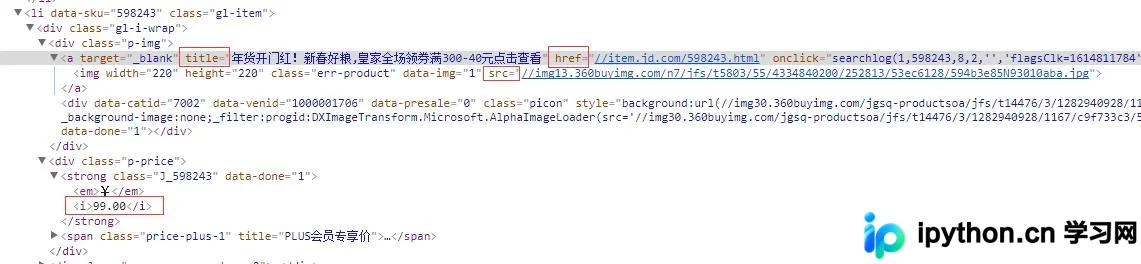
商品信息在京东官网上的部分网页源码如下图所示:
部分网页源码
分析网页源码可知,目标数据位于特定结构下方,需要逐层解析以提取所需信息。
URL编码与数据提取策略
在Python的urllib库中,quote方法可用于对URL字符串进行编码,从而正确访问对应网页。
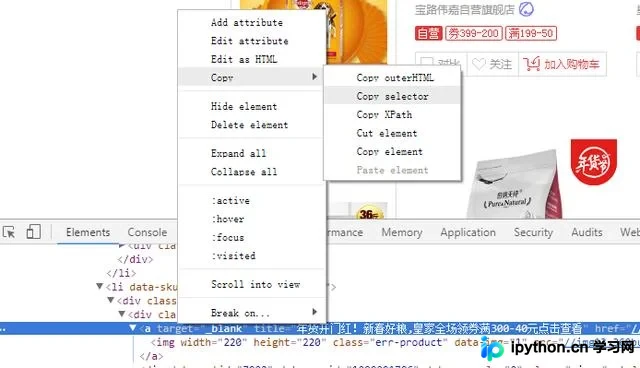
CSS选择器在线复制
许多开发者认为编写CSS表达式较为困难,但掌握基本用法后并不复杂。虽然存在在线工具可复制CSS表达式,但直接生成的表达式往往冗长且难以在代码中直接使用,因此建议手动编写简洁的CSS选择器。
CSS选择器代码实现
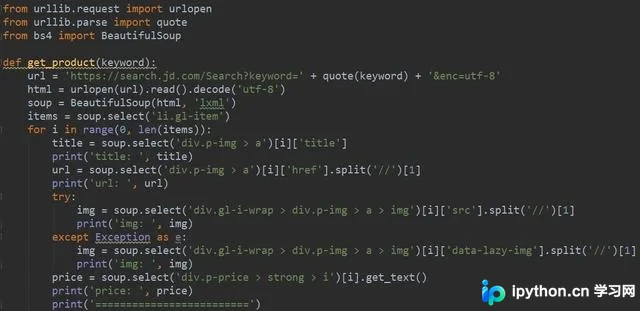
以下是利用CSS提取商品名称、链接、图片及价格的具体代码实现:
代码实现
若需快速构建功能更强大的网络爬虫,BeautifulSoup配合CSS选择器是必备工具。BeautifulSoup将CSS选择器语法与便捷的API相结合,对于熟悉CSS语法的开发者而言,使用CSS选择器进行数据提取十分高效。
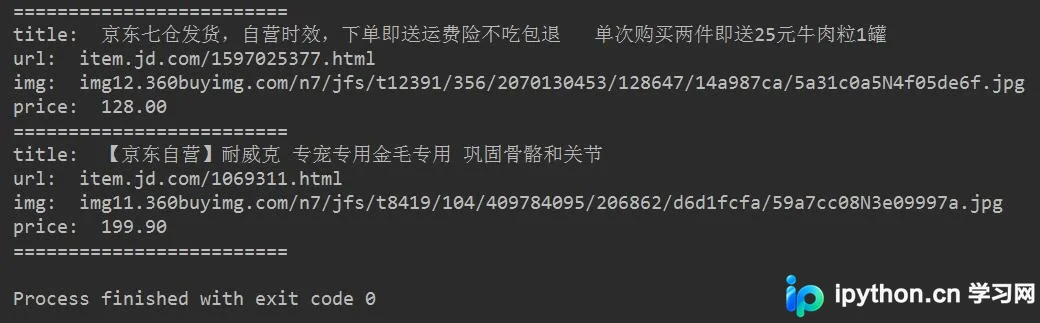
最终运行效果如下所示:
最终效果图
成功获取到最新的狗粮商品信息。
CSS选择器
关于CSS选择器的简要说明:
BeautifulSoup CSS选择器语法详解
BeautifulSoup支持大部分CSS选择器语法。使用方法为向tag对象或BeautifulSoup对象的.select()方法传入字符串参数,结果以列表形式返回,类型均为list。
tag.select("string")
BeautifulSoup.select("string")
注意:在选取具有特定CSS属性的元素时,标签名本身无需修饰,而class属性前需加“.”,id属性前需加“#”。
本文介绍了上述内容,希望能为读者的学习提供帮助,欢迎继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









