PyCharm导入Pandas包失败?完整排查与解决指南
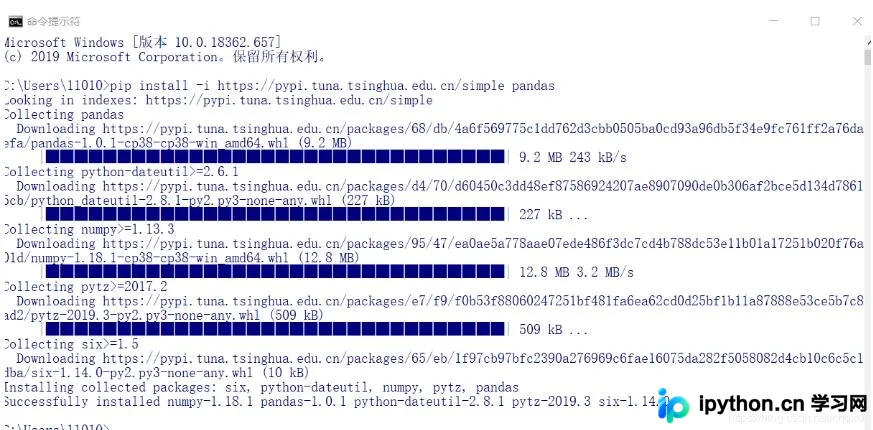
本文详细解决PyCharm中导入Pandas包失败的常见问题。涵盖通过cmd使用清华源pip加速安装、验证安装状态,以及当包未自动识别时,手动配置Project Interpreter、指定pythonw.exe路径及切换Existing environment的完整操作步骤,帮助初学者快速恢复开发环境。
2026-10-13
9

本文详细解决PyCharm中导入Pandas包失败的常见问题。涵盖通过cmd使用清华源pip加速安装、验证安装状态,以及当包未自动识别时,手动配置Project Interpreter、指定pythonw.exe路径及切换Existing environment的完整操作步骤,帮助初学者快速恢复开发环境。
本文解析PyCharm中项目文件名显示红色的常见原因,包括未纳入Git版本控制、误将文件夹设为仓库等。提供三种解决方案:通过Git提交文件、关闭版本控制关联或移除.git文件夹。此外,补充了Python中因文件名与内置模块io冲突导致open()报错及路径复制引入隐藏字符的问题及修复方法。
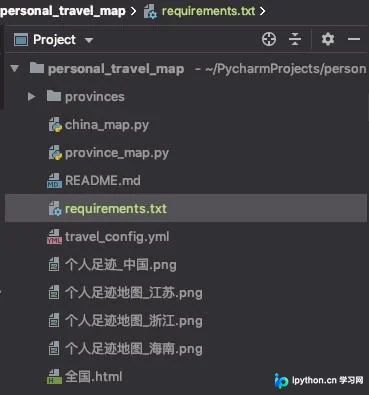
本文介绍如何利用Python和pyecharts库绘制精确到市级的个人足迹地图。通过配置YAML文件记录旅行地点,分别生成全国及各省/直辖市地图,并实现点击省份跳转至对应市级地图的交互功能,解决现有小程序仅支持省级展示的局限。
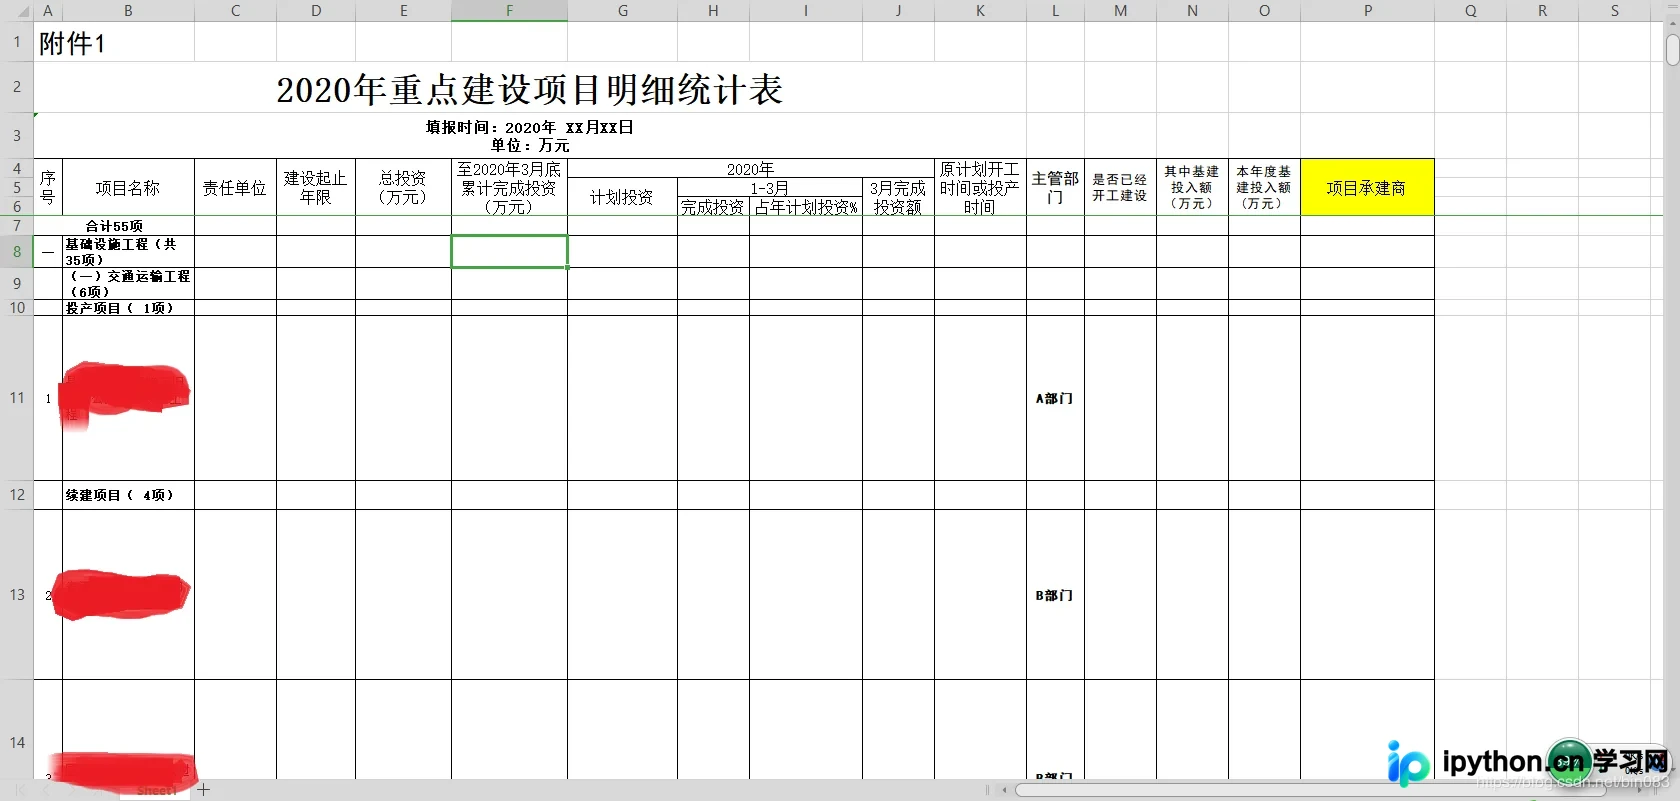
本文介绍如何利用Python的Pandas库进行数据清洗与比对,结合xlwings操作Excel文件以保留原有格式。通过对比项目行数差异并动态插入行,实现多部门Excel内容的自动化汇总,同时确保排版格式不被破坏。
本文详解使用Python实现密码验证程序的完整思路。程序需处理多行输入,对每行密码进行三项核心校验:长度必须超过8位;需包含大小写字母、数字及特殊符号中的至少三种;严禁存在长度超过2的重复子串。通过结合循环遍历与正则表达式,可有效判断密码是否符合规范并输出OK或NG结果。
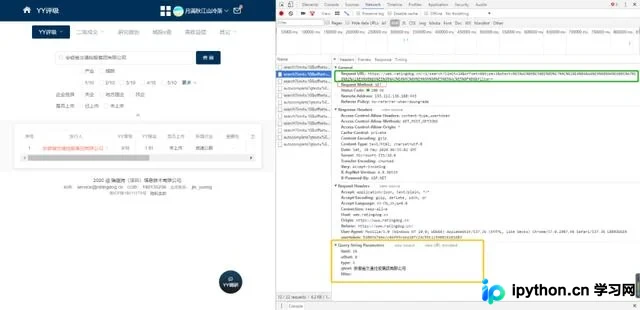
本文介绍使用Python编写爬虫批量获取YY评级分数的方法。通过解析Ajax GET请求URL规律,提取企业名称变量构建请求。重点讲解如何携带登录Cookie维持会话状态,并利用正则表达式从JSON响应中提取评级数据。最终实现将安徽省100多条发债企业数据保存至本地,适用于大规模企业评级信息查询场景。
本文解决Python启动时常见的api-ms-win-crt-process-l1-1-0.dll丢失及0xc000007b错误,提供DLL放置路径与DirectX修复工具方案。同时详解Python3中http.server模块的使用方法,包括后台运行、端口指定及nohup保持服务,助力快速搭建本地Web环境。
本文详解Python中如何在外部调用函数内部定义的嵌套函数,通过返回内部函数引用实现灵活调用。同时探讨在函数内处理列表或矩阵时,如何避免修改原数据的问题,提供字典转列表及引入numpy库两种解决方案,确保原数据结构不受影响。
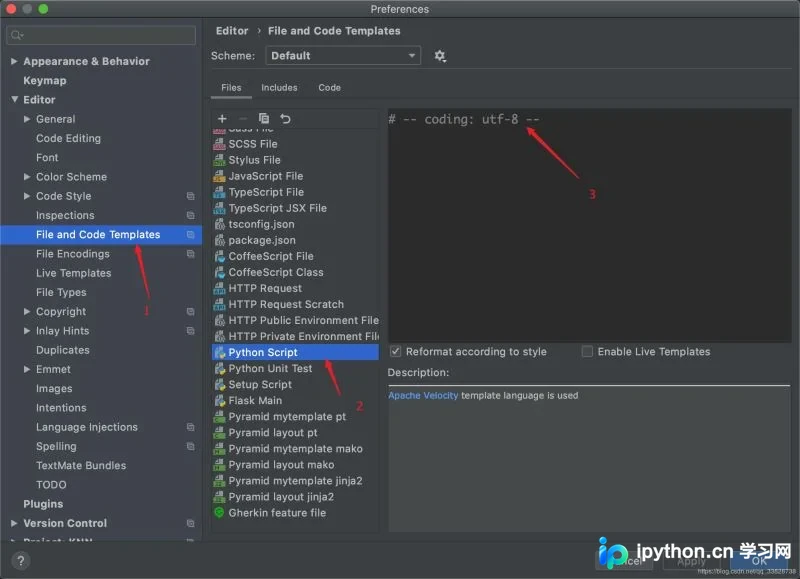
本文详细介绍如何在 PyCharm 中设置默认的 UTF-8 编码格式,避免代码因编码问题报错。同时提供两种常见的 Python 文件头部编码声明注释写法,帮助开发者规范代码格式,提升开发体验。
本文详解Python爬虫应对常见反爬策略的三种核心方案:通过维护代理IP池解决IP限制与验证码问题;利用time.sleep控制访问频率以规避限流;以及通过设置User-Agent和Referer头伪装浏览器身份。内容涵盖Requests与Urllib库的具体代码实现,帮助开发者提升爬虫稳定性。
本文解析在Python的for循环中直接调用list.remove()导致元素漏删的根本原因。由于列表长度动态变化与迭代器索引递增不同步,部分目标元素会被跳过。通过复制列表副本进行遍历和删除操作,可有效避免此问题,确保数据处理的完整性与安全性。
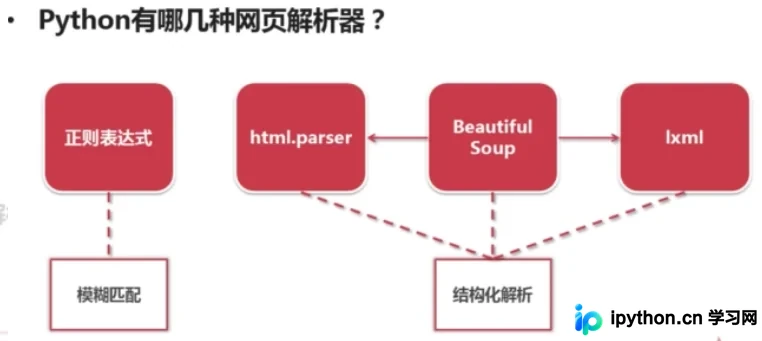
本文详解Python中常见的网页解析工具,包括正则表达式、html.parser、BeautifulSoup及lxml。重点介绍基于DOM树的结构化解析原理,并通过urllib与requests库结合BeautifulSoup的完整代码示例,展示如何获取和解析网页内容,帮助开发者快速掌握网页数据提取的核心方法。