

Python从零实现K-Means聚类算法:原理、代码与肘部法则分析

本文详细讲解如何在Python中不使用现成聚类库从零实现K-Means算法。内容涵盖算法核心原理、距离与均值计算逻辑、数据预处理及数据集划分方法。通过手动编写代码,演示如何迭代更新质点并计算训练集与测试集的SSE损失。结合肘部法则(Elbow Method),分析不同K值下的聚类效果,并通过代码示例展示如何利用SSE差值确定最优K值,适合希望深入理解聚类算法底层逻辑的开发者参考。
实验目标设定
一、实验目标
本实验旨在通过手动实现K-means模型进行聚类分析,尝试设定不同的类别数量K,并深入分析最终的聚类效果。
具体任务包括:按照8:2的比例随机将数据划分为训练集和测试集;至少尝试3个不同的K值;绘制不同K值下的聚类结果图,以及各模型在训练集和测试集上的损失曲线。通过对结果的综合讨论,找出最能解释数据分布特征的K值。
算法原理与流程
算法核心步骤如下:首先确定k值,随机选取k个初始质心点;随后所有数据点根据到各质心的距离进行初步聚类,将距离某个质点a比其他质点更近的点归入a所属的类;接着根据每一类数据点的均值更新迭代聚类中心;迭代结束后,分别计算训练集和测试集的损失函数SSE_train与SSE_test,并通过绘图进行可视化分析。
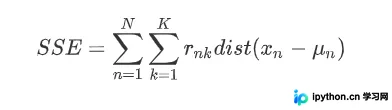
算法逻辑的伪代码描述如下:
num=10 #k的种类
for k in range(1,num):
 随机选择k个质点
 for i in range(n): #迭代n次
 根据点与质点间的距离对于X_train进行聚类
 根据mean值迭代更新质点
 计算SSE_train
 计算SSE_test
画图
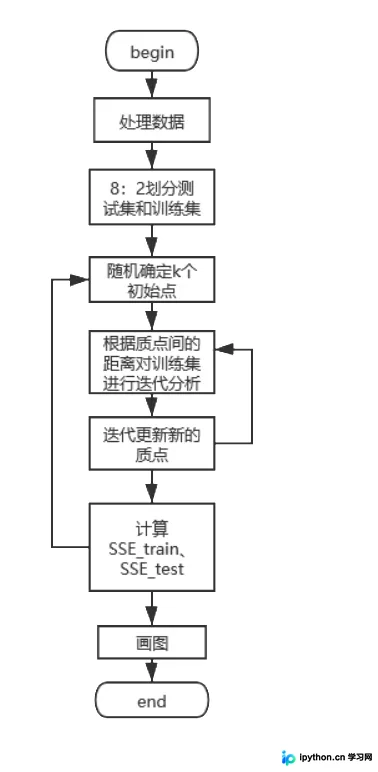
算法执行流程图如图所示:
Python代码实现细节
三、代码实现
1、导入必要的库文件
import pandas as pd
import matplotlib.pyplot as plt
import numpy as np
from sklearn.model_selection import train_test_split
2、定义计算两点间距离的函数
def distance(p1,p2):
 return np.sqrt((p1[0]-p2[0])**2+(p1[1]-p2[1])**2)
3、定义计算聚类均值的方法
def means(arr):
 return np.array([np.mean([p[0] for p in arr]),np.mean([p[1] for p in arr])])
4、处理二维数据格式
#数据处理
data= pd.read_table('cluster.dat',sep='\t',header=None)
data.columns=['x']
data['y']=None
for i in range(len(data)): #遍历每一行
 column = data['x'][i].split( ) #分开第i行,x列的数据。split()默认是以空格等符号来分割,返回一个列表
 data['x'][i]=column[0] #分割形成的列表第一个数据给x列
 data['y'][i]=column[1] #分割形成的列表第二个数据给y列
list=[]
list1=[]
for i in range(len(data)):
 list.append(float(data['x'][i]))
 list.append(float(data['y'][i]))
 list1.append(list)
 list=[]
arr=np.array(list1)
print(arr)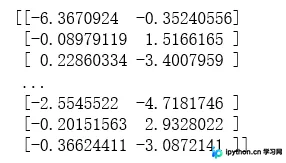
5、划分训练集与测试数据集
#按照8:2划分数据集和训练集
X_train, X_test = train_test_split(arr,test_size=0.2,random_state=1)
6、实现核心聚类逻辑
count=10 #k的种类:1、2、3...10
SSE_train=[] #训练集的SSE
SSE_test=[] #测试集的SSE
n=20 #迭代次数
for k in range(1,count):
 cla_arr=[] #聚类容器
 centroid=[] #质点
 for i in range(k):
 j=np.random.randint(0,len(X_train))
 centroid.append(list1[j])
 cla_arr.append([])
 centroids=np.array(centroid)
 cla_tmp=cla_arr #临时训练集聚类容器
 cla_tmp1=cla_arr #临时测试集聚类容器
 for i in range(n): #开始迭代
 for e in X_train: #对于训练集中的点进行聚类分析
 pi=0
 min_d=distance(e,centroids[pi])
 for j in range(k):
 if(distance(e,centroids[j])<min_d):
  min_d=distance(e,centroids[j])
  pi=j
 cla_tmp[pi].append(e) #添加点到相应的聚类容器中

 for m in range(k):
 if(n-1==i):
 break
 centroids[m]=means(cla_tmp[m])#迭代更新聚类中心
 cla_tmp[m]=[]
 dis=0
 for i in range(k):  #计算训练集的SSE_train
 for j in range(len(cla_tmp[i])):
 dis+=distance(centroids[i],cla_tmp[i][j])
 SSE_train.append(dis)

 col = ['HotPink','Aqua','Chartreuse','yellow','red','blue','green','grey','orange'] #画出对应K的散点图
 for i in range(k):
 plt.scatter([e[0] for e in cla_tmp[i]],[e[1] for e in cla_tmp[i]],color=col[i])
 plt.scatter(centroids[i][0],centroids[i][1],linewidth=3,s=300,marker='+',color='black')
 plt.show()

 for e in X_test:  #测试集根据训练集的质点进行聚类分析
 ki=0
 min_d=distance(e,centroids[ki])
 for j in range(k):
 if(distance(e,centroids[j])<min_d):
 min_d=distance(e,centroids[j])
 ki=j
 cla_tmp1[ki].append(e)
 for i in range(k):  #计算测试集的SSE_test
 for j in range(len(cla_tmp1[i])):
 dis+=distance(centroids[i],cla_tmp1[i][j])
 SSE_test.append(dis)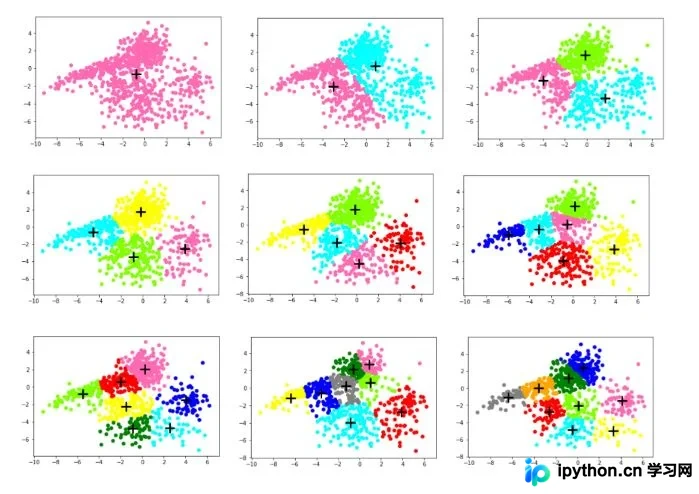
7、可视化绘图模块
SSE=[] #计算测试集与训练集SSE的差值
for i in range(len(SSE_test)):
 SSE.append(SSE_test[i]-SSE_train[i])

x=[1,2,3,4,5,6,7,8,9]
plt.figure()
plt.plot(x,SSE_train,marker='*')
plt.xlabel("K")
plt.ylabel("SSE_train")
plt.show() #画出SSE_train的图

plt.figure()
plt.plot(x,SSE_test,marker='*')
plt.xlabel("K")
plt.ylabel("SSE_test")
plt.show() #画出SSE_test的图

plt.figure()
plt.plot(x,SSE,marker='+')
plt.xlabel("K")
plt.ylabel("SSE_test-SSE_train")
plt.show() #画出SSE_test-SSE_train的图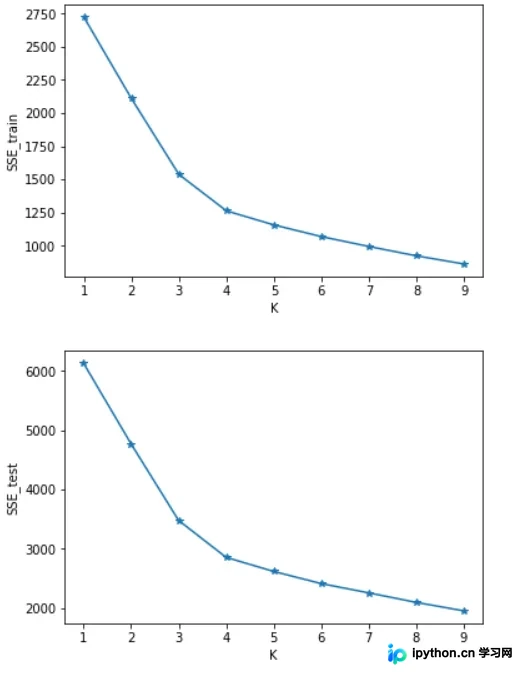
实验结果与模型评估
四、实验结果分析
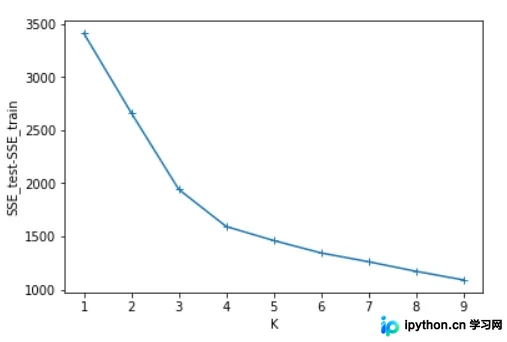
观察结果可知,SSE值随着K值的增加呈现下降趋势,且测试集与训练集的图形变化趋势基本一致。在相同的K值下,测试集的SSE通常大于训练集的SSE。为了进一步评估模型性能,我对相同K值下的SSE_test与SSE_train进行了差值计算(参考上图3),结果显示当K=4时,数据得出的结果表现最佳。本部分主要依据肘部原则(Elbow Method)来判断最优K值。需要注意的是,本文未实现轮廓系数(Silhouette Coefficient),相关参考文章链接为:https://www.jb51.net/article/187771.htm
总结
至此,关于使用Python代码手动实现K-means聚类分析(不依赖现成聚类库)的介绍已完成。如需了解更多关于Python K-means聚类分析的内容,欢迎搜索本站历史文章或继续浏览后续相关教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









