

Python爬取豆瓣评论并制作词云完整教程

本文详细介绍如何使用Python采集豆瓣电影热评并自动生成词云。流程涵盖通过requests与lxml解析目标页面、批量保存评论至JSON文件,以及利用jieba进行分词去噪后调用wordcloud渲染可视化图表。文章提供完整可执行代码、关键参数配置说明及运行避坑指南,适合希望快速掌握网络数据抓取与文本可视化技术的开发者参考。
准备环境与依赖项
实现该功能需提前安装以下Python第三方库。请注意,json属于Python标准库,无需额外下载。
命令行安装命令:pip install requests lxml jieba wordcloud
此外,wordcloud默认无字体包,若未指定有效中文字体路径,生成的词云将出现方框乱码。请确保系统目录中存在如simhei.ttf(黑体)或msyh.ttc(微软雅黑)等字体文件。
第1步:抓取豆瓣影评并持久化存储
本段代码利用requests发起HTTP请求,配合lxml.etree进行XPath解析,遍历分页URL提取评论作者与正文内容,逐行追加写入yewen.json文件中。为避免触发网站反爬限制,每次请求后加入了time.sleep(3)延时。
原始草稿中翻页URL参数格式存在笔误(缺少等号),此处已修正为正确的?start={}拼接方式:
import requests
from lxml import etree
import json
import time

class Spider(object):
    def __init__(self):
        self.headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3700.100 Safari/537.36'
        }

    def get_data(self, url):
        response = requests.get(url, headers=self.headers).content.decode('utf-8')
        page = etree.HTML(response)
        node_list = page.xpath('//div[@class="review-list  "]/div')

        for node in node_list:
            author = node.xpath('.//header[@class="main-hd"]//a[2]/text()')[0]
            text = node.xpath('string(.//div[@class="main-bd"]//div[@class="short-content"])')

            items = {'author': author, 'text': text.strip()}
            # 逐行追加模式,防止进程中断导致数据全部丢失
            with open('yewen.json', 'a', encoding='utf-8') as f:
                f.write(json.dumps(items, ensure_ascii=False) + '\n')

    def run(self):
        for i in range(1, 47):
            # 修正原始笔误,补全 start= 参数
            url = f'https://movie.douban.com/subject/26885074/reviews?start={i * 20}'
            print(f'正在爬取第{i}页')
            self.get_data(url)
            time.sleep(3)

if __name__ == '__main__':
    s = Spider()
    s.run()
第2步:清洗文本数据并渲染词云
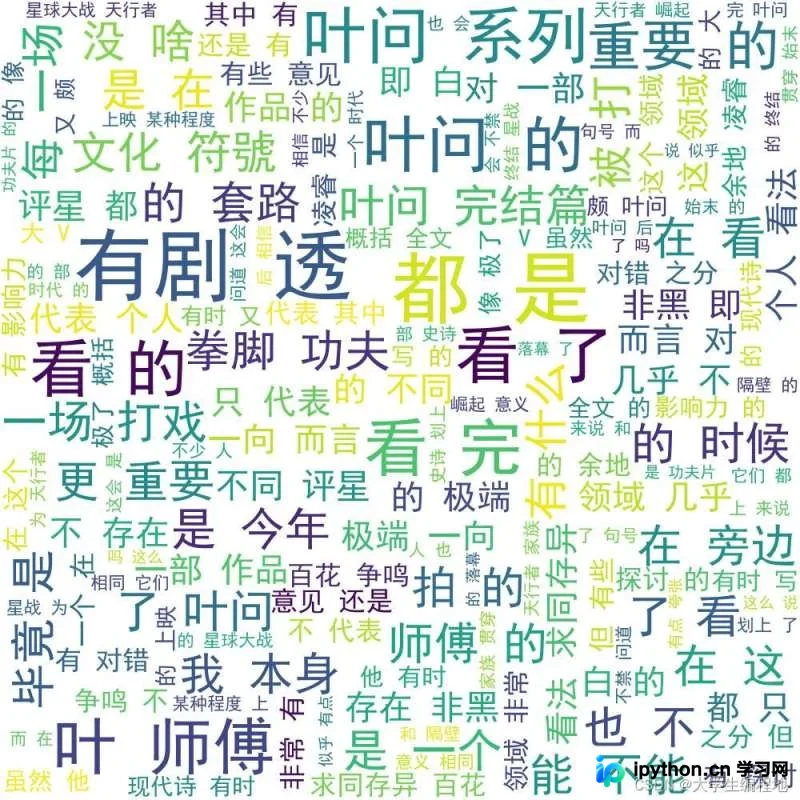
数据抓取完成后,读取JSON文件合并所有评论文本。为提高词云聚焦度,先剔除“展开”、“这篇”、“影评”、“剧情”等高频但信息量低的水印词汇,随后使用jieba进行精确模式分词。最后实例化WordCloud对象生成图像并导出为PNG文件。
import jieba
from wordcloud import WordCloud
import json

# 1. 读取并合并所有评论文本
with open("yewen.json", "r", encoding="utf-8") as f:
    data_list = f.readlines()

combined_text = ''
for data in data_list:
    try:
        text = json.loads(data)['text']
        combined_text += text
    except json.JSONDecodeError:
        continue

# 2. 替换无关紧要的词语进行降噪
noise_words = ['展开', '这篇', '影评', '电影', '这部', '可能', '剧情']
result_str = combined_text
for w in noise_words:
    result_str = result_str.replace(w, '')

# 3. 结巴分词并转为空格分隔字符串
cut_text = jieba.lcut(result_str)
final_text = " ".join(cut_text)

# 4. 配置词云属性并生成图片
wc = WordCloud(
    font_path='simhei.ttf',       # 必须指定本地有效的中文字体路径
    background_color="white",     # 背景色
    max_words=600,                # 最大显示词数
    width=1000, height=1000,      # 画布尺寸
    min_font_size=20,             # 最小字号
    max_font_size=100             # 最大字号
)

wc.generate(final_text)
wc.to_file("text.jpg")          # 保存为JPG格式
print("词云生成完毕,已保存至 text.jpg")
运行验证与常见问题排查
完成上述两步后,分别运行两个脚本即可在当前目录获得yewen.json数据源与text.jpg词云图。若在运行过程中遇到问题,可对照以下现象排查:
- 反爬拦截或获取为空:豆瓣对自动化请求较敏感。若XPath定位不到数据,说明页面结构已更新或被临时屏蔽。可尝试调高
time.sleep(3)至5~10秒,或更换代理IP池。 - 词云显示方块乱码:此问题100%由字体缺失引起。请将系统Font目录下的字体文件拷贝至代码同级目录,并在
font_path中修改对应文件名。 - 内存溢出或运行卡顿:当评论总数极大时,一次性将所有文本加载进内存可能引发开销。建议将读取逻辑改为分块读取或限制爬取页数。
以上就是Python爬取豆瓣评论制作词云的详细内容,更多关于Python数据采集与可视化处理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









