

Python实现百度贴吧帖子全楼层图片批量下载
本文提供基于Python 2.7的百度贴吧图片爬取完整代码。通过requests获取页面,利用BeautifulSoup解析img标签,结合正则表达式提取最大页码,实现自动遍历所有楼层并批量保存高清原图至本地指定目录。
2026-10-13
6

本文提供基于Python 2.7的百度贴吧图片爬取完整代码。通过requests获取页面,利用BeautifulSoup解析img标签,结合正则表达式提取最大页码,实现自动遍历所有楼层并批量保存高清原图至本地指定目录。
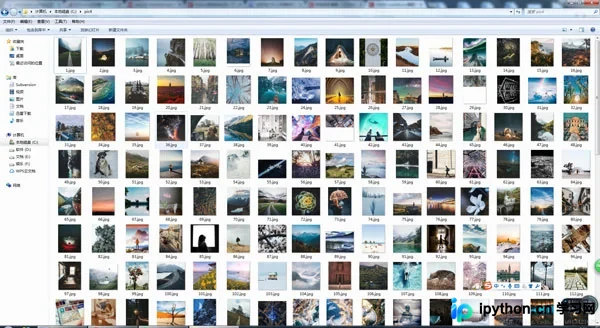
本文介绍如何使用Python3结合urllib库实现百度贴吧指定页面的数据爬取。通过解析URL中pn参数的分页规律,编写脚本批量获取HTML源码,并将结果保存为本地文本文件。教程包含完整的代码示例、URL规则分析及控制台运行效果,适合Python初学者进行网络爬虫入门实践。
本文介绍如何使用Python3结合正则表达式从内涵段子网站抓取内容。通过构造请求获取HTML源码,利用re模块匹配特定标签内的文本,清洗后保存至本地文件。代码包含分页处理、请求头设置及文件写入逻辑,适合初学者理解爬虫基础流程。
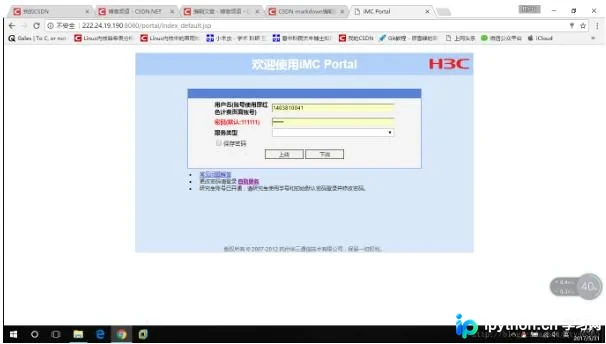
本文介绍如何利用Python爬虫技术解决校园网频繁掉线问题。通过Firefox浏览器抓包获取登录接口、参数及Header信息,结合requests库编写自动登录脚本。脚本包含死循环检测网络状态,断网时自动重新提交POST请求,并可打包为exe实现开机自启,无需手动操作。
本文详细介绍使用Python获取酷狗音乐TOP500榜单中歌曲MP3格式下载地址的方法,提供完整代码示例。针对部分页面规律失效导致无法完整爬取的问题,文章提供了转向爬取酷狗飙升榜100首的替代方案,包含API请求与网页解析两种实现路径,帮助开发者解决数据抓取中的跳转与完整性难题。
本文介绍Python网络爬虫的三种常见网页抓取方法:正则表达式、Beautiful Soup和Lxml。重点对比了各模块的性能与适用场景,指出Lxml因基于C语言实现而兼具速度与健壮性。文章提供了Lxml及其依赖模块cssselect的详细安装命令,并附带完整的Python代码示例,演示如何利用urllib和lxml下载网页、解析HTML并批量保存图片。
本文系统梳理Python爬虫工程师面试中的核心问题,涵盖if __name__机制、Python内存管理(引用计数与垃圾回收)、对象拷贝差异、异常处理、常用爬虫库对比及反爬应对方案。深入解析Django与Flask选型、多线程异步优化、POST/GET区别及Lambda表达式,为求职者提供实用的技术参考。
本文汇总了基于Python3抓取多种非HTML文档的方法。涵盖TXT文件的正则检索、CSV文件的远程读取与字典解析、利用pdfminer3k提取PDF文本,以及通过解压DOCX文件并解析XML获取Word内容。文章提供具体代码示例,解决编码、远程加载及格式转换等常见问题,辅助开发者完善数据采集能力。
本文详细介绍在 CentOS 7 系统中编译安装 Python 3.5.5 及 Scrapy 框架的完整步骤。内容涵盖开发工具依赖安装、Python 源码编译、软链接配置以及 Scrapy 的安装与验证,确保在不破坏系统原有 Python 2.7 的前提下完成环境搭建。
本文详解Python读取.docx文件正文信息的原理。.docx本质是包含XML的ZIP压缩包,正文存储于word/document.xml中。通过Python解压文件并解析该XML,可提取文本内容。文中提供基于ZipFile和BeautifulSoup的完整代码示例,展示如何遍历并打印文档正文。
本文汇总Python爬虫及后端开发常见面试题,深入解析线程与网络的同步异步机制、顺序表与链表的优劣对比。详细阐述Redis的五种数据结构及其命令,以及MySQL中InnoDB与Memory引擎的适用场景,帮助开发者应对技术面试。
本文详细介绍如何利用Python的Requests库获取网页源码,并结合BeautifulSoup解析HTML结构以提取表格数据。通过定义检查链接、获取内容及保存文件三个核心函数,实现将网页中的表格信息清洗后写入本地CSV文件的完整流程,适合初学者参考学习。