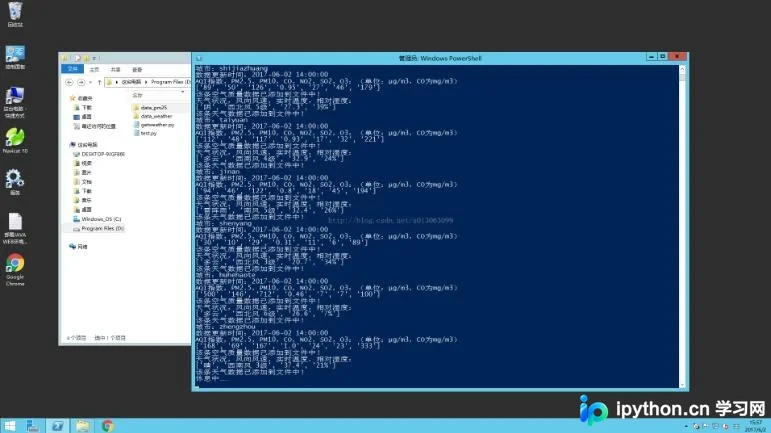
Python3实现北京及周边城市空气质量与天气数据定时爬取
本文介绍使用Python3编写爬虫程序,定期抓取北京及周边省会城市的PM2.5和天气数据。文章详细记录了在爬取过程中遇到的UnicodeDecodeError编码错误,并通过修改解码方式为gbk解决。此外,针对服务器运行时的异常中断问题,增加了URLError异常处理与重试机制,确保数据连续采集。
2026-10-13
8

本文介绍使用Python3编写爬虫程序,定期抓取北京及周边省会城市的PM2.5和天气数据。文章详细记录了在爬取过程中遇到的UnicodeDecodeError编码错误,并通过修改解码方式为gbk解决。此外,针对服务器运行时的异常中断问题,增加了URLError异常处理与重试机制,确保数据连续采集。
本文详解Python即时网络爬虫项目的启动背景,作者从C++转向Python的考量,以及“即时”在系统部署、数据流和模块集成层面的定义。项目旨在通过模块化提取器解决80%的数据抓取工作量,实现快速部署与批量数据收割。
本文介绍使用Python爬取最好大学网大学排名的具体代码。通过requests获取HTML,利用BeautifulSoup解析表格数据,并将排名、学校名称及总分等信息格式化输出,供学习者参考。
本文介绍使用Python抓取多页天涯论坛帖子的实战技巧。重点解析BeautifulSoup中find_all与select的选择器差异,演示如何利用zip函数合并作者与内容数据,并构建双层URL结构实现分页抓取,同时探讨多属性筛选的可行性。
本文详细解析使用Python3爬取淘宝商品信息的完整代码流程。通过requests获取网页源码,利用正则表达式精准提取价格、名称、地址及图片链接,并展示如何遍历多页数据并格式化输出结果。代码包含异常处理机制,适合初学者理解网络爬虫的基本逻辑与实现细节。
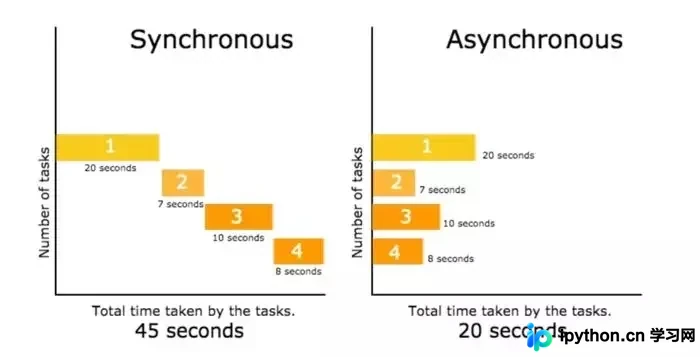
本文详解Python爬虫中同步与异步的区别,对比requests与aiohttp库的使用。重点介绍gevent库通过Greenlet实现轻量级协程的原理,以及利用猴子补丁将阻塞式requests转换为异步的方法。包含有道词典爬取实战、高并发下的限流策略及列表分批处理代码示例,帮助开发者提升爬虫效率。
本文详解Python3爬虫模拟登录的核心技术。通过前端审查元素定位加密逻辑,介绍Base64、手动模拟及PyExecJS调用JS三种加密还原方案。针对图片验证码,探讨本地存储与第三方识别模块的应用。最后演示如何构造Headers、处理Session/Cookie并发送POST/GET请求,实现完整登录流程。
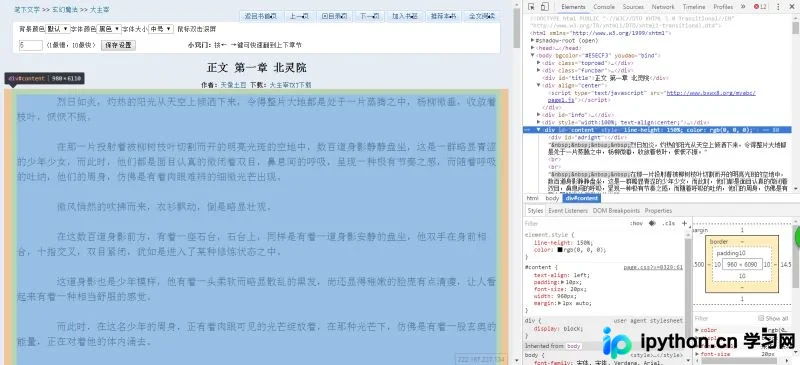
本文分享使用Python抓取网络小说的完整代码与思路。针对网页编码(如GBK与gb18030)导致的解码错误提供解决方案,利用BeautifulSoup提取标题、正文及下一章链接,实现自动循环抓取。代码包含主函数、URL解析及文件写入逻辑,最终生成适合Kindle导入的TXT文本,并建议配合epubBuilder进行二次排版以优化阅读体验。
本文详细介绍如何利用Python编写酷狗音乐无损搜索引擎。通过抓包分析搜索与下载接口,解析Hash加密机制,结合Flask框架搭建前后端系统。文章提供完整代码实现,涵盖请求模块、搜索逻辑及高音质下载策略,供技术学习与参考。
本文提供使用Python抓取网页中静态图片的完整代码示例。通过BeautifulSoup解析HTML结构,利用urllib库发起网络请求,筛选特定class的图片标签并批量下载保存。代码包含图片地址提取、文件写入及简单的延时控制,适合Python初学者参考学习网页数据抓取技术。
本文详解Python中正则表达式(re模块)的使用流程,涵盖compile、search与findall方法及Match对象的应用。通过固话匹配示例解析可选字符处理,进而演示结合requests模块提取网页中所有HTTP/HTTPS链接。最后介绍如何利用正则匹配图片后缀并配合os模块实现批量下载存储,提供从理论到实战的完整代码逻辑。
本文详解使用Python爬取拉勾网职位数据的全过程。通过分析Network请求定位positionAjax接口,解决反爬拦截问题,利用requests库构造Header与参数获取JSON数据,并使用pymysql将结果存入MySQL数据库。文章提供了完整的代码逻辑与配置示例,适用于求职数据分析与职业规划参考。