

Python3实现Pixabay图片爬虫下载教程

发布时间:2026-10-13| 6人浏览过
本文详细介绍如何使用Python3编写爬虫程序,从Pixabay网站批量下载图片。通过解析网页源码,利用正则表达式匹配包含cdn.pixabay.com/photo/的.jpg链接,并结合requests与BeautifulSoup库实现自动化下载。代码包含超时处理、文件夹自动创建及异常捕获机制,适合Python初学者参考学习。
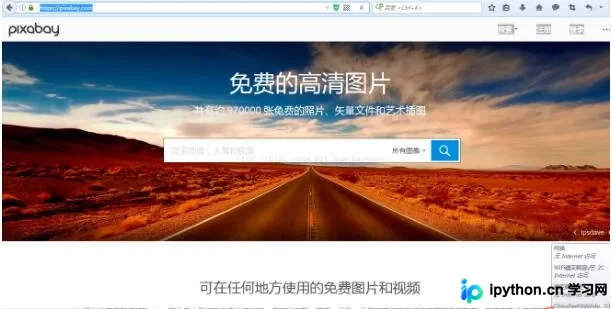
一、选取网址进行爬虫
本次演示选取Pixabay图片网站作为目标源。
url=https://pixabay.com/
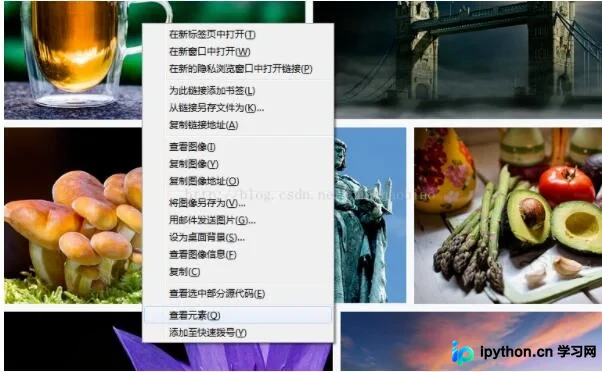
二、选择图片右键选择查看元素来寻找图片链接的规则
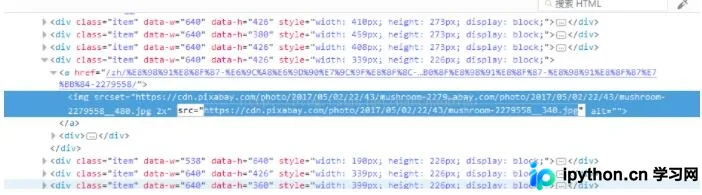
通过检查多个图片路径,我们发现所有目标src属性均包含公共前缀https://cdn.pixabay.com/photo/,且图片格式统一为.jpg。因此,构建的正则表达式为。
re.compile(r'^https://cdn.pixabay.com/photo/.*?jpg$')
基于上述分析,我们可以开始编写具体的程序代码。
#-*- coding:utf-8 -*-
import re
import requests
import os
from bs4 import BeautifulSoup

url = 'https://pixabay.com/'
html = requests.get(url).text #获取网页内容
print(html)
# 这里由于有些图片可能存在网址打不开的情况,加个5秒超时控制。
#data-objurl="http://pic38.nipic.com/20140218/17995031_091821599000_2.jpg"获取这种类型链接
soup = BeautifulSoup(html,'html.parser',from_encoding='utf-8')
#^abc.*?qwe$
pic_url = soup.find_all('img',src=re.compile(r'^https://cdn.pixabay.com/photo/.*?jpg$'))
#pic_url = pic_node.get_text()
#pic_url = re.findall('"https://cdn.pixabay.com/photo/""(.*?)",',html,re.S)
print(pic_url)
i = 0
#判断image文件夹是否存在,不存在则创建
if not os.path.exists('image'):
 os.makedirs('image')
for url in pic_url:
 img = url['src']
 try:
 pic = requests.get(img,timeout=5) #超时异常判断 5秒超时
 except requests.exceptions.ConnectionError:
 print('当前图片无法下载')
 continue
 file_name = "image/"+str(i)+".jpg" #拼接图片名
 print(file_name)
 #将图片存入本地
 fp = open(file_name,'wb')
 fp.write(pic.content) #写入图片
 fp.close()
 i+=1
代码逻辑是否清晰?若需修改地址以爬取其他网站,请务必分析目标图片路径的共性,并设计合理的正则表达式,否则无法准确获取图片链接。
执行过程截图:
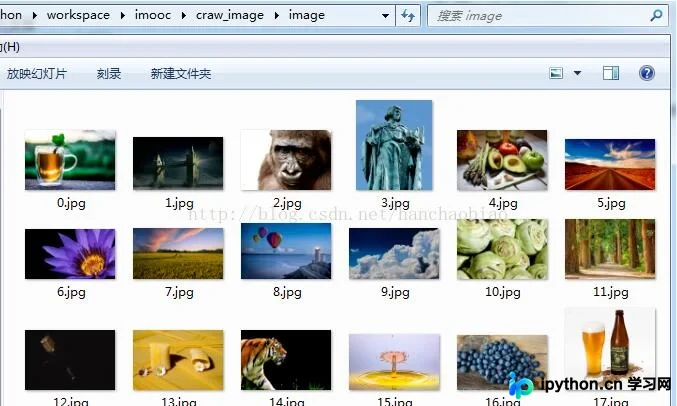
以上这篇Python3.x爬虫下载网页图片的实例讲解就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









