

Python实现有道在线翻译爬虫:绕过反爬机制与代码详解

本文详解如何使用Python编写有道在线翻译小程序。针对有道反爬机制,重点讲解User-Agent伪装、Referer设置及data参数构造(含salt与sign生成)。提供完整Python代码,涵盖urllib、json、time及hashlib模块的应用,并分析运行结果,帮助开发者解决旧版教程失效问题。
Python有道翻译爬虫开发背景
本次博客分享基于有道在线翻译接口开发实时翻译小程序的经验。该任务参考了小甲鱼所著《零基础入门学习Python》一书,但书中提供的代码因有道词典接口更新已无法直接使用。经过网络资料检索与调试,成功解决了翻译功能失效的问题,现将解决方案整理如下。
前置准备工作与反爬机制应对
2、前置工作
1)有道在线翻译设有反爬虫机制,因此程序必须模拟浏览器行为。通过Python的request模块设置headers参数,可将程序访问伪装为正常浏览器请求。添加headers参数主要有两种方式,本文采用通过add_header()方法向Request对象追加headers参数的方案。
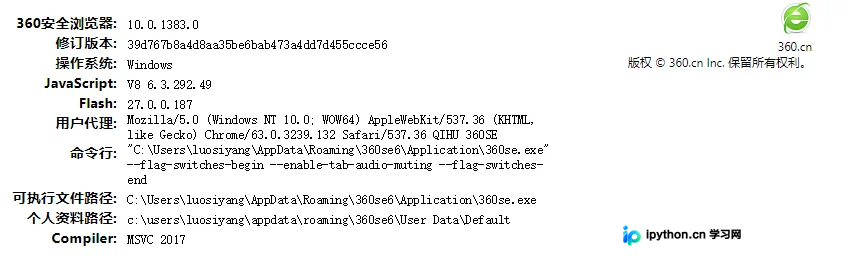
2)以360浏览器为例,获取User-Agent的方法是在地址栏输入about:version即可查看,具体结果参考下图:
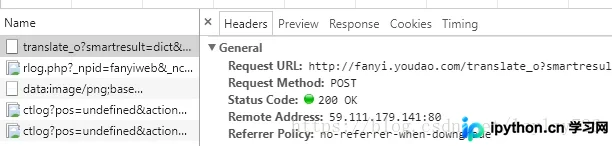
3) 获取参数后,还需提取有道翻译的data数据。首先打开有道翻译页面,启用浏览器审查元素功能,切换到Network标签页。在翻译框输入任意词汇并点击翻译,随后在请求列表中找到对应的请求项,位置如下图所示:
4)向下滚动列表即可找到data参数,编程时的数据构造需严格参照此处格式,具体配置见下图:
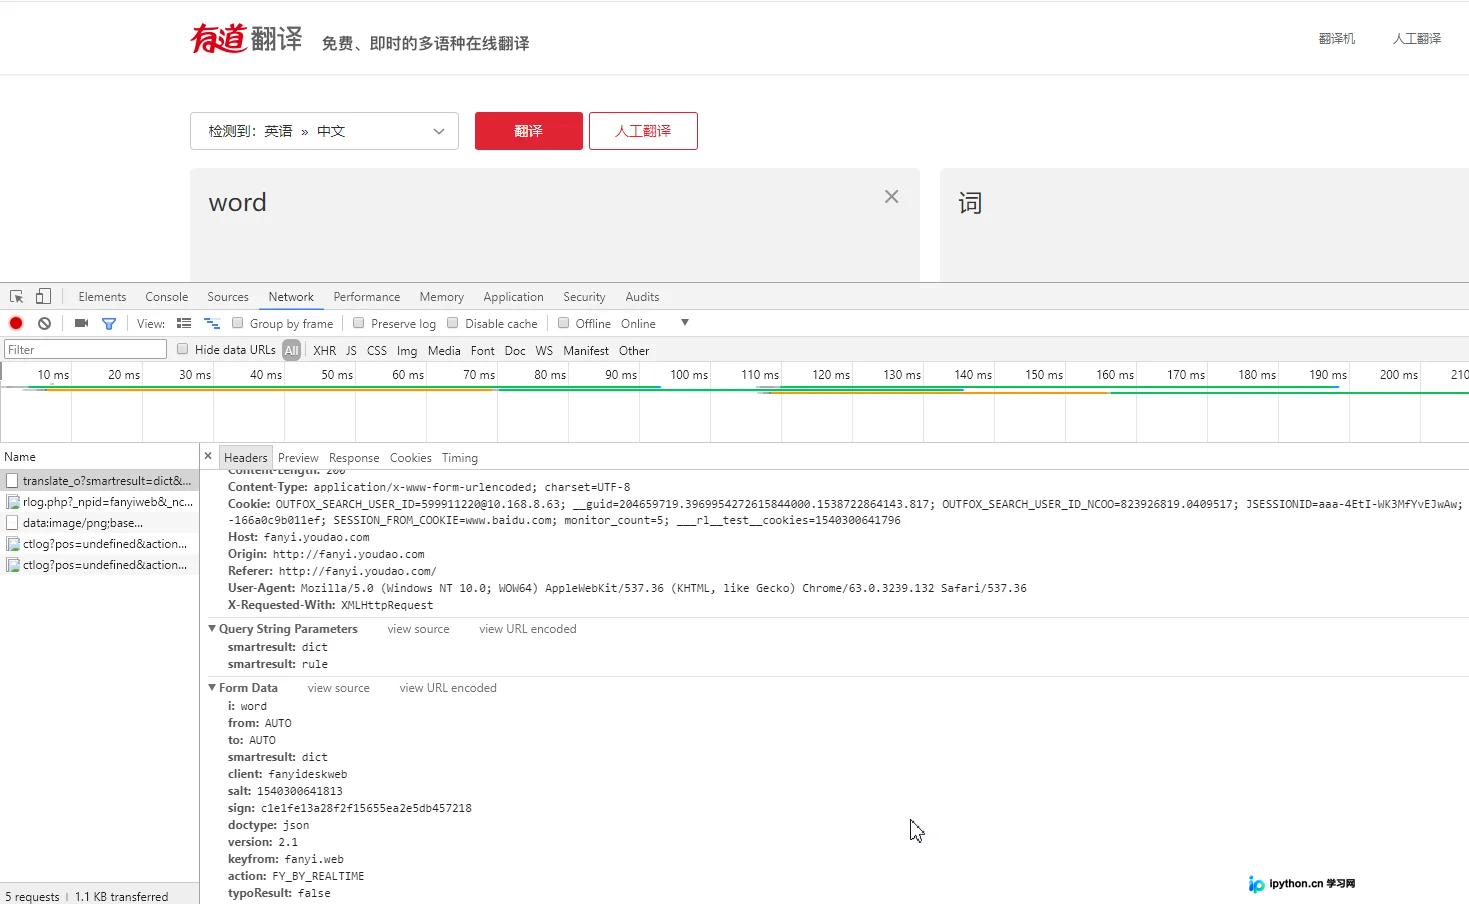
此外,headers中所需的Referer及User-Agent字段也可在上述图片中直接获取。
核心代码实现与模块解析
3、任务代码
程序编写涉及多个Python标准库,主要包括urllib、json、time等模块。
urllib已在上一篇博客中介绍,它是一个高级Web交互库,核心功能是模拟Web浏览器等客户端发起资源请求,并返回类文件对象。
json是一种轻量级数据交换格式,便于阅读与编写。程序中需使用json.loads函数对返回的json数据进行解码处理。
time模块用于获取当前时间戳及控制数据提交的延迟。虽然增加延迟会降低运行效率,但能有效降低IP地址被网站屏蔽的风险。
具体实现代码如下所示:
import urllib.request #导入urllib.request库
import urllib.parse #导入urllib.parse库
import json #导入json库
import time #导入time库
import random #导入random库
import hashlib #导入hashlib库
url = "http://fanyi.youdao.com/translate_o?smartresult=dict&smartresult=rule" #有道翻译的网址
while True: #定义死循环
 fanyi = input("请输入想要翻译的内容:") #用户输入想要翻译的内容
 #设置API接口
 a = 'fanyideskweb'   #设置client
 b = fanyi    #需要翻译的内容
 c = str(int(time.time() * 1000)+ random.randint(1, 10)) #当前时间戳
 d = 'rY0D^0\'nM0}g5Mm1z%1G4'   #加密字符
 sign = hashlib.md5((a +b +c + d).encode('utf - 8')).hexdigest() #根据内容进行md5加密
 #设置data,按照网页审查元素设置即可
 data = {}
 data['i'] = fanyi
 data['from'] = 'AUTO'
 data['to'] = 'AUTO'
 data['smartresult'] = 'dict'
 data['client'] = 'fanyideskweb'
 data['salt'] = c
 data['sign'] = sign
 data['doctype'] = 'json'
 data['version'] = '2.1'
 data['keyform'] = 'fanyi.web'
 data['action'] = 'FY_BY_CLICKBUTTION'
 data['typoResult'] = 'true'
 data = urllib.parse.urlencode(data).encode('utf - 8') #urlencode转换data数据并编码为utf-8码
 req = urllib.request.Request(url, data)  #指定网页,包含url、data和head
 #伪造浏览器访问
 req.add_header('Referer','http://fanyi.youdao.com')
 req.add_header('User - Agent','Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 QIHU 360SE')
 response = urllib.request.urlopen(req)  #post方式打开指定网页
 html = response.read()   #读取网页信息
 html = html.decode('utf - 8')  #将utf-8码解码为unicode码
 target = json.loads(html)   #把json页面转换为一个字典
 print("翻译结果: %s" % (target['translateResult'][0][0]['tgt'])) #输出
 time.sleep(5) #延迟提交数据
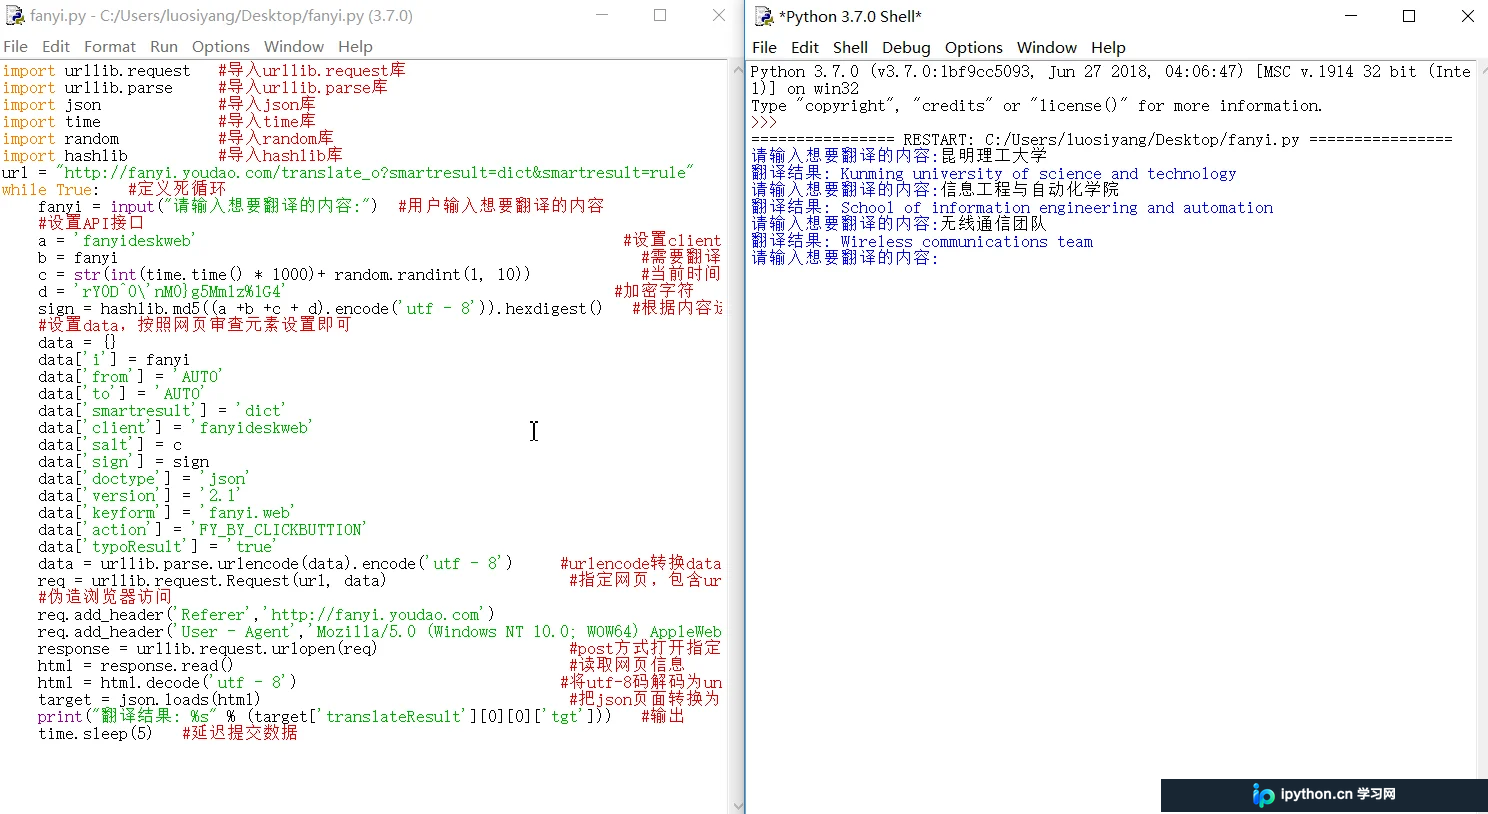
程序运行结果如下图所示:
开发总结与心得
4、总结
书本知识需通过实际编码验证。动手实践至关重要,本次翻译小程序的开发因原书代码失效,促使我通过网络查阅资料解决技术难题,在此过程中积累了宝贵经验。希望读者能以此为鉴,持续精进技术。
以上就是本文的全部内容,希望对大家的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









