

Python Scrapy实战:构建电影数据爬虫项目
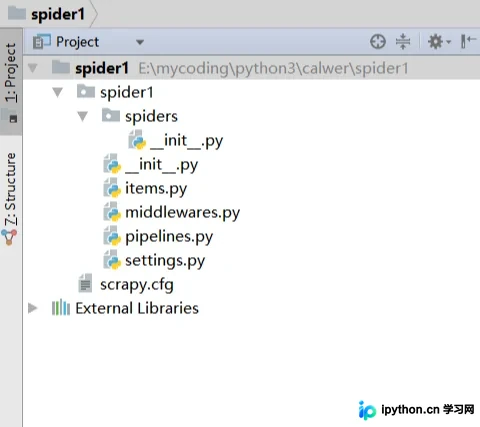
本文详细讲解如何利用Python Scrapy框架搭建电影数据爬虫。内容涵盖项目初始化命令、核心文件功能解析、Spider类的定义规范(包括name、allowed_domains等属性),以及通过XPath提取电影名称与评分的具体代码实现,帮助开发者快速掌握Scrapy基础用法。
2026-10-12
6

本文详细讲解如何利用Python Scrapy框架搭建电影数据爬虫。内容涵盖项目初始化命令、核心文件功能解析、Spider类的定义规范(包括name、allowed_domains等属性),以及通过XPath提取电影名称与评分的具体代码实现,帮助开发者快速掌握Scrapy基础用法。
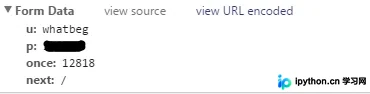
本文详细解析如何使用Python的requests.Session实现网站模拟登录。通过V2EX网站的登录流程为例,演示如何利用BeautifulSoup解析HTML获取动态参数(如once值),构建POST请求数据,并利用Session对象跨请求保持Cookie状态,最终验证登录成功。
本文详解Python爬取动态网页的两种主流方案:Dryscrape与Selenium。重点讲解Selenium在Ubuntu下的安装步骤,包括geckodriver的下载与路径配置,以及解决Firefox版本兼容性问题。通过代码示例演示如何调用浏览器引擎获取JS执行后的页面源码,并解决常见报错,如模块调用错误及元素定位方法。
本文详解Python爬虫中requests库发送POST请求的三种核心方式:Form表单、JSON数据及文件上传。通过httpbin.org测试接口,展示data与files参数的具体用法、Content-Type头部的自动处理及返回结果解析,帮助开发者掌握不同场景下的数据提交技巧。
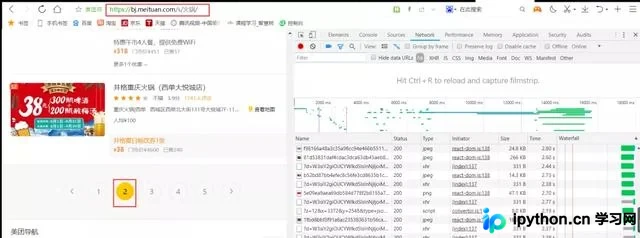
本文详解如何使用Python爬取美团美食数据。通过分析北京火锅搜索的URL结构,利用F12开发者工具定位Ajax异步加载的JSON接口。重点解析offset、limit等分页参数规律,构造请求循环抓取多页数据,并保存为本地文本文件,提供完整的代码实现与注意事项。
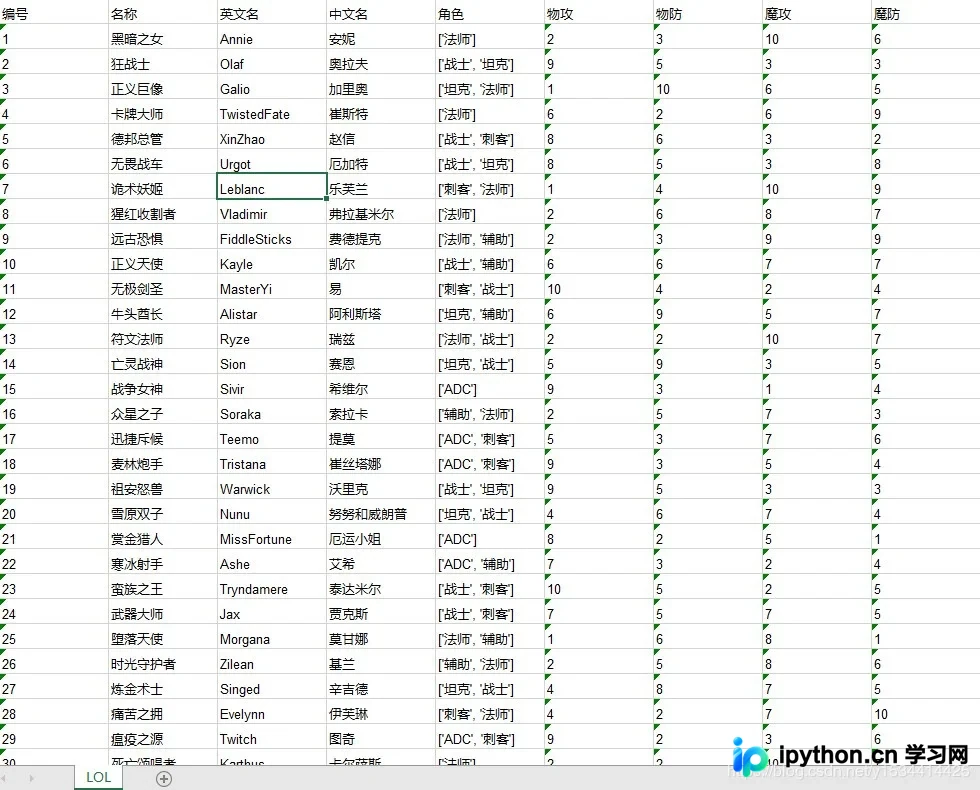
本文介绍使用Python批量获取英雄联盟英雄属性并生成Excel,以及下载所有英雄皮肤图片的完整流程。通过requests获取接口数据,利用xlwt处理表格写入,并结合IO流实现图片本地存储,提供可直接运行的示例代码供参考。
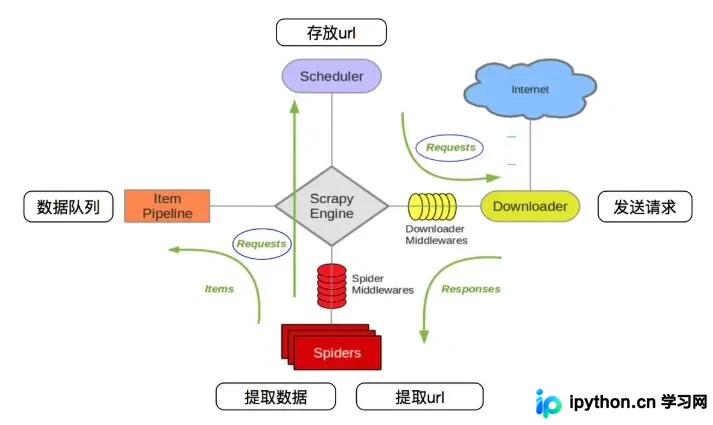
本文详解如何使用Scrapy框架通过携带Cookie的方式访问淘宝购物车。文章介绍了Scrapy架构,对比了三种登录方式,重点演示了手动提取Cookie并重写start_requests方法的过程。通过具体代码示例,展示了如何绕过登录验证获取购物车页面源码,为后续数据提取奠定基础。
本文详细介绍如何利用Python3的urllib库编写爬虫程序,从百度贴吧页面中提取邮箱地址和QQ号码。内容涵盖基础抓取代码逻辑、正则表达式匹配技巧,以及重点解析如何配置HTTP代理(Proxy)以规避访问限制。通过实例代码演示全局Opener设置与局部调用的区别,帮助开发者掌握更灵活的代理控制方法,提升爬虫稳定性。
本文详细解析Python网络爬虫的基本工作原理及系统架构。从发起请求、获取响应、解析内容到保存数据四个步骤阐述抓取流程,并深入剖析调度器、URL管理器、下载器、解析器及存储器五大核心模块的功能与协作机制,旨在帮助开发者构建高效、模块化的爬虫系统。

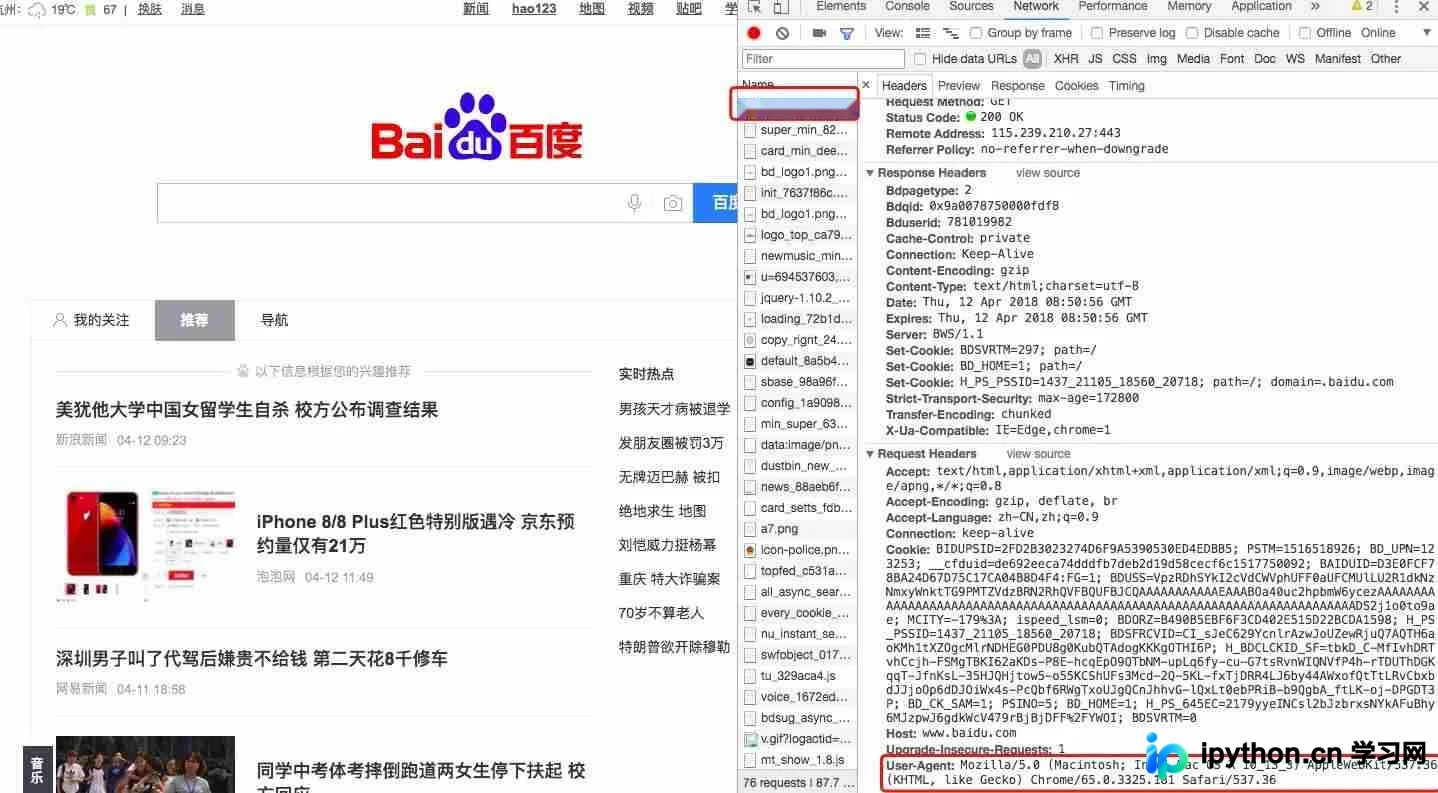
本文介绍如何利用Python的requests库通过伪装浏览器User-Agent来绕过网站的反爬机制。通过模拟真实浏览器的请求头(如Accept、Connection等),并随机切换User-Agent,可以有效防止IP被封禁,提高爬虫的稳定性和成功率。
本文解决Python3中使用xlwt追加写入Excel时原有格式丢失的问题。通过引入xlutils库,利用formatting_info=True参数打开工作簿并拷贝对象,可在保留原Excel样式的前提下追加数据。文章提供了完整的爬虫维护代码示例及关键写入逻辑,帮助开发者避免格式被覆盖的常见坑点。
本文提供三个Python爬虫项目实例,分别演示如何抓取内涵段子、智联招聘职位信息及贴吧帖子内容。代码涵盖URL构建、请求头设置、正则解析及文件写入等核心步骤,适合Python初学者参考学习。