

Windows 7 下 Python 3.5 安装 Scrapy 的解决方案
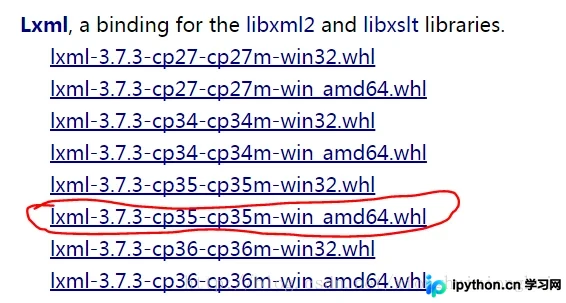
本文介绍在Windows 7系统中使用Python 3.5安装Scrapy时,如何解决“Unable to find vcvarsall.bat”编译错误。通过推荐下载lxml和Twisted的wheel文件并手动安装,避免安装Visual Studio 2015,从而简化部署流程。
2026-10-13
5

本文介绍在Windows 7系统中使用Python 3.5安装Scrapy时,如何解决“Unable to find vcvarsall.bat”编译错误。通过推荐下载lxml和Twisted的wheel文件并手动安装,避免安装Visual Studio 2015,从而简化部署流程。
本文系统梳理Scrapy框架的五大核心命令行操作,涵盖从项目初始化、Spider文件生成到程序执行及交互式调试的完整流程。详细解析scrapy startproject、genspider、crawl及shell等关键指令的语法结构与使用场景,帮助开发者快速掌握Scrapy基础工作流,提升爬虫开发与调试效率。
针对Python内置网络库的调用场景,提供网页抓取的标准实现方案。涵盖基础响应获取、自定义Request参数、全局代理注入、Cookie状态维持以及重定向追踪等核心操作。通过结构化的函数封装与错误捕获机制,解决常规HTTP交互中的断连、封禁与会话丢失问题,助力自动化数据采集流程的稳定运行。