Python爬虫利用cookie实现模拟登录实例详解
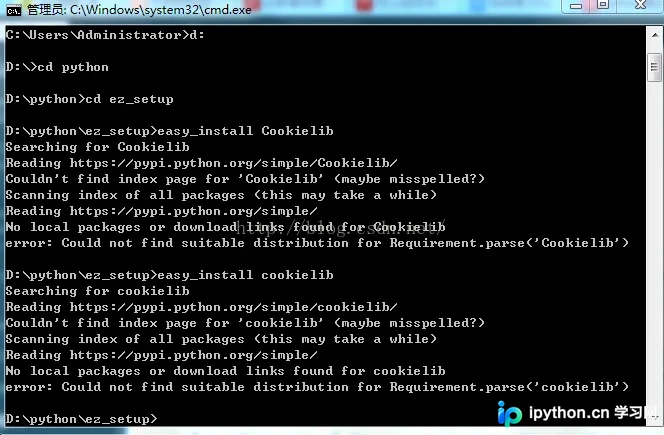
本文详解Python爬虫中利用cookielib模块实现模拟登录的方法。通过构建CookieJar及子类MozillaCookieJar,结合urllib2的build_opener,可自动捕获并保存网站Cookie。文章涵盖从获取Cookie、保存到文件(cookie.txt)再到读取Cookie访问受限页面的完整流程,帮助开发者突破游客限制,高效抓取目标网页数据。
2026-10-13
6

本文详解Python爬虫中利用cookielib模块实现模拟登录的方法。通过构建CookieJar及子类MozillaCookieJar,结合urllib2的build_opener,可自动捕获并保存网站Cookie。文章涵盖从获取Cookie、保存到文件(cookie.txt)再到读取Cookie访问受限页面的完整流程,帮助开发者突破游客限制,高效抓取目标网页数据。
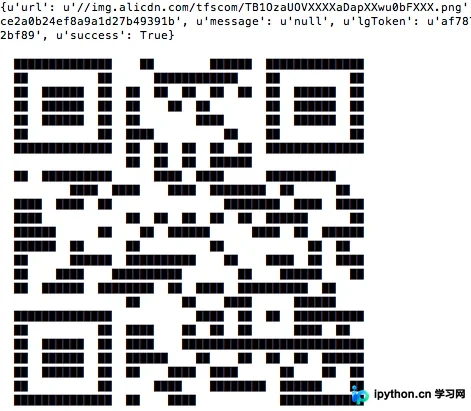
本文介绍使用Python实现淘宝联盟数据抓取的自动登录方案。通过调用淘宝二维码接口实现扫码登录,解决验证码问题。利用Requests库的Session机制结合pickle序列化,实现Cookie的异步存储与读取,确保会话状态持久化。文章提供了核心代码逻辑,并探讨了Session过期后自动刷新票据的难点与思路。
本文介绍利用Python脚本检测微信好友是否删除自己的方法。通过模拟登录微信网页版接口,获取通讯录列表并与发送消息后的状态码比对,判断好友关系。代码包含登录流程、二维码获取及好友列表解析,供技术参考。
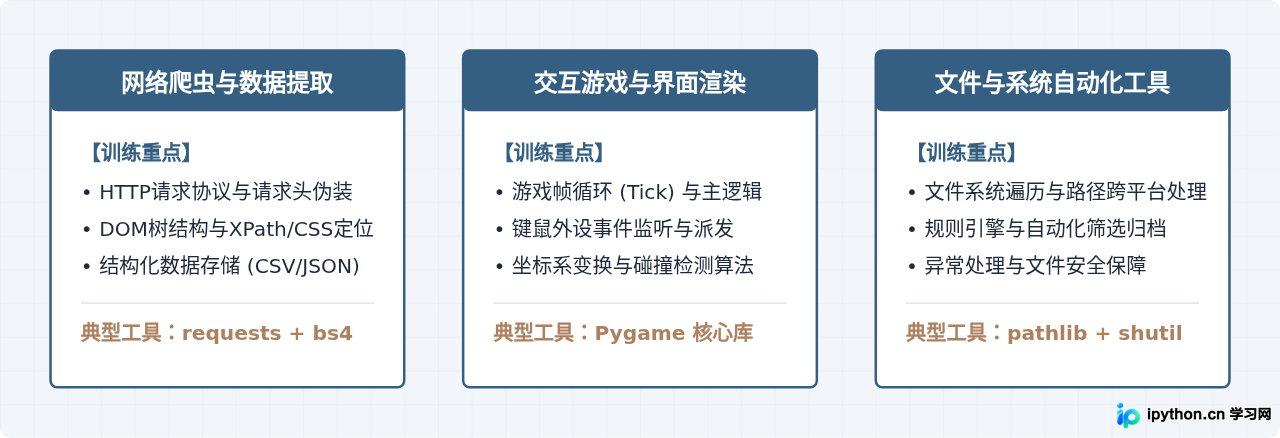
精选爬虫、游戏与自动化三大方向的Python入门练手项目源码,包含完整的实现逻辑、代码注释、运行验证与踩坑说明,帮助读者快速掌握实际开发技能。
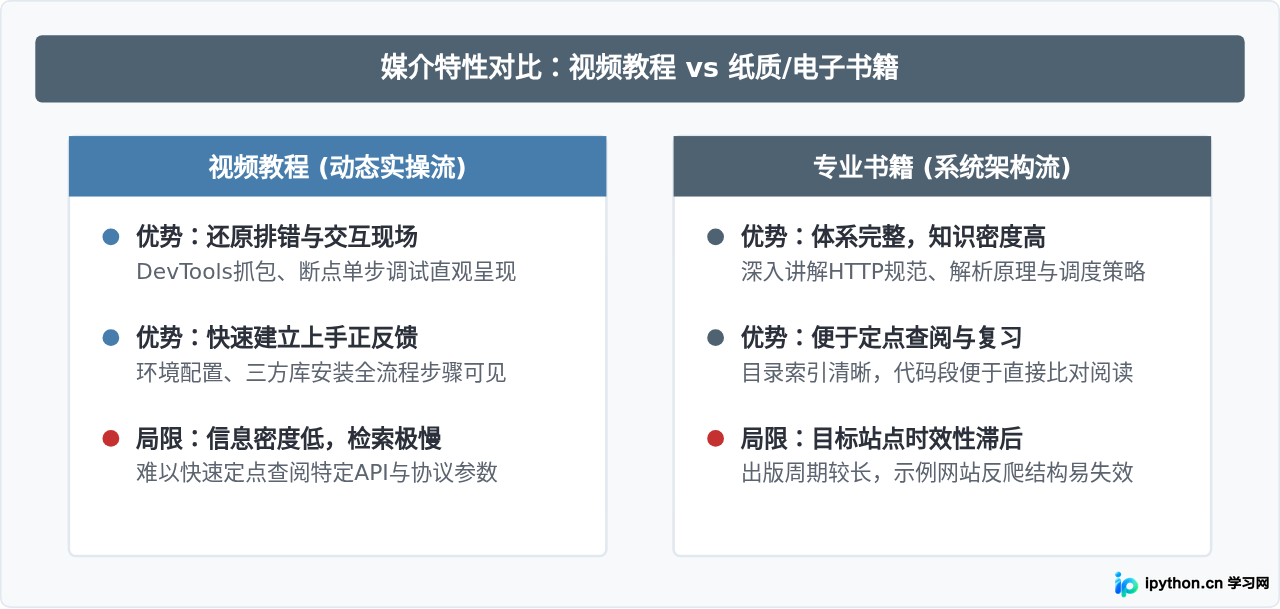
针对自学Python爬虫时买书与看视频的优劣势对比,提供阶段性搭配策略、筛选标准与避坑指南,帮助初学者高效选择适合自己的学习资料。
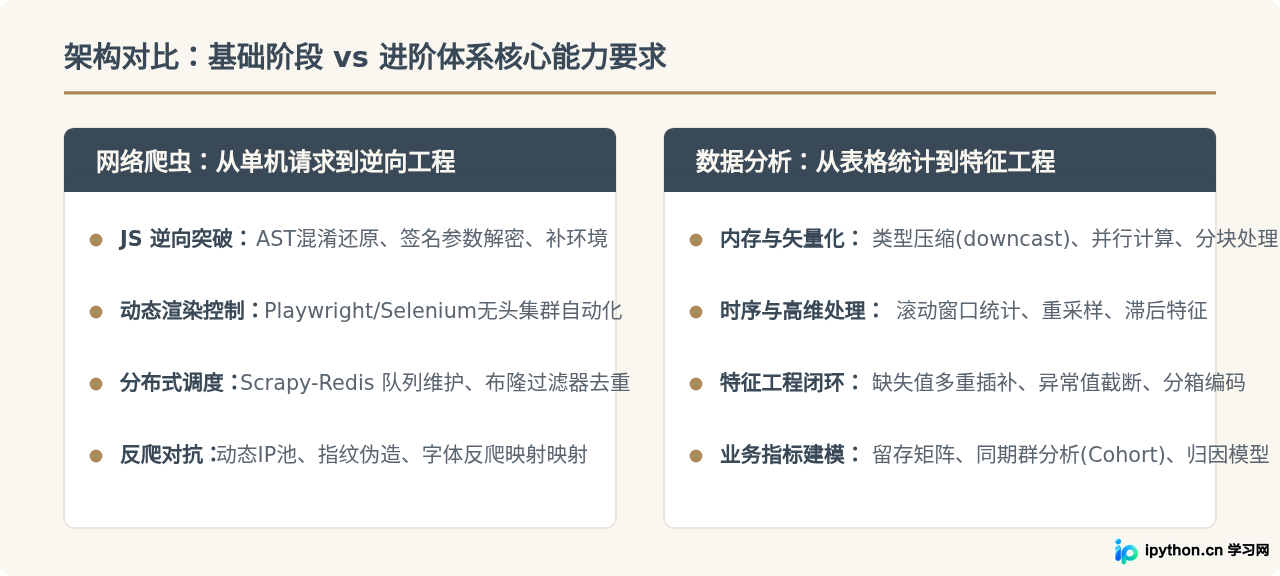
针对Python进阶学习者,提供高质量数据分析与网络爬虫百度网盘课程与配套资源的筛选标准、核心内容构成、实操获取与验证方法,帮助读者避开失效与低质资料。
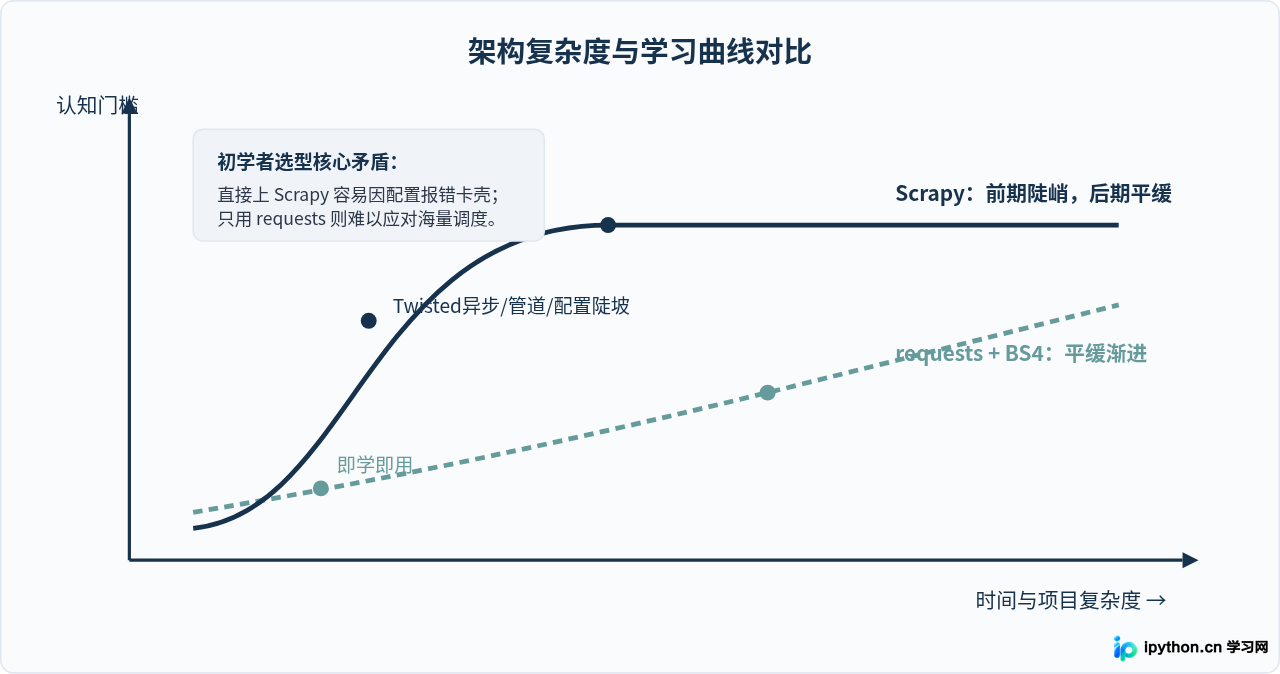
针对Python爬虫初学者在Scrapy与requests+BS4之间的选型困惑,深入对比两者的学习成本、架构复杂度、适用场景与演进路径,提供清晰可执行的决策建议。
本文提供8个基于Python的实用自动化脚本,涵盖网络请求重试、按内容重命名、清理过期文件、拦截高负载进程、操作前自动备份、任务完成系统通知、轻量级数据采集及按后缀归类归档。结合环境配置说明与完整代码,助开发者快速构建稳定高效的工作流。
本文详解如何在Python Selenium中利用execute_script方法绕过网站JS行为监控。通过注入JavaScript代码,实现模拟鼠标直接点击、拦截弹窗、创建派发事件、悬停后点击、滚动至元素及等待可点击状态等多种复杂交互场景,帮助开发者解决元素遮挡、未加载或反爬限制问题。
本文详细解析Scrapy框架中items文件夹的标准工作流程。通过创建继承自scrapy.Item的结构化数据类,在Spider解析函数中提取并填充字段,最后经settings.py配置的Pipeline管道进行清洗或入库,可彻底告别松散字典传递,实现高效稳健的爬虫数据管理。
在使用 Python requests 模块进行网页抓取时,准确处理 URL 地址中的参数是成功获取数据的关键。本文将详细拆解查询参数与请求参数的区别,并演示如何使用 params 和 data 关键字自动完成数据的拼接与编码,避免手动字符串拼接导致的字符集错误。
本文详细介绍如何利用Python的pdfplumber库快速提取PDF文件中的表格数据。通过安装依赖、配置解析策略与遍历页面的实操步骤,提供可直接运行的代码模板与参数说明,帮助用户高效完成结构化数据抓取任务。