

Python爬虫反爬策略:通过伪装浏览器User-Agent绕过IP封禁

本文介绍如何利用Python的requests库通过伪装浏览器User-Agent来绕过网站的反爬机制。通过模拟真实浏览器的请求头(如Accept、Connection等),并随机切换User-Agent,可以有效防止IP被封禁,提高爬虫的稳定性和成功率。
为什么需要伪装浏览器?
许多网站为了防止恶意爬取,会监控请求频率。当单个IP的请求次数过多时,服务器可能会直接封禁该IP。为了绕过这一限制,爬虫程序需要模拟真实用户的浏览器行为,使服务器认为请求来自正常的浏览器访问,而非自动化脚本。
如何获取并添加请求头?
要成功伪装,首先需要获取目标网站的浏览器请求头信息。可以通过打开浏览器的开发者工具(通常按F12),在“网络(Network)”标签页中查看任意请求的“Headers”栏,找到“User-Agent”字段。复制该字符串并将其添加到Python请求的headers字典中。
除了User-Agent,完整的浏览器请求通常还包含以下关键头部信息:
Accept:指定浏览器可接受的媒体类型(如text/html)。Accept-Encoding:声明浏览器支持的编码方式(如gzip)。Accept-Language:声明浏览器偏好的语言环境。Connection:通常设置为keep-alive,表示保持连接。Host:指定被请求资源的Internet主机和端口。Cookie:用于存储用户会话信息,帮助服务器辨别身份。
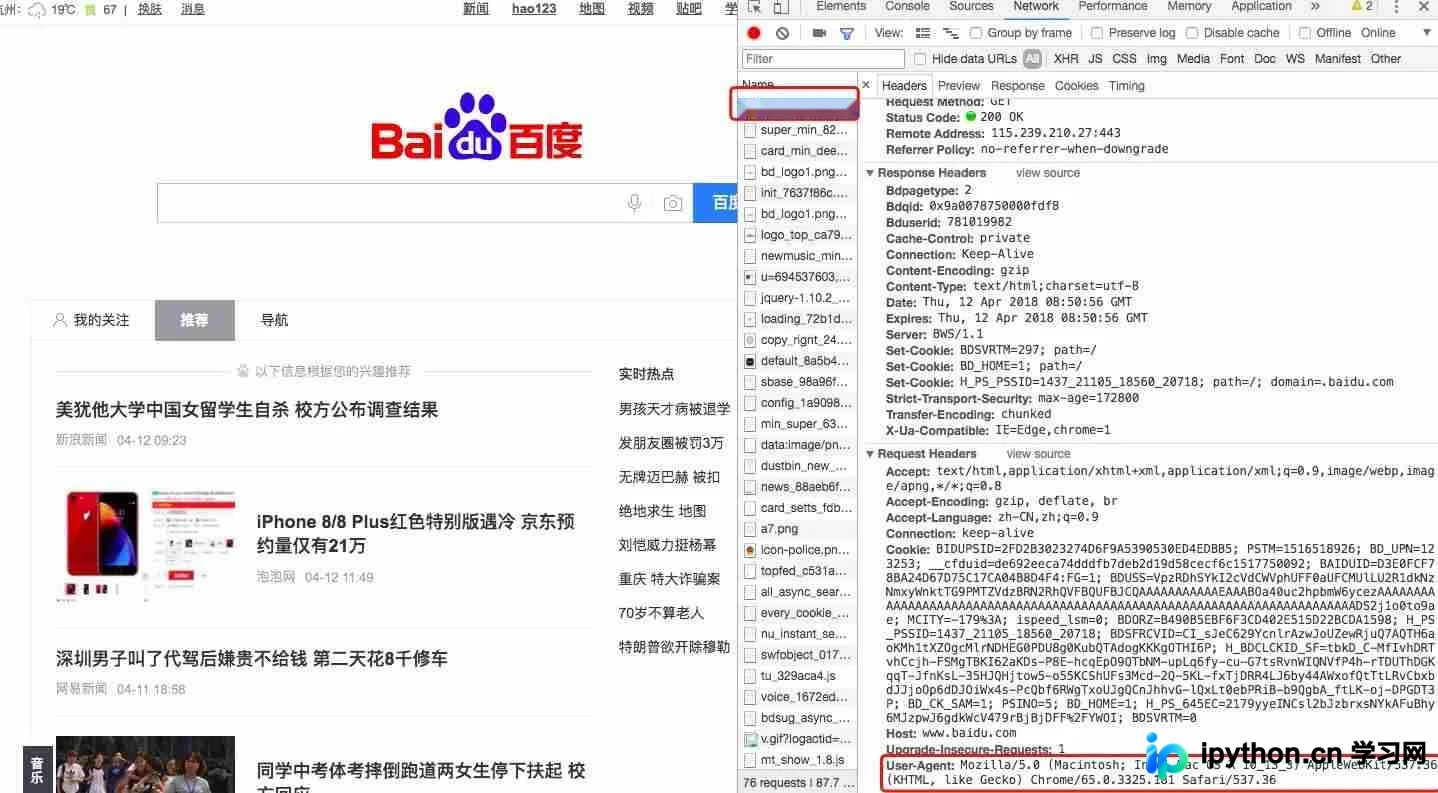
基础实现:固定User-Agent
首先,我们可以使用Python的requests库发送GET请求。通过构造包含User-Agent的headers字典,并将其传递给requests.get()方法,即可实现基础的浏览器伪装。
import requests
url = 'https://www.baidu.com'
headers ={
    'User-Agent':'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_3) AppleWebKit/537.36 (KHTML, like Gecko) '
           'Chrome/65.0.3325.181 Safari/537.36'
    }
rq = requests.get(url=url, headers=headers)
print(rq.text)
进阶实现:随机切换User-Agent
如果始终使用同一个User-Agent,服务器仍可能识别出这是同一台设备或脚本。为了更深层次的伪装,可以准备多个不同浏览器和操作系统的User-Agent列表,并在每次请求时随机选择一个发送。这能有效防止服务器将请求关联到同一来源。
实现步骤如下:
- 定义一个包含多个User-Agent字符串的列表。
- 在每次发起请求前,使用
random.choice()从列表中随机选取一个User-Agent。 - 将选中的User-Agent放入headers字典中发送请求。
import requests
import random

url = 'https://www.baidu.com'
headers_lists =(
    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_3) AppleWebKit/537.36 (KHTML, like Gecko) '
           'Chrome/65.0.3325.181 Safari/537.36',
    'Mozilla/4.0(compatible;MSIE7.0;WindowsNT5.1;Maxthon2.0',
    'Opera/9.80(Android2.3.4;Linux;Operamobi/adr-1107051709;U;zh-cn)Presto/2.8.149Version/11.10',
    'Mozilla/5.0(WindowsNT6.1;rv:2.0.1)Gecko/20100101Firefox/4.0.1',
    'Mozilla/5.0(Android;Linuxarmv7l;rv:5.0)Gecko/Firefox/5.0fennec/5.0',)

rq = requests.get(url=url,headers={'User-Agent':random.choice(headers_lists)})
print(rq.text)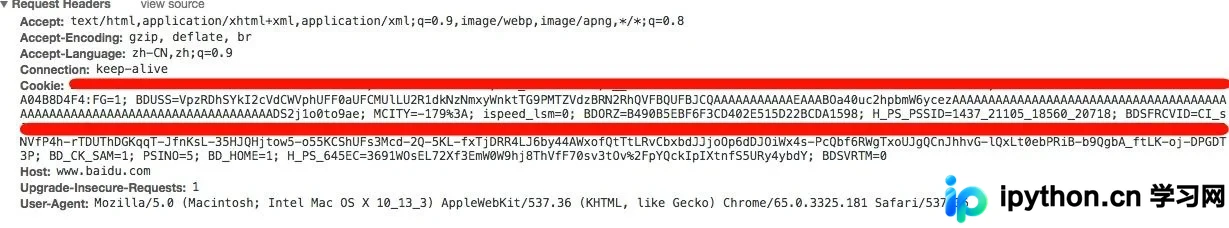
注意事项
虽然伪装User-Agent可以绕过基础的反爬检测,但高级的反爬系统还会检查TLS指纹、Canvas指纹或行为模式。此外,频繁请求仍可能导致IP被封禁,建议配合代理IP池使用,并控制请求频率。对于涉及用户隐私或敏感数据的网站,请确保遵守相关法律法规及网站的服务条款。
以上就是Python反爬虫伪装浏览器进行爬虫的详细内容,更多关于Python爬虫技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









