

Python爬虫urllib异常处理详解:URLError与HTTPError实战

本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
urllib中的异常处理
在开发爬虫程序时,若目标URL存在错误,将导致无法成功抓取预期内容。为解决这一问题,我们需要引入urllib库中的异常处理机制,以增强程序的容错能力。
url的组成部分
一个标准的URL通常由六个核心部分组成,例如:
https://www.baidu.com/s?wd=易烊千玺
- 协议(http/https)
- 主机(www.baidu.com)
- 端口号(80/443)
- 路径(s)
- 参数(wd=易烊千玺)
- 锚点
常见的端口号:
http(80) https(443) mysql(3306) oracle(1521) redis(6379) mongodb(27017)
URLError
通常情况下,URLError主要反映URL地址中主机部分出现的错误,例如域名解析失败或网络连接中断。
实例:
url = 'https://www.baidu.com1/'运行结果:
urllib.error.URLError: <urlopen error [Errno 11001] getaddrinfo failed
HTTPError
该异常通常由URL地址中路径或参数部分的错误引起,例如请求的资源不存在。
实例:
url = 'https://www.jianshu.com/p/3388cf148dba1'运行结果:
urllib.error.HTTPError: HTTP Error 404: Not Found
简介
- HTTPError类是URLError类的子类,用于处理更具体的HTTP协议层面的错误。
- 导入的包urllib.error.HTTPError/urllib.error.URLError
- HTTP错误是针对浏览器无法连接到服务器时产生的错误提示,旨在引导并告知用户页面出现了何种问题。
- 在使用urllib发送网络请求时,请求可能会失败。为了使代码更加健壮,建议通过try-except语句块来捕获并处理这些异常。
Urllib.error 模块
urllib.error模块为urllib.request所引发的异常定义了相关的异常类,其中基础异常类为URLError。
urllib.error模块主要包含两个关键类:URLError和HTTPError。
URLError是OSError的一个子类,当程序在运行过程中遇到网络问题时会引发此异常(或其派生类)。
HTTPError是URLError的子类,专门用于处理特定的HTTP错误(如认证请求失败)。它包含以下属性:code为HTTP状态码,reason为异常原因,headers为导致该错误的特定HTTP请求的响应头。
异常处理
使用try-except语句块可以捕获并处理异常,其基本语法结构如下:
try:可能产生异常的代码块
except [ (Error1, Error2, … ) [as e]]:处理异常的代码块1
except [ (Error3, Error4, … ) [as e]]:处理异常的代码块2
except [Exception]:处理其它异常
实例:
原url= ‘https://www.jianshu.com/p/3388cf148dba’
源码:
import urllib.request
import urllib.error
url = 'https://www.jianshu.com1/p/3388cf148dba'
# url的组成 eg:https://www.baidu.com/s?wd=易烊千玺
# 1.协议(http/https) 2.主机(www.baidu.com) 3.端口号(80/443) 4.路径(s) 5.参数(wd=易烊千玺) 6.锚点
#  常见的端口号
# http(80) https(443) mysql(3306) oracle(1521) redis(6379) mongodb(27017)
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/98.0.4758.102 Safari/537.36'
}
try:
    request = urllib.request.Request(url = url,headers = headers)
    response = urllib.request.urlopen(request)
    content = response.read().decode('utf8')
    print(content)
except urllib.error.HTTPError:
    print('HTTP异常,请稍后!')
except urllib.error.URLError:
    print('URL异常,请稍后!')
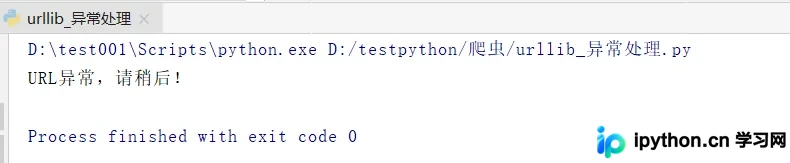
1.URLError
url = ‘https://www.jianshu.com1/p/3388cf148dba’
运行结果:
2.HTTPError
url = ‘https://www.jianshu.com/p/3388cf148dba111’
运行结果:
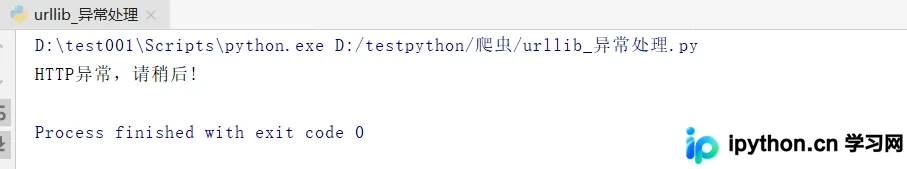
由于HTTPError是URLError的子类,因此在编写异常处理代码时,必须先捕获HTTPError,否则所有的HTTP错误都会被当作URLError处理。关于Python爬虫urllib异常处理的内容就介绍到这里,希望开发者们编写的程序能避免异常,如需了解更多Python爬虫urllib异常处理的资料,请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









