

Python爬取东方财富股票实时数据详解:从Ajax请求到数据持久化

本文详细讲解如何利用Python爬取东方财富网的股票实时数据。通过F12开发者工具分析Ajax动态加载接口,识别关键参数如pn控制页码。针对非标准JSON返回格式进行清洗处理,提取f2至f22等字段含义,并编写Python脚本实现数据解析、存储及多页循环抓取,最终完成股票信息的本地保存。
东方财富股票数据接口分析
首先访问东方财富网的股票列表页面,地址为:
http://quote.eastmoney.com/center/gridlist.html#hs_a_board
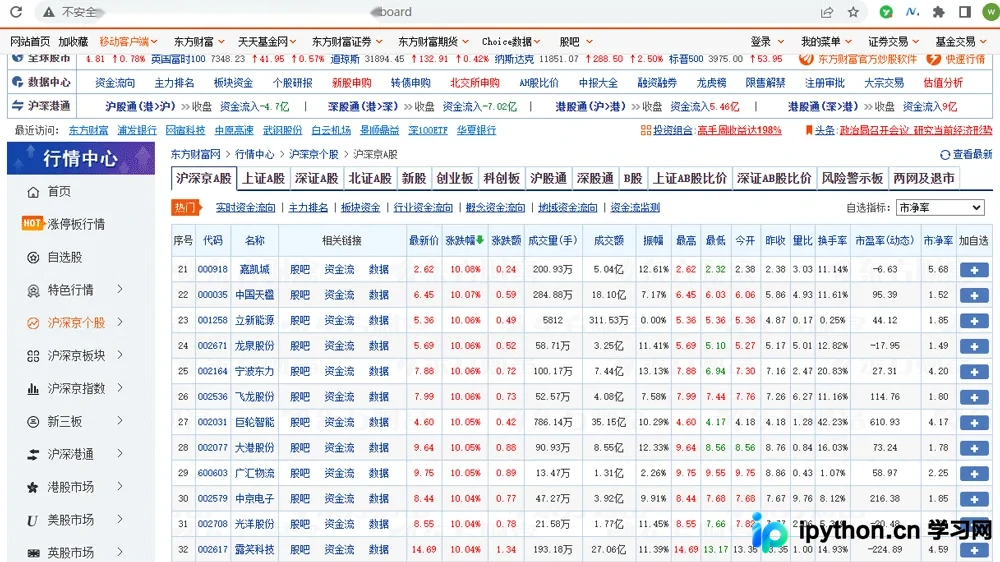
在浏览该网站时点击“下一页”,会发现页面内容发生更新,但浏览器地址栏中的URL保持不变。这表明该网站采用了Ajax技术,通过异步方式从服务器获取数据。这种机制的优势在于无需重新加载整个网页即可更新局部内容,从而有效降低网络负载并提升页面加载速度。
Ajax接口参数解析与定位
按下F12键打开浏览器开发者工具,切换到“网络(Network)”选项卡查看网络请求,可以清晰地看到网页数据是通过特定的API接口获取的。
http://38.push2.eastmoney.com/api/qt/clist/get?cb=jQuery112409036039385296142_1658838397275&pn=3&pz=20&po=1&np=1&ut=bd1d9ddb04089700cf9c27f6f7426281&fltt=2&invt=2&wbp2u=|0|0|0|web&fid=f3&fs=m:0+t:6,m:0+t:80,m:1+t:2,m:1+t:23,m:0+t:81+s:2048&fields=f1,f2,f3,f4,f5,f6,f7,f8,f9,f10,f12,f13,f14,f15,f16,f17,f18,f20,f21,f23,f24,f25,f22,f11,f62,f128,f136,f115,f152&_=1658838404848
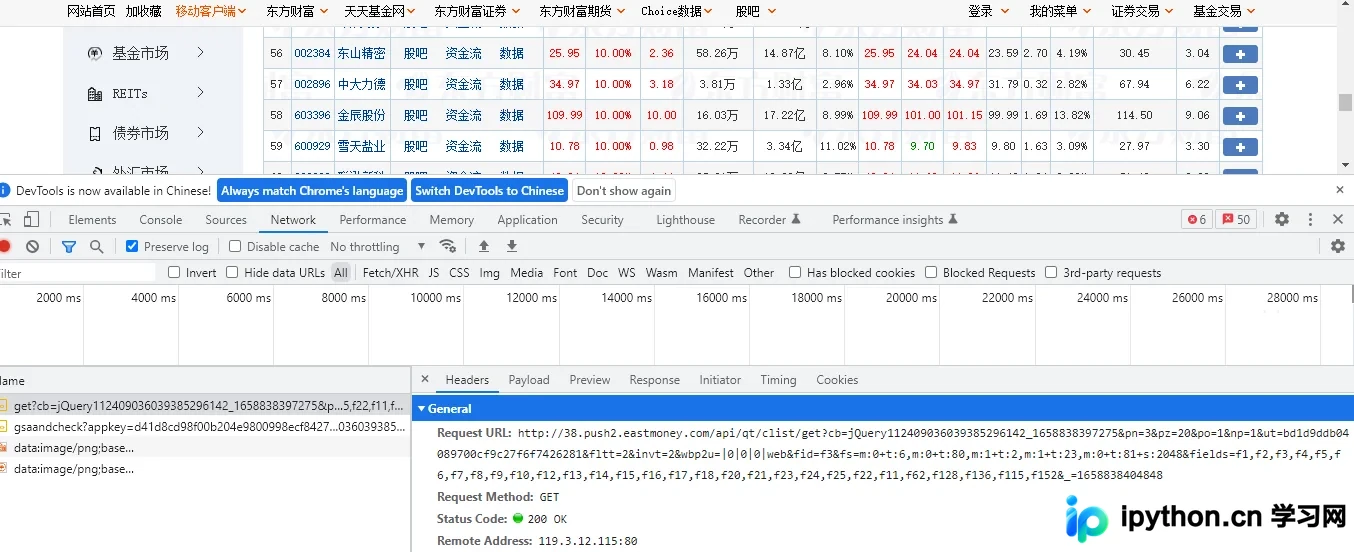
通过多次请求该接口并对比参数变化,可以发现pn参数对应着当前的页码。因此,通过修改&pn=参数后的数值,即可访问不同页码对应的股票数据。
import requests
json_url = "http://48.push2.eastmoney.com/api/qt/clist/get?cb=jQuery112402508937289440778_1658838703304&pn=1&pz=20&po=1&np=1&ut=bd1d9ddb04089700cf9c27f6f7426281&fltt=2&invt=2&wbp2u=|0|0|0|web&fid=f3&fs=m:0+t:6,m:0+t:80,m:1+t:2,m:1+t:23,m:0+t:81+s:2048&fields=f1,f2,f3,f4,f5,f6,f7,f8,f9,f10,f12,f13,f14,f15,f16,f17,f18,f20,f21,f23,f24,f25,f22,f11,f62,f128,f136,f115,f152&_=1658838703305"
res = requests.get(json_url)
非标准JSON数据处理与字段映射
接下来分析接口返回的数据结构,可以看出返回的内容并非标准的JSON格式。
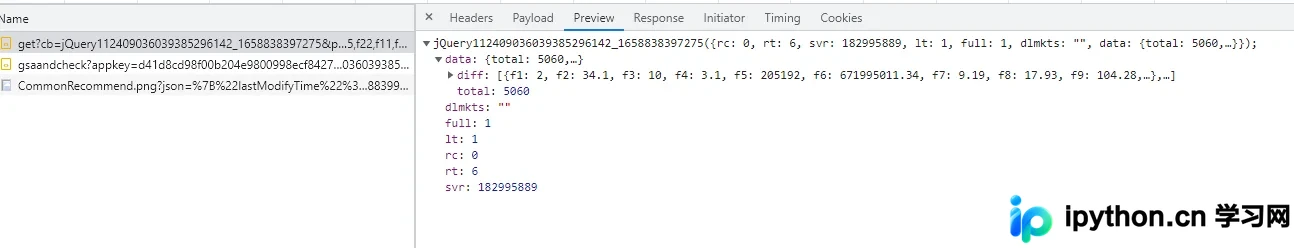
为了便于后续处理,我们需要对返回的原始文本进行JSON格式转换:
result = res.text.split("jQuery112402508937289440778_1658838703304")[1].split("(")[1].split(");")[0]
result_json = json.loads(result)
result_json
输出结果示例如下:
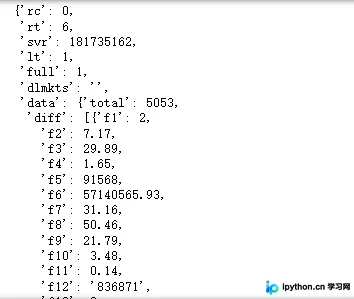
返回数据中各字段的含义对应关系如下:
- f2:最新价
- f3:涨跌幅
- f4:涨跌额
- f5:成交量(手)
- f6:成交额
- f7:振幅
- f8:换手率
- f9:市盈率
- f10:量比
- f12:股票代码
- f14:股票名称
- f15:最高价
- f16:最低价
- f17:今开价
- f18:昨收价
- f22:市净率
数据持久化存储与多页抓取实现
首先定义一个用于存储数据的函数:
def save_data(data, date):
    if not os.path.exists(r'stock_data_%s.csv' % date):
        with open("stock_data_%s.csv" % date, "a+", encoding='utf-8') as f:
            f.write("股票代码,股票名称,最新价,涨跌幅,涨跌额,成交量(手),成交额,振幅,换手率,市盈率,量比,最高,最低,今开,昨收,市净率\n")
            for i in data:
                Code = i["f12"]
                Name = i["f14"]
                Close = i['f2']
                ChangePercent = i["f3"]
                Change = i['f4']
                Volume = i['f5']
                Amount = i['f6']
                Amplitude = i['f7']
                TurnoverRate = i['f8']
                PERation = i['f9']
                VolumeRate = i['f10']
                Hign = i['f15']
                Low = i['f16']
                Open = i['f17']
                PreviousClose = i['f18']
                PB = i['f22']
                row = '{},{},{},{},{},{},{},{},{},{},{},{},{},{},{},{}'.format(
                    Code,Name,Close,ChangePercent,Change,Volume,Amount,Amplitude,
                    TurnoverRate,PERation,VolumeRate,Hign,Low,Open,PreviousClose,PB)
                f.write(row)
                f.write('\n')
    else:
    ...
随后将前一步处理好的JSON数据传入该函数:
stock_data = result_json['data']['diff']
save_data(stock_data, '2022-07-28')
执行上述代码后,即可获取第一页的股票数据:
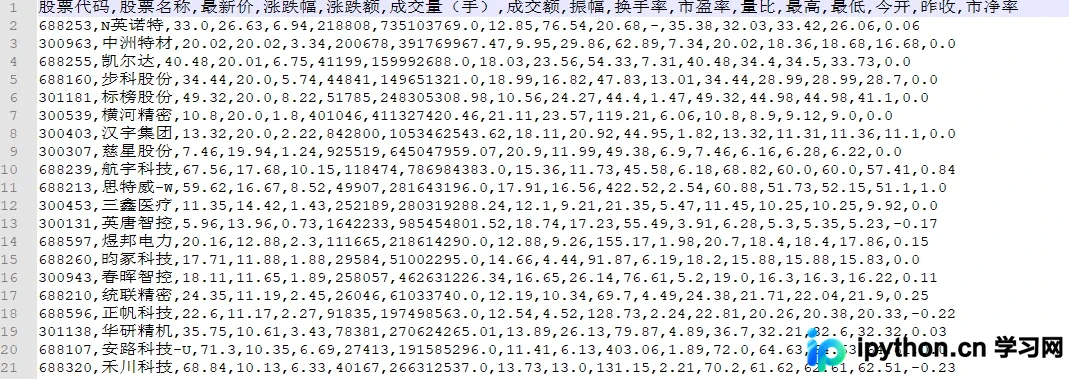
最后,只需通过循环遍历所有需要抓取的网页即可:
for i in range(1, 5):
    print("抓取网页%s" % str(i))
    url = "http://48.push2.eastmoney.com/api/qt/clist/get?cb=jQuery112402508937289440778_1658838703304&pn=%s&pz=20&po=1&np=1&ut=bd1d9ddb04089700cf9c27f6f7426281&fltt=2&invt=2&wbp2u=|0|0|0|web&fid=f3&fs=m:0+t:6,m:0+t:80,m:1+t:2,m:1+t:23,m:0+t:81+s:2048&fields=f1,f2,f3,f4,f5,f6,f7,f8,f9,f10,f12,f13,f14,f15,f16,f17,f18,f20,f21,f23,f24,f25,f22,f11,f62,f128,f136,f115,f152&_=1658838703305" % str(i)
    res = requests.get(json_url)
    result = res.text.split("jQuery112402508937289440778_1658838703304")[1].split("(")[1].split(");")[0]
    result_json = json.loads(result)
    stock_data = result_json['data']['diff']
    save_data(stock_data, '2022-07-28')
至此,我们已完成整个股票数据抓取流程的实现。
以上就是关于利用Python爬取股票实时数据详情的介绍,更多相关Python爬取股票数据的内容,欢迎搜索本站历史文章或继续浏览后续相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









