

Python网页解析器入门:从正则到BeautifulSoup实战

发布时间:2026-10-13| 5人浏览过
本文详解Python中常见的网页解析工具,包括正则表达式、html.parser、BeautifulSoup及lxml。重点介绍基于DOM树的结构化解析原理,并通过urllib与requests库结合BeautifulSoup的完整代码示例,展示如何获取和解析网页内容,帮助开发者快速掌握网页数据提取的核心方法。
Python网页解析器概述
Python网页解析器
在Python开发中,常用的网页解析工具主要包括四类:一是利用re模块进行正则表达式匹配;二是使用Python内置的html.parser模块;三是广泛使用的第三方库BeautifulSoup,建议重点掌握;四是性能优异的lxml库。
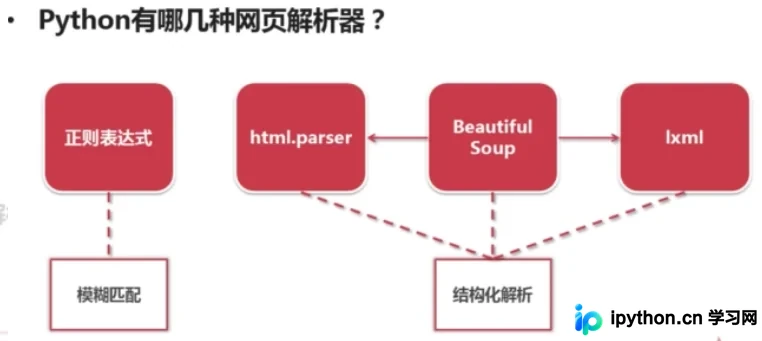
网页解析器分类与原理
常见的网页解析器主要可分为两大类。
第一类为模糊匹配,主要指通过re正则表达式实现的字符串模式匹配方式。
第二类为结构化解析,包括BeautifulSoup、html.parser和lxml。这三者均依据DOM树结构标准,对网页标签的结构信息进行提取。
关于DOM树的解释:DOM全称为文档对象模型(Document Object Model),其核心在于将网页视为树形标签结构,具体结构示意请参考下图。
所谓结构化解析,是指网页解析器会将下载得到的整个HTML文档视为一个Document对象,随后利用该对象上下级的标签层级关系,对标签进行遍历并提取所需信息。
基于urllib与BeautifulSoup的解析示例
# 引入相关的包,urllib与bs4,是获取和解析网页最常用的库
from urllib.request import urlopen
from bs4 import BeautifulSoup

# 打开链接
html=urlopen("https://www.datalearner.com/website_navi")

# 通过urlopen获得网页对象,将其放入BeautifulSoup中,bsObj存放的目标网页的html文档

bsObj=BeautifulSoup(html.read())
print(bsObj)
# soup = BeautifulSoup(open(url,'r',encoding = 'utf-8'))
基于requests与lxml的解析示例
import requests
from bs4 import BeautifulSoup

headers={'User-Agent': 'Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/57.0.2987.110 Safari/537.36','referer':"www.mmjpg.com" }
all_url = 'http://www.mmjpg.com/'
  #'User-Agent':请求方式
  #'referer':从哪个链接跳转进来的

start_html = requests.get(all_url, headers=headers)
  #all_url:起始的地址,也就是访问的第一个页面
  #headers:请求头,告诉服务器是谁来了。
  #requests.get:一个方法能获取all_url的页面内容并且返回内容。

Soup = BeautifulSoup(start_html.text, 'lxml')
  #BeautifulSoup:解析页面
  #lxml:解析器
  #start_html.text:页面的内容
以上内容为本文的全部介绍,希望能为读者的学习提供有益帮助,同时也欢迎大家继续支持本站获取更多技术资源。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









