

Scrapy框架实现网站登录的三种方法详解
本文详细介绍在Scrapy框架中实现网站登录的三种常见方式。第一种通过预置Cookies直接访问;第二种手动解析网页获取隐藏字段后发送POST请求;第三种利用FormRequest.from_response自动处理表单提交。文章提供完整代码示例,帮助开发者掌握不同场景下的登录策略。
2026-10-13
6

本文详细介绍在Scrapy框架中实现网站登录的三种常见方式。第一种通过预置Cookies直接访问;第二种手动解析网页获取隐藏字段后发送POST请求;第三种利用FormRequest.from_response自动处理表单提交。文章提供完整代码示例,帮助开发者掌握不同场景下的登录策略。
本文详解Python爬虫中URL管理器的实现方法,重点解析如何利用collections模块中的deque双向队列高效维护待抓取与已抓取URL集合。通过示例代码展示如何判断URL存在性、执行去重逻辑及防止页面跳转死循环,为构建稳定爬虫系统提供核心组件参考。
本文深入解析Python BeautifulSoup库中的核心数据结构。详细讲解如何利用Tag对象获取HTML/XML标签名、读写属性及处理多值属性;介绍NavigableString类用于处理标签内文本及替换操作;阐述BeautifulSoup对象作为文档整体的特性,以及Comment对象在提取注释内容时的应用。
本文解析在Python Scrapy爬虫中将数据存入Elasticsearch的两种方法。首先介绍基于elasticsearch-dsl的基础写入,指出其无法控制主键导致重复数据的问题。随后详解第二种方法,通过Elasticsearch客户端指定自定义_id实现覆盖插入,并展示如何在settings.py中注册Pipeline及执行查询操作,适用于ES 5.6.1版本。
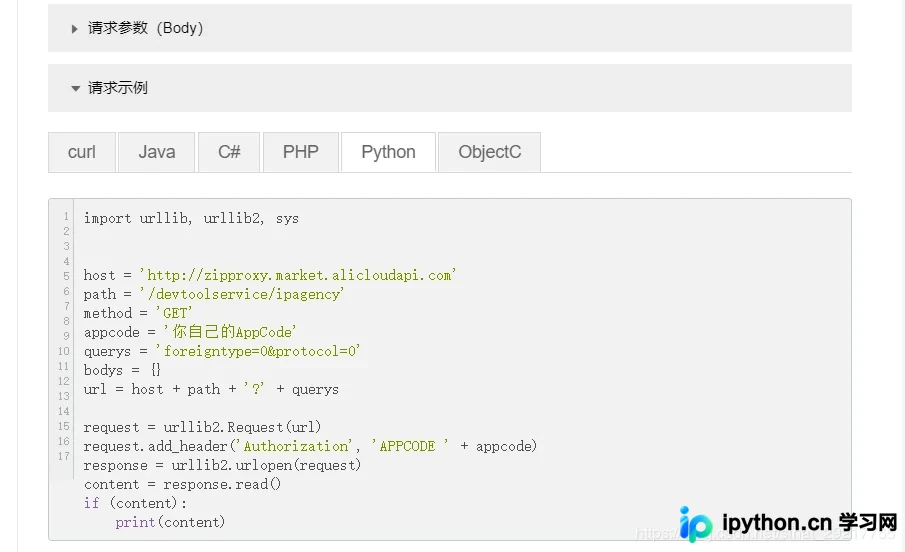
本文详细讲解在Python3 Scrapy框架中配置IP代理的方法。针对阿里云IP代理参数变更及公共IP池不可用的问题,提出结合阿里云API生成有效IP池并在middlewares.py中通过process_request动态设置request.meta['Proxy-Authorization']的解决方案,确保爬虫稳定运行。
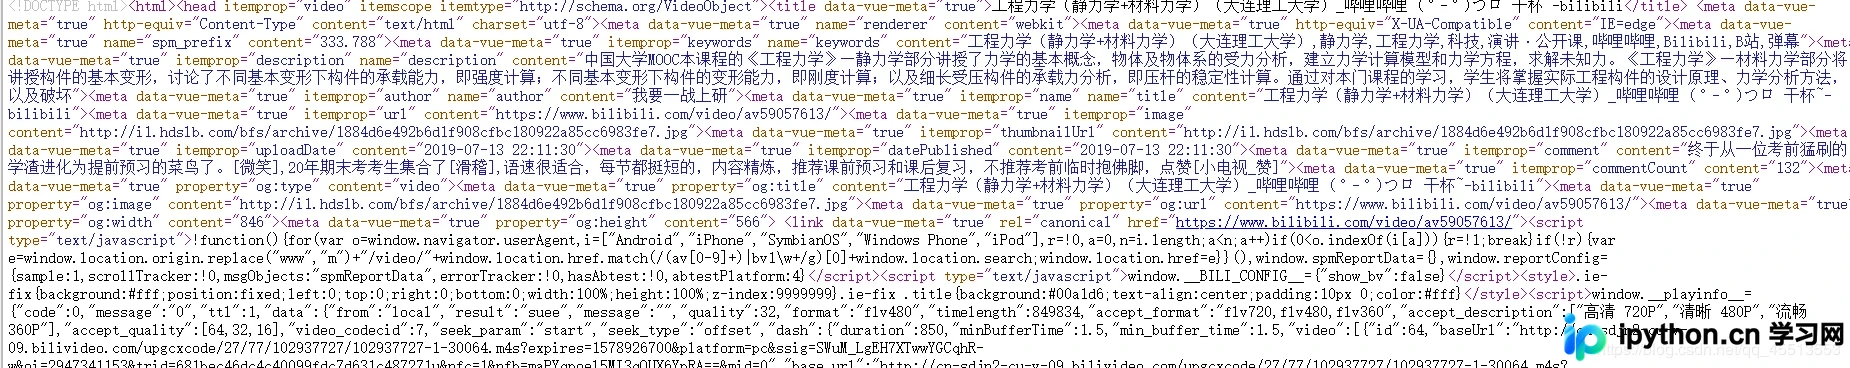
本文介绍利用Python脚本自动获取Bilibili系列视频总时长的方法。通过抓取网页源码中的timelength字段,结合正则表达式解析分集数量,实现批量视频时长的快速统计。文章包含详细操作步骤及完整GitHub源码链接,适合Python初学者参考学习。
本文详解Selenium中get_cookies()与add_cookie()函数的使用方法。通过获取当前浏览器Cookie并保存为JSON文件,后续爬虫任务可直接读取该文件并利用add_cookie()注入Cookie,从而绕过登录验证。该方法特别适用于验证码识别困难或需要高频定时爬取且不想频繁登录的场景,有效提升爬虫稳定性和效率。
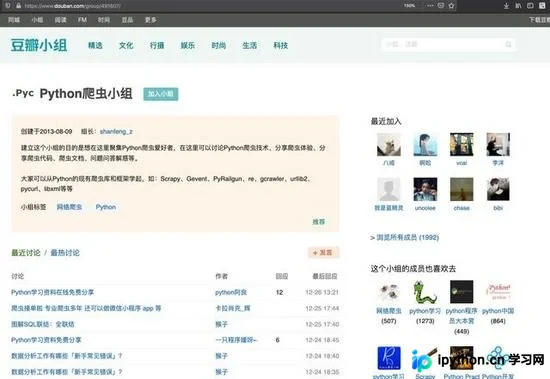
本文详细解析Python中解析HTML网页的四种主流方式:正则表达式、requests-html、BeautifulSoup及lxml XPath。通过豆瓣小组页面抓取实例,对比各库在代码复杂度、执行效率及适用场景上的差异,帮助开发者根据实际需求选择最高效的数据提取工具。
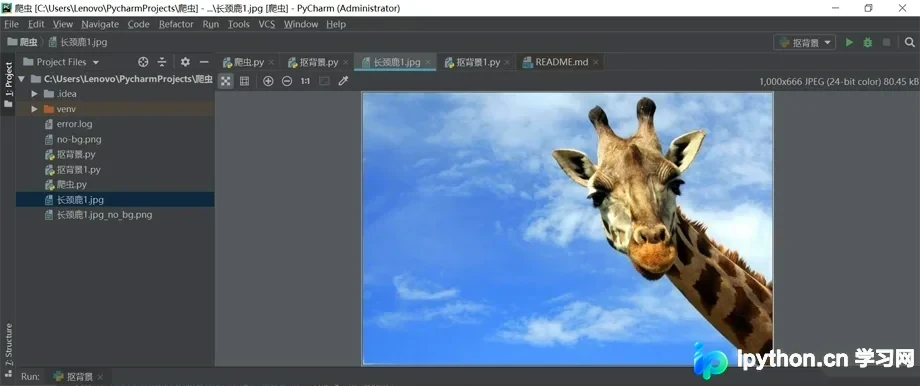
本文介绍利用Python实现一键抠除图片背景的方法。通过对比requests模块直接调用API与使用removebg库两种方式,展示代码实现细节。针对removebg库添加纯色背景参数报错的问题,提供使用PIL库手动填充背景色的解决方案,并附带完整代码示例与效果说明。
本文详细介绍Python中CSV模块的标准使用流程,涵盖文件打开模式(a, r, w及其变体)及写入对象初始化的具体方法。通过猫眼电影Top10榜单的完整爬取案例,演示如何结合requests库、正则表达式与CSV模块,实现从URL规律分析、数据抓取到本地文件保存的全流程操作,帮助开发者掌握结构化数据存储技巧。
本文深入解析Python3 WebSpider爬虫代理池的源代码测试过程。重点介绍如何利用元类(Metaclass)自动注册抓取函数,通过约定前缀动态生成属性列表,实现抓取逻辑的解耦与扩展。文章包含详细的代码示例及控制台输出日志,展示代理获取器的执行流程与测试结果,为构建可扩展的爬虫系统提供参考。
本文详解Python爬虫中常见的UnicodeDecodeError异常原因,并提供两种通用解码策略:通过HTML标签提取charset自动解码,以及遍历utf-8、gbk等常用编码并配合errors='replace'参数尝试解析。通过对比数据完整性,推荐以实际数据表现选择最佳编码方式,有效解决网页抓取中的乱码问题。
