

Python调用百度翻译接口实现爬虫翻译功能

发布时间:2026-10-13| 5人浏览过
本文详解如何使用Python编写爬虫程序调用百度翻译接口。通过F12开发者工具分析网络请求,获取fanyi.baidu.com/sug接口及POST参数kw。结合urllib库构造请求头与数据,实现输入内容并输出翻译结果的核心功能,适合初学者快速上手网络爬虫开发。
Python调用百度翻译接口实现爬虫翻译功能
实施本项目需分三步走:首先掌握爬虫基础,力求快速上手;其次深入分析百度翻译的API接口机制;最后参考官方提供的Demo示例,开发属于自己的翻译小程序。
启动浏览器并按下F12键,打开百度翻译网页以查看源代码:
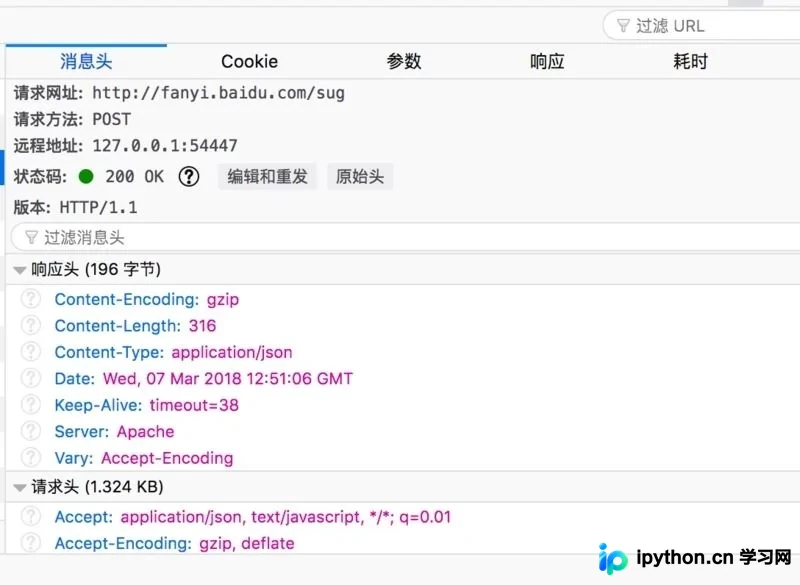
通过源码分析,可以明确识别出百度翻译的核心请求接口地址为:http://fanyi.baidu.com/sug

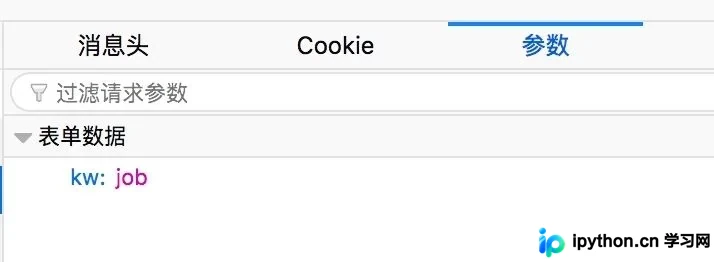
进一步观察方法为POST的请求细节,可发现关键参数为kw,其值对应需要翻译的具体内容(例如输入“job”):
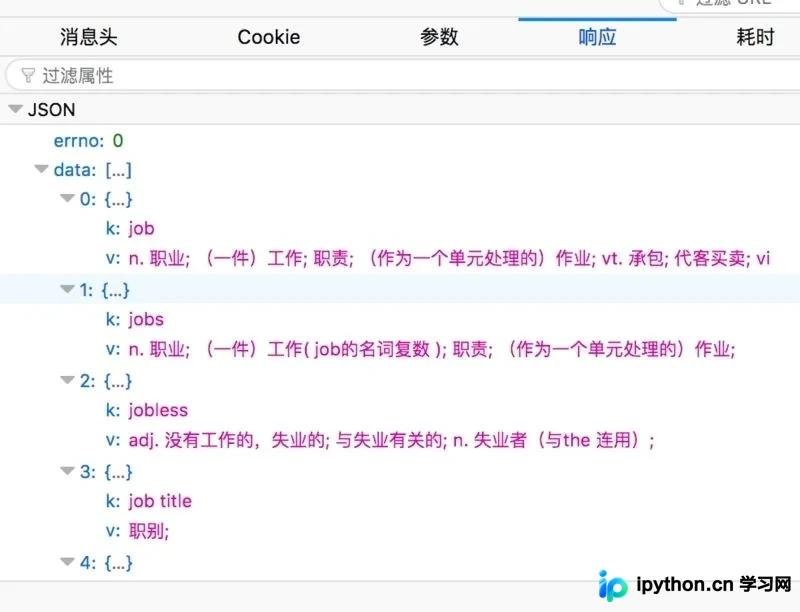
具体的实现代码如下:
from urllib import request,parse
import json


def translate(content):
  url = "http://fanyi.baidu.com/sug"
  data = parse.urlencode({"kw":content}) # 将参数进行转码
  headers = {
    'User-Agent': 'Opera/9.80 (Android 2.3.4; Linux; Opera Mobi/build-1107180945; U; en-GB) Presto/2.8.149 Version/11.10'
  }
  req = request.Request(url,data=bytes(data,encoding="utf-8"),headers=headers)
  r = request.urlopen(req)
  # print(r.code) 查看返回的状态码
  html = r.read().decode('utf-8')
  # json格式化
  html = json.loads(html)
  # print(html)
  for k in html["data"]:
    print(k["k"],k["v"])

if __name__ == '__main__':
  content = input("请输入您要翻译的内容:")
  translate(content)
程序运行后的输出结果如下所示:
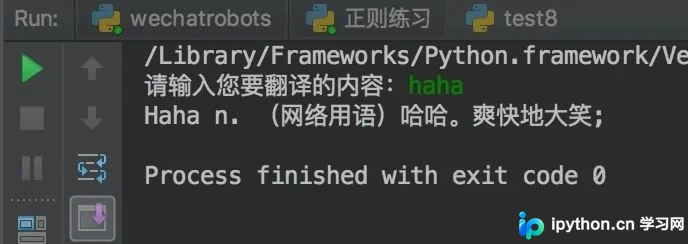
以上内容涵盖了实现该功能的全部关键点,希望能为读者的学习提供有益参考,同时也欢迎继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









