Python3爬虫中GIL对多线程的影响及多核利用方案
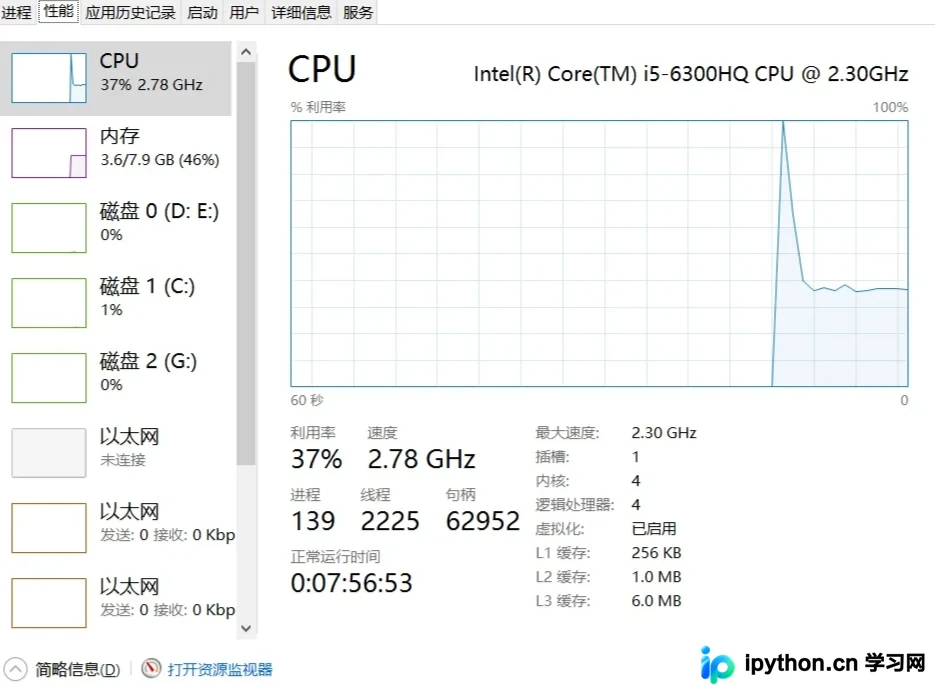
本文深入解析Python3爬虫开发中GIL(全局解释器锁)对多线程性能的制约。通过对比多线程与多进程在4核CPU下的资源占用情况,揭示Python多线程无法利用多核的底层原因,并展示如何利用多进程实现CPU 100%利用率,为高并发爬虫场景提供优化思路。
2026-10-14
6

本文深入解析Python3爬虫开发中GIL(全局解释器锁)对多线程性能的制约。通过对比多线程与多进程在4核CPU下的资源占用情况,揭示Python多线程无法利用多核的底层原因,并展示如何利用多进程实现CPU 100%利用率,为高并发爬虫场景提供优化思路。
本文系统梳理Python Scrapy框架在爬虫开发中的关键注意事项。涵盖利用Redis实现分布式去重与存储、通过Middleware处理代理IP与Headers、合理配置Settings文件、使用FormRequest提交表单数据,以及结合PhantomJS处理动态渲染页面的技术方案。旨在帮助开发者提升爬取效率与稳定性,解决常见技术痛点。
本文详解如何利用Python爬虫技术处理招聘数据。重点讲解如何校正拉勾网与Boss直聘的工作年限描述差异,建立统一的等级标准,并建议舍弃“经验不限”数据以保证统计准确性。同时提供基于PIL库的图片批量筛选代码实例,帮助开发者提升数据处理效率。
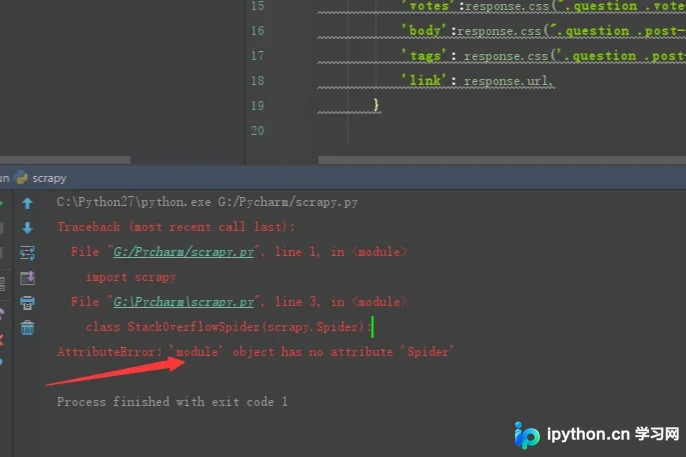
本文针对Python中使用Scrapy框架搭建爬虫时遇到的报错问题,深入分析了错误原因。核心问题在于用户自定义文件命名为scrapy.py,导致与Scrapy官方包名冲突,进而引发Spider属性查找错误。文章提供了具体的解决步骤和命名规范建议,帮助开发者快速定位并修复此类常见搭建错误,确保爬虫项目正常运行。
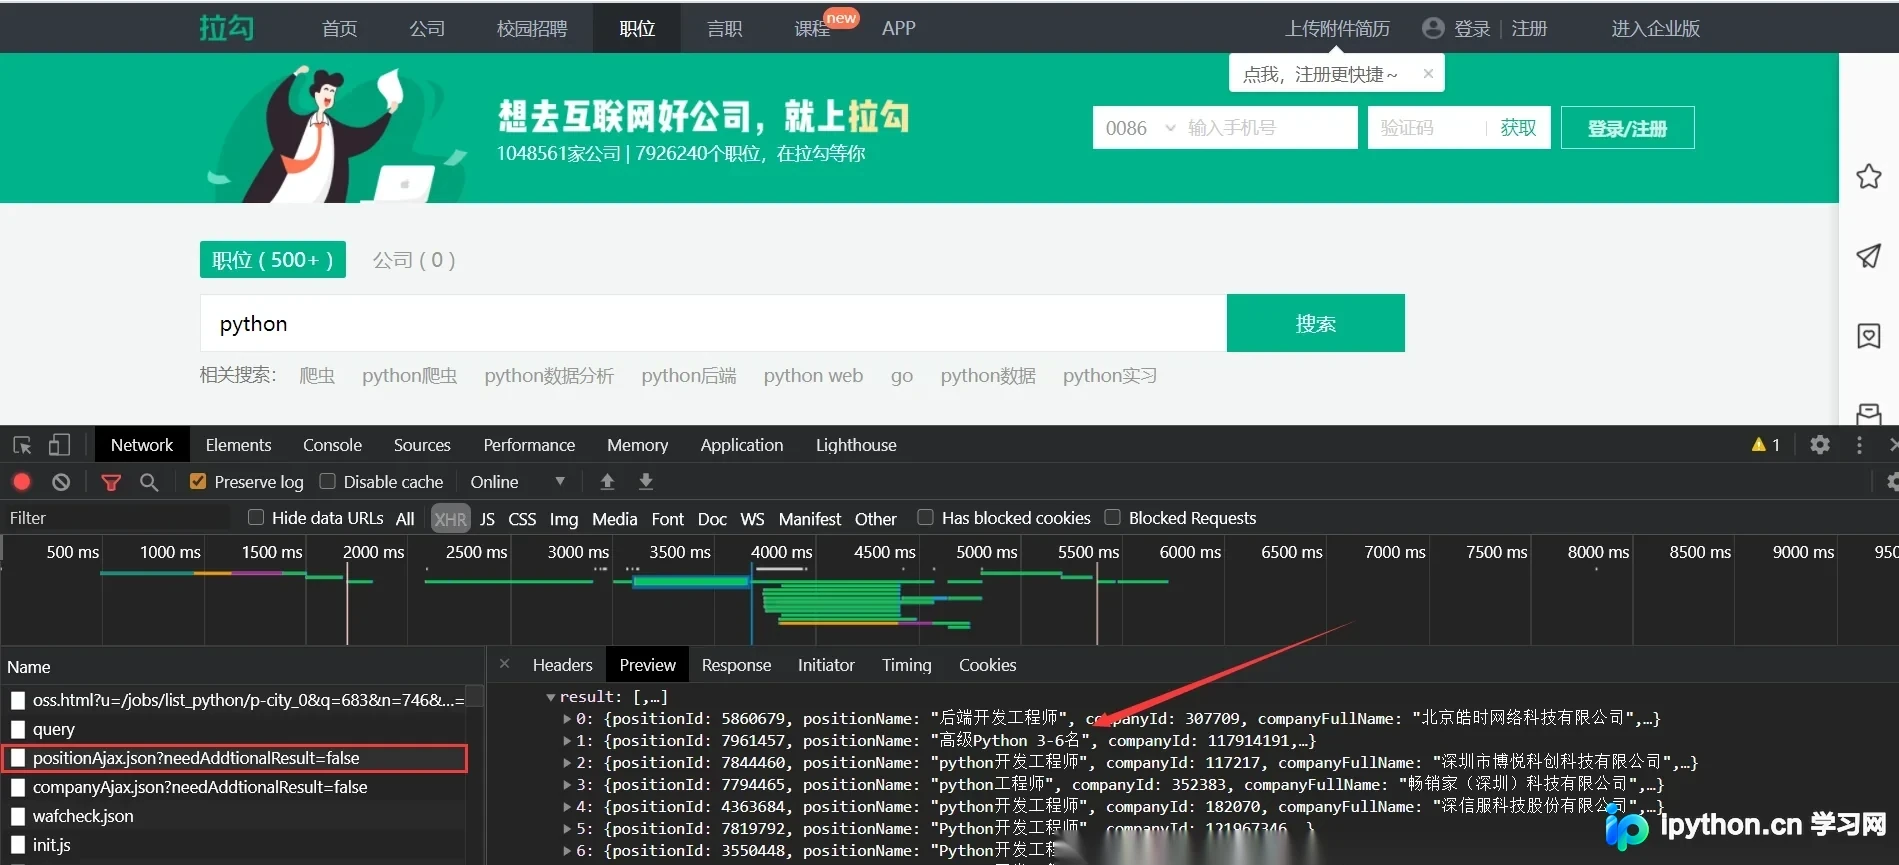
本文详细解析使用Python Requests库爬取拉勾网招聘信息的完整流程。重点解决接口返回操作频繁错误的问题,通过获取并动态刷新Cookies解决反爬限制。代码包含分页请求、字段提取及CSV保存功能,每十次请求自动更新Cookie,确保数据抓取的稳定性与有效性。
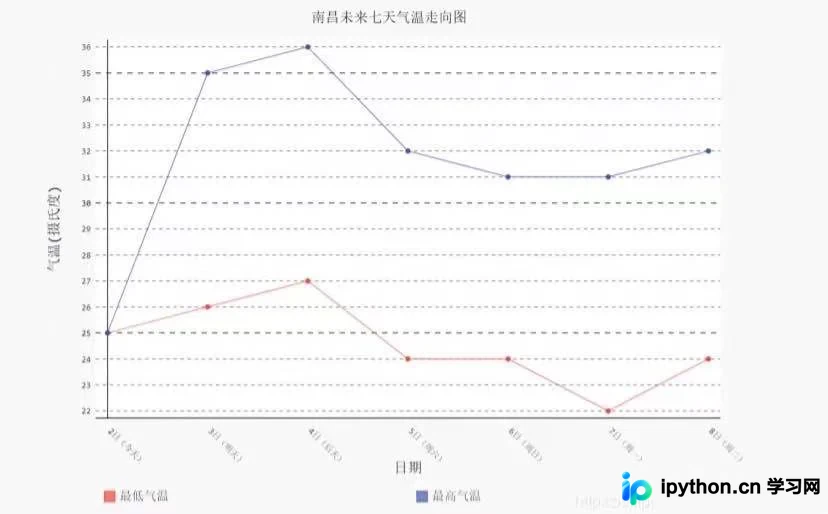
本文详细介绍如何利用Python进行天气数据抓取与可视化分析。通过requests或urllib获取网页天气信息,结合BeautifulSoup解析HTML结构,最终使用pygal库生成直观的折线图。内容涵盖环境配置、代码实现及图表渲染,帮助开发者直观掌握温度变化趋势,适用于气象数据分析场景。
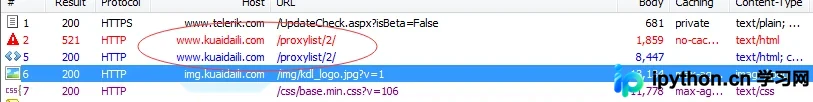
本文详细解析Python爬虫遇到网站返回521状态码及JS加密Cookie的解决方案。通过Fiddler抓包分析,揭示服务端返回混淆JS生成动态Cookie的机制。利用PyV8引擎在Python中执行JS代码,提取并解析Cookie字符串,最终实现携带有效Cookie成功获取数据的全过程。
本文详解向 Scrapy Spider 传递参数的三种常用方式。首先介绍通过命令行 crawl 命令的 -a 选项传递参数;其次讲解利用 Scrapyd 的 schedule.json 接口发送 -d 参数;最后演示如何在 Request 中使用 meta 字段在解析函数间传递数据。通过具体代码示例,帮助开发者灵活控制爬虫行为并关联用户请求与页面数据。
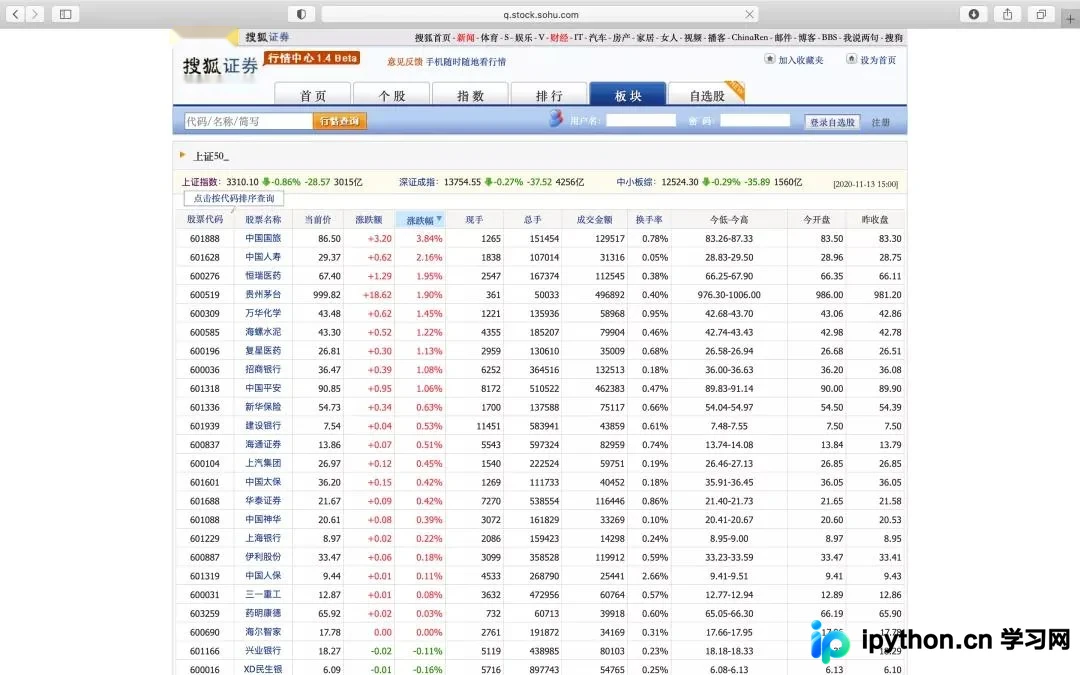
本文详解如何使用Python的requests和BeautifulSoup库,从搜狐证券网站抓取上证50成分股的股票代码。教程涵盖网页请求、编码处理(gb2312)、HTML表格解析及数据清洗,并将结果保存为pickle格式以便后续高效调用,适合金融数据抓取初学者参考。
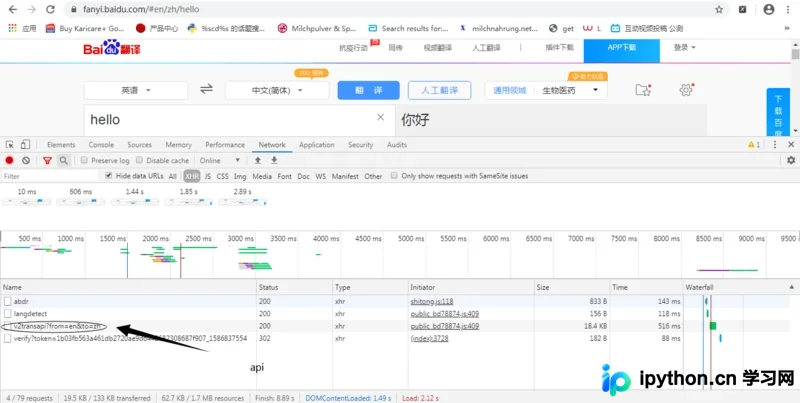
本文详解如何使用 Python 爬虫调用百度翻译接口。通过浏览器开发者工具定位 v2transapi 接口,获取 Cookie 和 Token 以通过基础验证。重点解析由 JS 算法生成的 Sign 参数,利用 Python 的 execjs 库执行 JS 代码动态生成签名,从而绕过百度翻译的反爬限制,实现稳定的文本翻译功能。
本文介绍PhantomJS加载网页并保存为图片的实例方法。通过创建webpage对象调用open方法加载指定URL,判断响应状态成功后使用render方法生成截图。适用于需要批量处理网页快照或进行页面测试的场景,提供完整的JavaScript代码示例及命令行执行步骤。
本文详细介绍如何使用Python的wxPython模块结合爬虫技术,开发一个具备图形界面的NBA球员数据查询小程序。内容涵盖GUI界面布局设计、事件绑定机制、背景图片Base64编码处理以及打包注意事项,帮助开发者快速构建本地化工具。