

Python爬虫批量下载PDF文件实战:从Excel链接到自动化脚本
本文介绍如何利用Python爬虫批量下载Excel中列出的500多个PDF文件。针对Python 3.5环境,修正了旧版代码语法,通过正则表达式匹配特定URL模式,实现自动抓取与保存。
2026-10-14
6

本文介绍如何利用Python爬虫批量下载Excel中列出的500多个PDF文件。针对Python 3.5环境,修正了旧版代码语法,通过正则表达式匹配特定URL模式,实现自动抓取与保存。
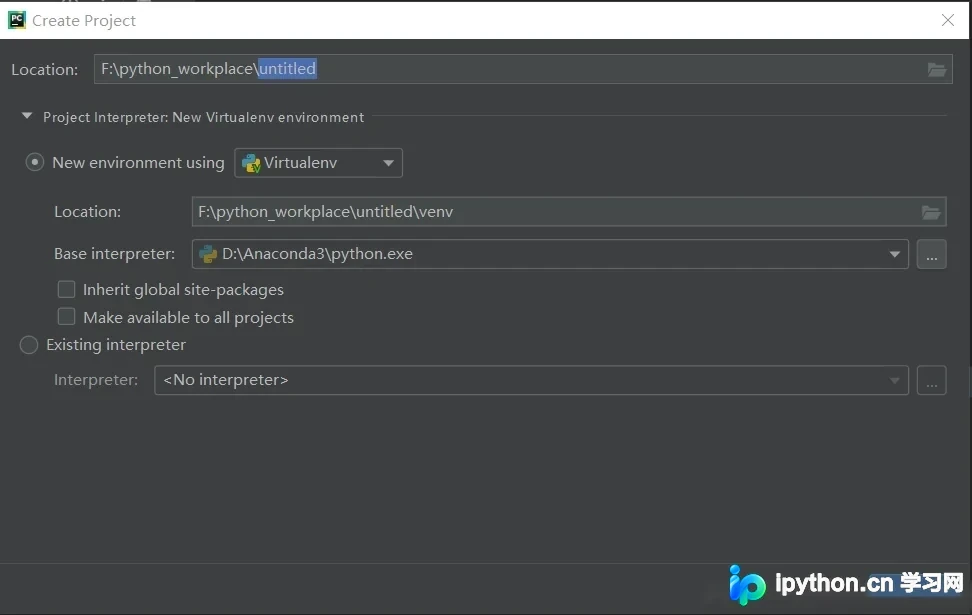
本文详细介绍如何在PyCharm中快速创建Scrapy爬虫项目。主要步骤包括:新建Python项目、通过Settings配置并安装Scrapy库(建议更换下载源以防超时),最后利用Terminal终端执行scrapy startproject命令完成项目初始化。文章涵盖环境配置与命令行操作,帮助开发者高效搭建爬虫开发环境。
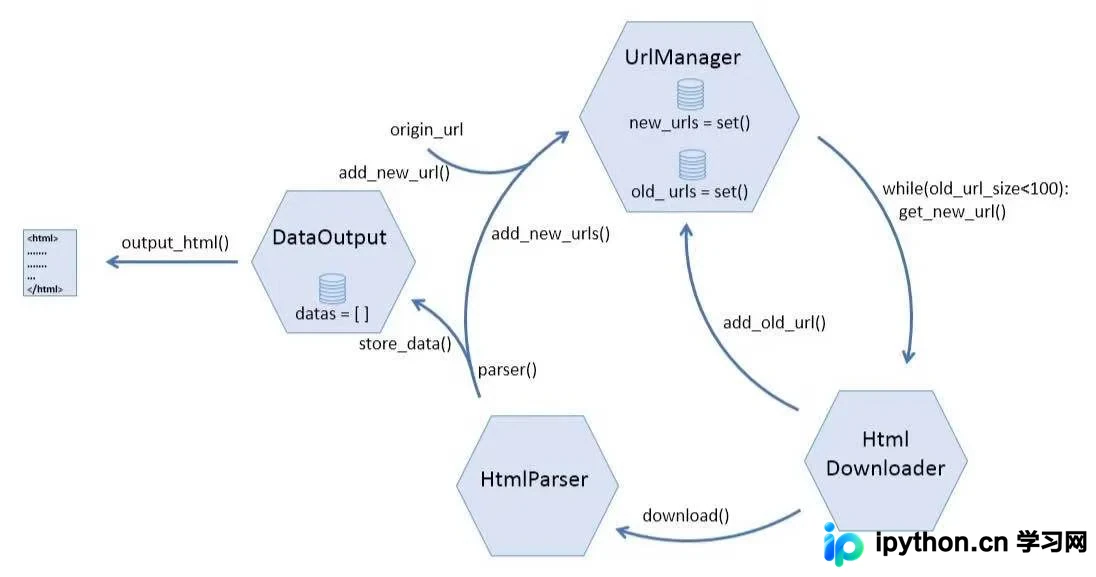
本文详细介绍Python爬虫中URL管理器的核心功能,重点解析如何利用Python的set()函数实现链接去重。通过对比新旧URL仓库,阐述如何高效识别并过滤重复链接,从而提升爬虫抓取效率。文中提供了完整的UrlManager类代码示例,帮助开发者掌握去重逻辑的具体实现。
本文介绍Python爬虫在遇到登录验证(如验证码、拖拽)时的两种主流解决方案:Cookie注入与模拟登录。通过获取浏览器Cookie并利用requests库复用会话,可绕过多数验证机制;同时简述基于requests的模拟登录思路。文中包含完整代码示例,展示如何配置代理、设置Cookie及处理登录状态,帮助开发者高效解决登录墙问题。
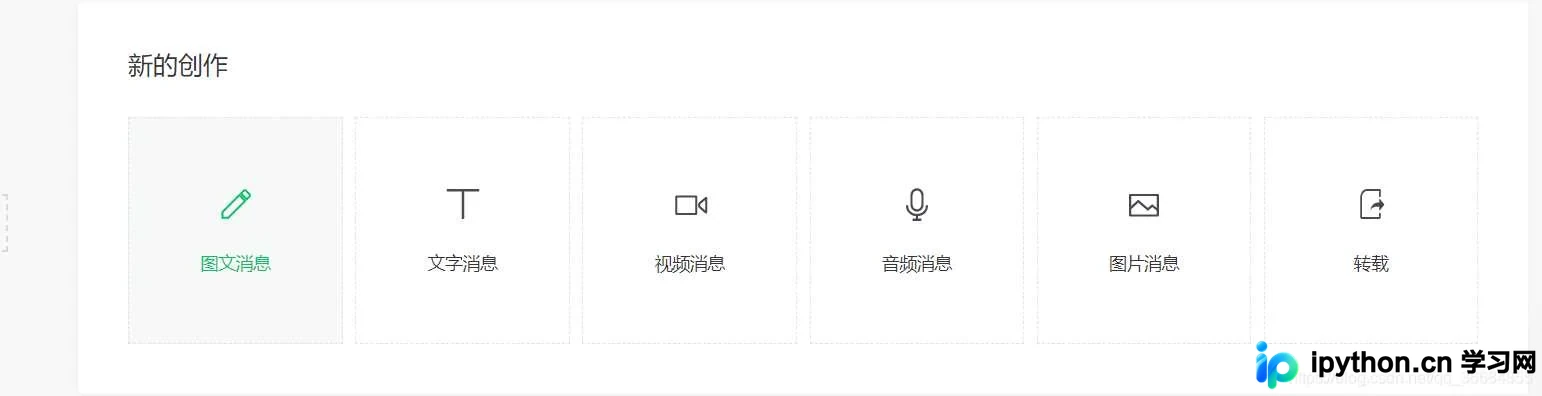
本文详细解析利用 Python 爬取微信公众号文章的完整流程。通过 Selenium 模拟登录获取 Cookie 和 Token,结合 Requests 调用 searchbiz 与 appmsg 接口,提取 fakeid 并批量抓取文章数据。文中提供关键代码示例,并强调设置请求延迟以避免账号封禁的风险,适合希望掌握微信生态数据抓取技术的开发者参考。
本文针对Python初学者及数据需求者,梳理了主流爬虫工具。重点对比了云爬虫与本地采集器的区别,并详细解析了神箭手、八爪鱼和集搜客GooSeeker三大工具的核心功能与优势,涵盖自动化、可视化操作及反爬技术,助力高效获取网页数据。
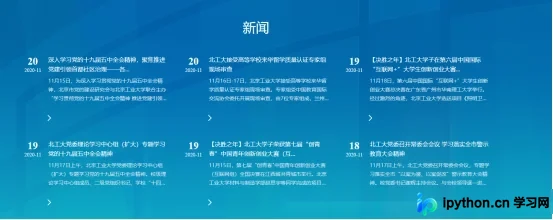
本文详细介绍如何使用Python编写一个自动化脚本,定时从北京工业大学官网抓取新闻数据。通过requests和BS4解析HTML,利用pymysql将数据存入MySQL数据库,并结合smtplib实现邮件自动发送。文章涵盖环境配置、代码逻辑分析及schedule定时器的使用方法,适合初学者参考。
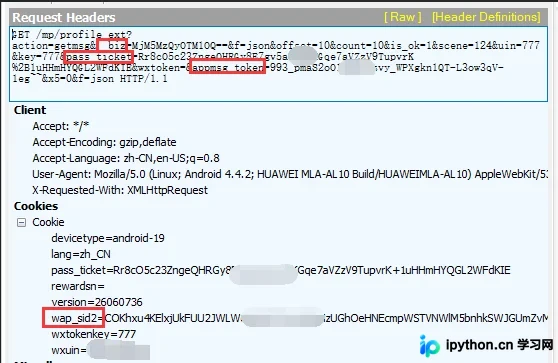
本文介绍利用Python模拟安卓微信App操作,通过抓包获取__biz、appmsg_token等关键参数,进而构造HTTP请求直接调用API接口,实现指定公众号历史文章数据的批量采集。
本文详解Python分布式爬虫的实现方法,重点介绍如何利用Celery将抓取任务分发至多台服务器。通过配置不同的Worker队列(如login_queue、user_crawler等),实现登录、用户信息、粉丝关注等任务的隔离与并行处理,提升数据采集效率。
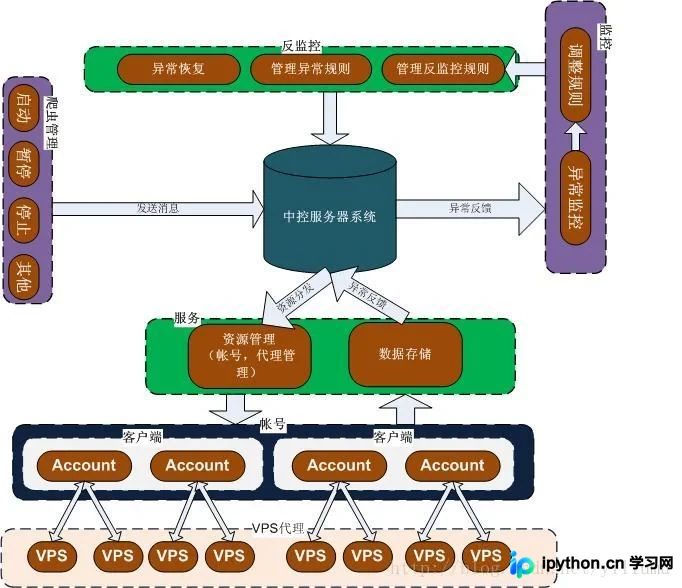
本文详细解析Python分布式爬虫中消息队列的核心作用,通过生活化类比阐释其去重与任务分发机制。重点介绍如何利用Redis队列构建生产端,实现多爬虫节点对URL任务的有序获取与高效处理,避免重复爬取,为构建高性能分布式爬虫系统提供实践参考。
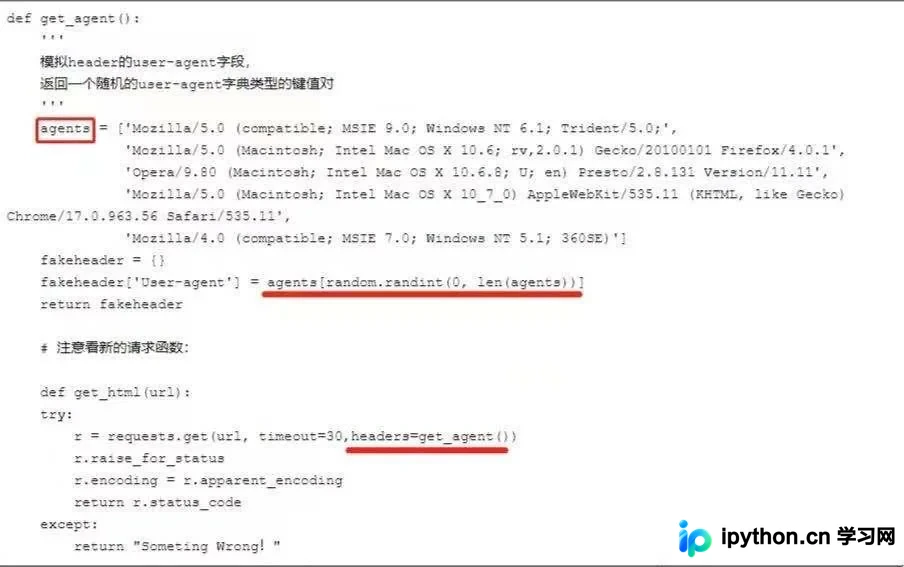
本文深入分析Python爬虫中两种主流反反爬策略:User-Agent伪装与IP代理池。通过对比两者在技术实现、成本及稳定性上的差异,指出UA易被伪造但成本低,而代理池虽能绕过IP限制却面临质量参差不齐的挑战。文章旨在帮助开发者根据实际场景选择最优方案,平衡抓取效率与合规性。
本文介绍Python爬虫中利用requests库优化服务器响应速度的方法。通过设置allow_redirects参数控制重定向行为,使用timeout参数限制请求等待时间以避免长时间挂起,并演示如何配置代理服务器以增强爬取稳定性。