

Python 微信公众号文章爬取实战:接口分析与代码实现

本文详细解析利用 Python 爬取微信公众号文章的完整流程。通过 Selenium 模拟登录获取 Cookie 和 Token,结合 Requests 调用 searchbiz 与 appmsg 接口,提取 fakeid 并批量抓取文章数据。文中提供关键代码示例,并强调设置请求延迟以避免账号封禁的风险,适合希望掌握微信生态数据抓取技术的开发者参考。
爬取思路与接口分析
一.思路
我们的核心策略是利用网页版微信公众平台中图文消息的超链接,逆向追踪并定位到后端的数据接口。
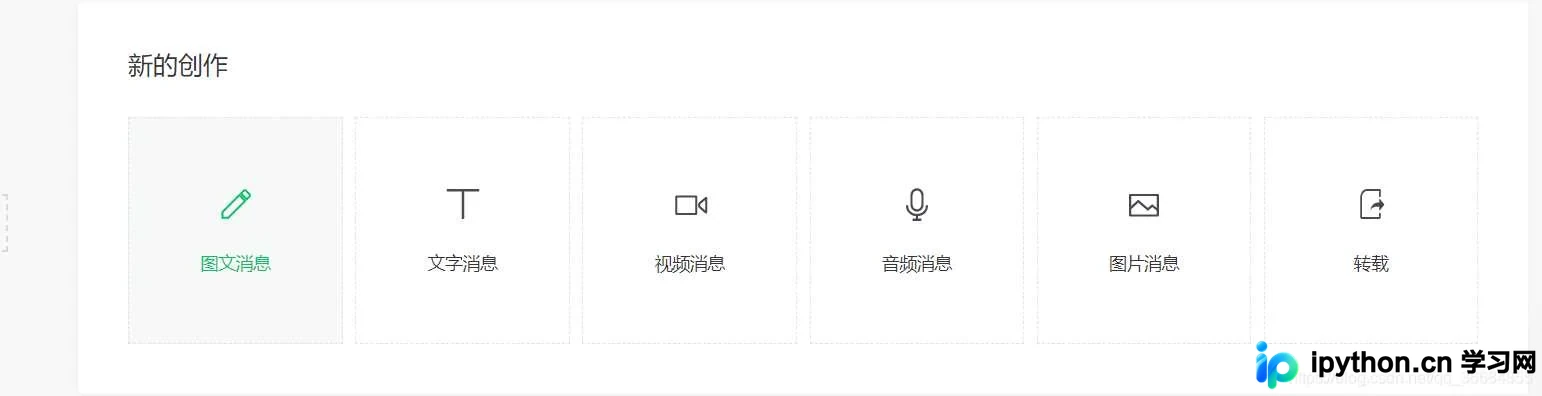

一旦成功对接该接口,即可获取目标微信公众号的基本信息,以及该公众号下发布的所有文章列表。
二.接口分析
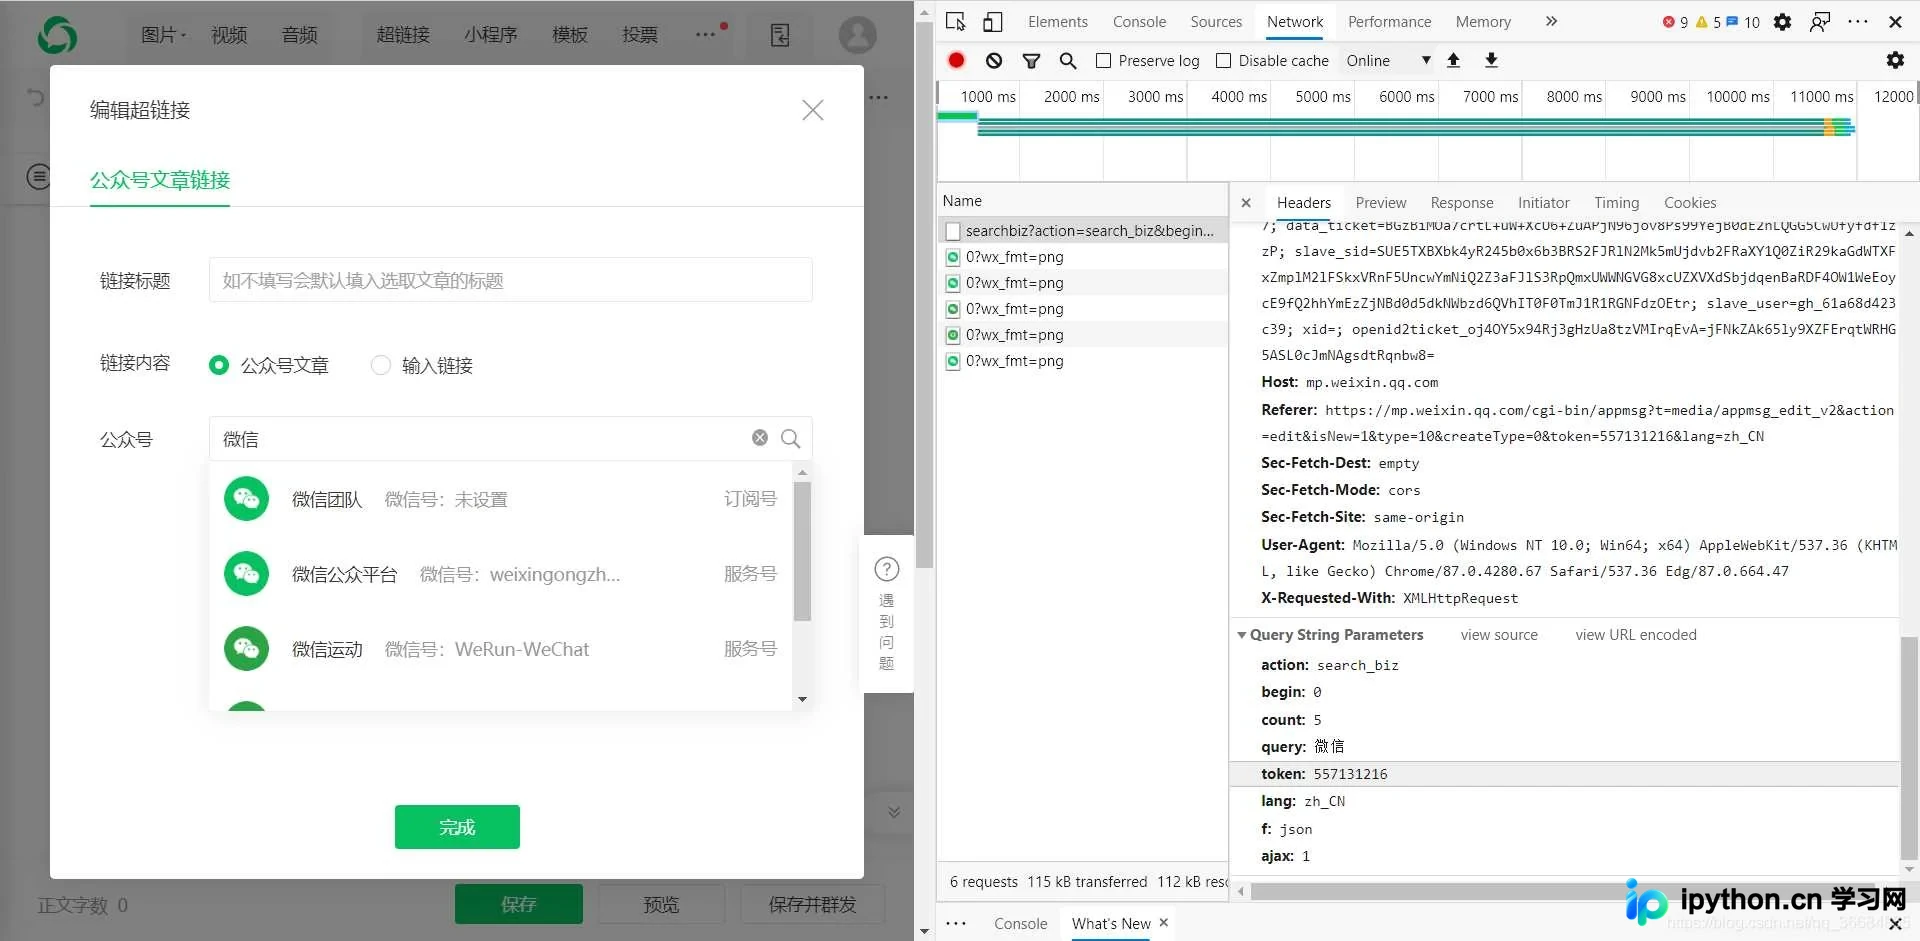
获取微信公众号信息的接口地址为: https://mp.weixin.qq.com/cgi-bin/searchbiz? 该接口所需的参数包括: action=search_biz begin=0 count=5 query=公众号名称 token=每个账号对应的token值 lang=zh_CN f=json ajax=1 请求方式: GET 因此,该接口的关键在于获取 token 值,而 query 参数指定了需要搜索的公众号名称。token 可以通过登录后的网页链接直接获取。
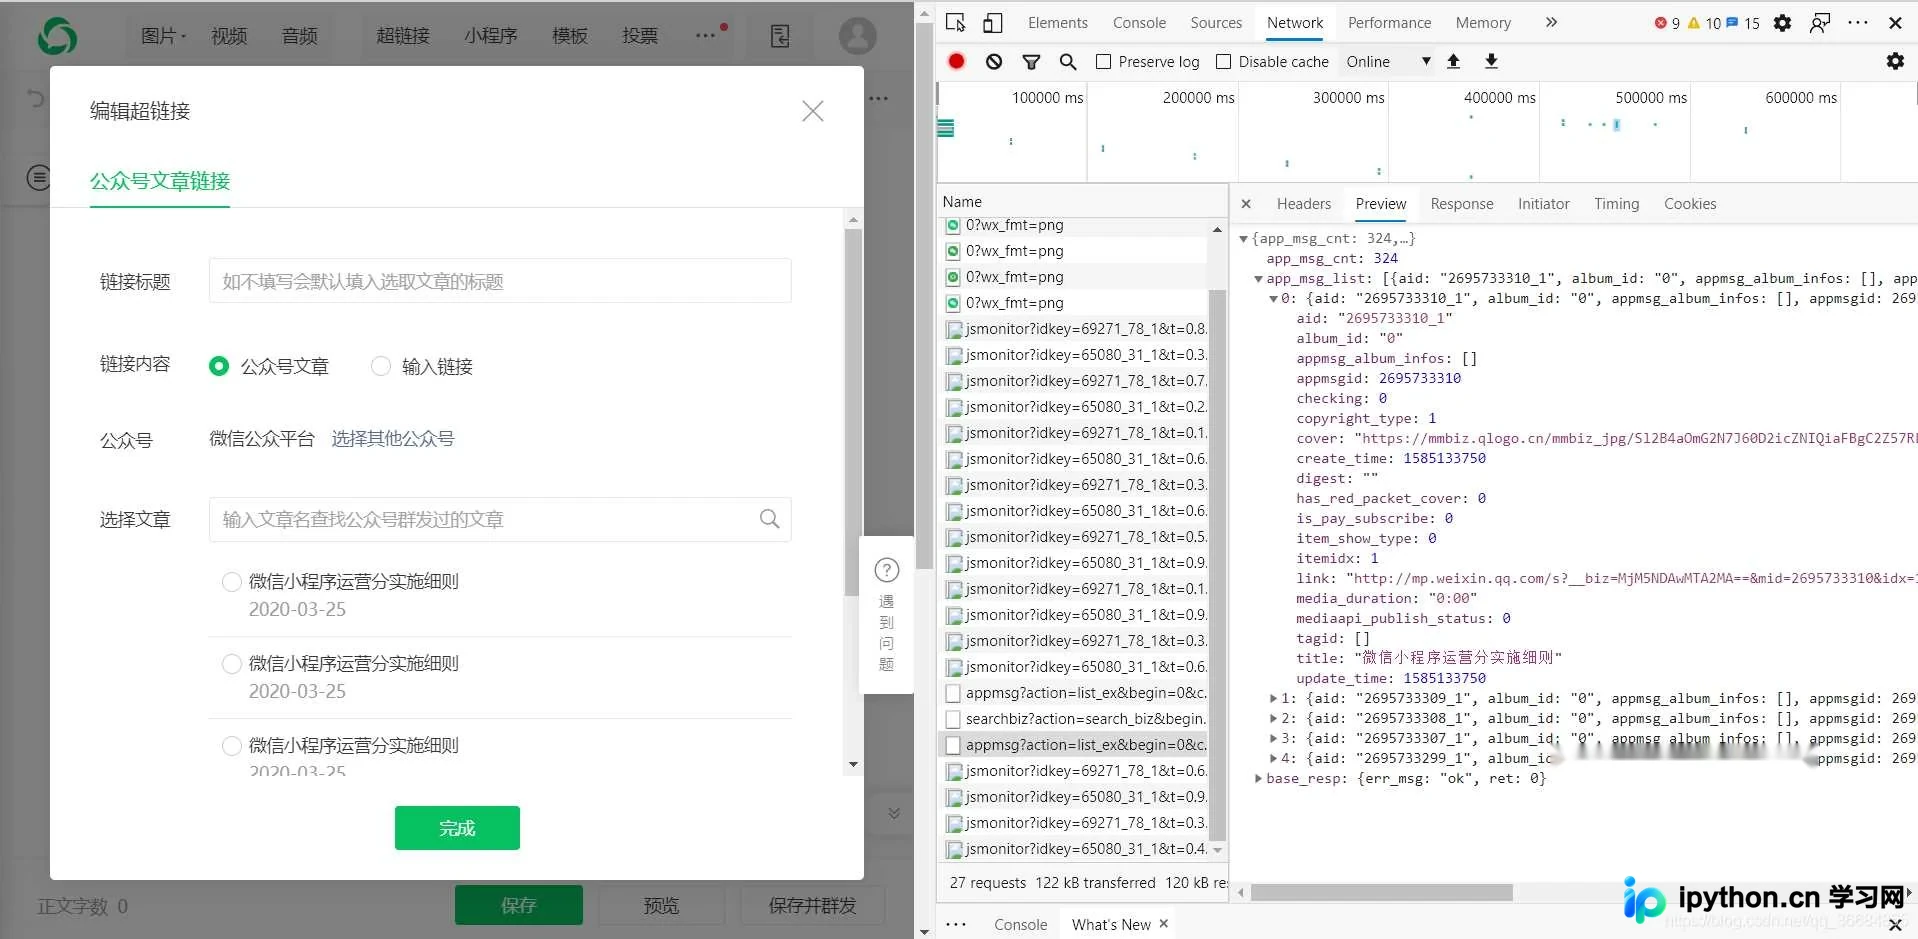
获取对应公众号文章列表的接口地址为: https://mp.weixin.qq.com/cgi-bin/appmsg? 该接口所需的参数包括: action=list_ex begin=0 count=5 fakeid=MjM5NDAwMTA2MA== type=9 query= token=557131216 lang=zh_CN f=json ajax=1 请求方式: GET 在此接口中,我们需要传入上一步获取的 token 以及 fakeid,而 fakeid 正是通过第一个接口返回的数据中获得的。通过这两个接口的配合,我们便能获取到微信公众号文章的详细数据。
代码实现步骤
三.实现
第一步:
首先,我们需要利用 Selenium 库模拟人工登录过程,从而获取有效的 Cookie 和对应的 Token 值。
def weChat_login(user, password):
  post = {}
  browser = webdriver.Chrome()
  browser.get('https://mp.weixin.qq.com/')
  sleep(3)
  browser.delete_all_cookies()
  sleep(2)
  # 点击切换到账号密码输入
  browser.find_element_by_xpath("//a[@class='login__type__container__select-type']").click()
  sleep(2)
  # 模拟用户点击
  input_user = browser.find_element_by_xpath("//input[@name='account']")
  input_user.send_keys(user)
  input_password = browser.find_element_by_xpath("//input[@name='password']")
  input_password.send_keys(password)
  sleep(2)
  # 点击登录
  browser.find_element_by_xpath("//a[@class='btn_login']").click()
  sleep(2)
  # 微信登录验证
  print('请扫描二维码')
  sleep(20)
  # 刷新当前网页
  browser.get('https://mp.weixin.qq.com/')
  sleep(5)
  # 获取当前网页链接
  url = browser.current_url
  # 获取当前cookie
  cookies = browser.get_cookies()
  for item in cookies:
    post[item['name']] = item['value']
  # 转换为字符串
  cookie_str = json.dumps(post)
  # 存储到本地
  with open('cookie.txt', 'w+', encoding='utf-8') as f:
    f.write(cookie_str)
  print('cookie保存到本地成功')
  # 对当前网页链接进行切片,获取到token
  paramList = url.strip().split('?')[1].split('&')
  # 定义一个字典存储数据
  paramdict = {}
  for item in paramList:
    paramdict[item.split('=')[0]] = item.split('=')[1]
  # 返回token
  return paramdict['token']
定义一个登录方法,接收账号和密码作为参数,并初始化一个字典用于存储 Cookie 数据。该方法模拟用户输入账号密码并点击登录按钮,随后会出现扫码验证环节,需使用登录的微信进行扫码确认。 完成扫码后,刷新当前网页,提取当前的 Cookie 以及 URL 中的 Token,并将结果返回。
第二步:
1.请求获取对应公众号接口,提取我们需要的 fakeid
 url = 'https://mp.weixin.qq.com'
  headers = {
    'HOST': 'mp.weixin.qq.com',
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.183 Safari/537.36 Edg/86.0.622.63'
  }
  with open('cookie.txt', 'r', encoding='utf-8') as f:
    cookie = f.read()
  cookies = json.loads(cookie)
  resp = requests.get(url=url, headers=headers, cookies=cookies)
  search_url = 'https://mp.weixin.qq.com/cgi-bin/searchbiz?'
  params = {
    'action': 'search_biz',
    'begin': '0',
    'count': '5',
    'query': '搜索的公众号名称',
    'token': token,
    'lang': 'zh_CN',
    'f': 'json',
    'ajax': '1'
  }
  search_resp = requests.get(url=search_url, cookies=cookies, headers=headers, params=params)
将之前获取的 token 和 Cookie 传入,通过 requests.get 发起请求,从而获得包含微信公众号信息的 JSON 数据。
lists = search_resp.json().get('list')[0]通过上述代码逻辑,即可成功获取到对应的公众号基础数据。
fakeid = lists.get('fakeid')从返回的 JSON 数据中,可以进一步解析出对应的 fakeid。
2.请求获取微信公众号文章接口,提取我们需要的文章数据
 appmsg_url = 'https://mp.weixin.qq.com/cgi-bin/appmsg?'
  params_data = {
    'action': 'list_ex',
    'begin': '0',
    'count': '5',
    'fakeid': fakeid,
    'type': '9',
    'query': '',
    'token': token,
    'lang': 'zh_CN',
    'f': 'json',
    'ajax': '1'
  }
  appmsg_resp = requests.get(url=appmsg_url, cookies=cookies, headers=headers, params=params_data)
我们将上一步获得的 fakeid 和 token 作为参数,再次调用 requests.get 请求文章接口,从而获得返回的 JSON 数据。 至此,我们实现了对微信公众号文章的自动化爬取。
注意事项与总结
四.总结
通过本示例对微信公众号文章的爬取,需要熟练掌握 Selenium 和 Requests 库的使用,并具备分析请求接口的能力。特别需要注意的是,在循环获取文章数据时,务必设置合理的延迟时间,否则极易导致账号被封禁,进而无法获取返回数据。
到此这篇关于Python 微信公众号文章爬取的示例代码的文章就介绍到这了,更多相关Python 微信公众号文章爬取内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









