

Python分布式爬虫实现:基于Celery的任务分发与Worker配置

本文详解Python分布式爬虫的实现方法,重点介绍如何利用Celery将抓取任务分发至多台服务器。通过配置不同的Worker队列(如login_queue、user_crawler等),实现登录、用户信息、粉丝关注等任务的隔离与并行处理,提升数据采集效率。
分布式爬虫分工协作原理
在进行大规模卫生清洁时,通常会将工作划分为不同区域,由专人负责特定项目,这种分工协作模式同样适用于Python分布式爬虫系统。在分布式爬虫架构中,我们需要向不同的爬虫节点发送指令,使其协同工作以获取目标网站的数据。那么,这些分布式节点是如何具体分工并高效搜集数据的呢?接下来我们将通过具体示例进行解析。
多服务器Worker配置与任务分发
假设环境中存在三台爬虫服务器,分别标记为A、B和C。我们的目标是将所有账号登录任务均匀分散到这三台服务器上,同时指定用户信息抓取任务由服务器A和B执行,而粉丝及关注列表的抓取任务则由服务器C专门负责。为了实现这一分工,我们需要在A、B、C三台服务器上分别启动对应的Celery Worker进程,具体的启动命令如下所示。
对于服务器A和B,启动Worker的命令为:celery -A tasks.workers -Q login_queue,user_crawler worker -l info -c 1。该配置确保这两台服务器仅处理登录队列和用户信息抓取队列中的任务,忽略其他无关请求。
对于服务器C,启动Worker的命令为:celery -A tasks.workers -Q login_queue,fans_followers worker -l info -c 1。此配置使服务器C专注于处理登录、粉丝列表及关注列表的抓取任务,不与用户信息抓取任务冲突。
完成Worker配置后,我们可以通过命令行接口或编写Python代码(如下所示)来发送任务,从而驱动各个节点执行具体的抓取操作。
核心抓取任务代码实现
# coding:utf-8
from tasks.workers import app
from page_get import user as user_get
from db.seed_ids import get_seed_ids, get_seed_by_id, insert_seeds, set_seed_other_crawled
@app.task(ignore_result=True)
def crawl_follower_fans(uid):
  seed = get_seed_by_id(uid)
  if seed.other_crawled == 0:
    rs = user_get.get_fans_or_followers_ids(uid, 1

    rs.extend(user_get.get_fans_or_followers_ids(uid, 2))
    datas = set(rs)
    # 重复数据跳过插入
    if datas:
      insert_seeds(datas)
    set_seed_other_crawled(uid)
@app.task(ignore_result=True)
def crawl_person_infos(uid):
  ""
  根据用户i来爬取用户相关资料和用户的关注数和粉丝数(由于微博服务端限制,默认爬取前五页,企业号的关注和粉丝也不能查看)
  :param uid: 用户id
  :return:
  """
  if not uid:
    return
  # 由于与别的任务共享数据表,所以需要先判断数据库是否有该用户信息,再进行抓取
  user = user_get.get_profile(uid)
  # 不抓取企业号
  if user.verify_type == 2:
    set_seed_other_crawled(uid)
    return
  app.send_task('tasks.user.crawl_follower_fans', args=(uid,), queue='fans_followers',
         routing_key='for_fans_followers')
@app.task(ignore_result=True)
def excute_user_task():
  seeds = get_seed_ids()
  if seeds:
    for seed in seeds:
      # 在send_task的时候指定任务队列
      app.send_task('tasks.user.crawl_person_infos', args=(seed.uid,), queue='user_crawler',
             routing_key='for_user_info')
分布式爬虫架构图解析
下图展示了上述分布式爬虫系统的整体架构设计,清晰呈现了任务分发与节点处理的逻辑关系。
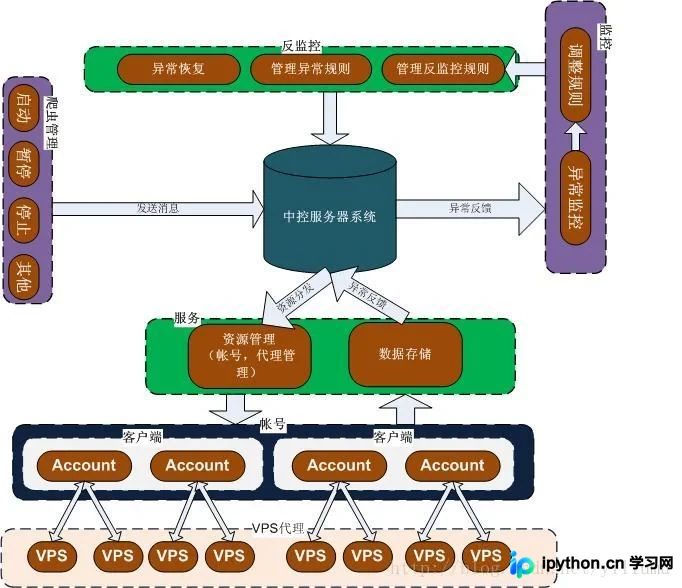
至此,关于Python分布式爬虫获取数据的实例方法已介绍完毕。如需了解更多关于Python爬虫如何分布式获取数据的相关内容,建议搜索本站历史文章或继续浏览后续系列教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









