Python字符串驻留机制详解:原理、时机与性能影响
本文深入解析Python字符串驻留机制,探讨其通过interned字典实现内存共享的原理。详细列举了自动驻留的时机,包括短字符串、编译时优化及特定字符规则。同时分析了驻留在提升比较效率(O(1))与增加创建开销之间的权衡,帮助开发者理解如何利用该机制优化代码性能。
2026-10-14
6

本文深入解析Python字符串驻留机制,探讨其通过interned字典实现内存共享的原理。详细列举了自动驻留的时机,包括短字符串、编译时优化及特定字符规则。同时分析了驻留在提升比较效率(O(1))与增加创建开销之间的权衡,帮助开发者理解如何利用该机制优化代码性能。
本文详解在Python中替换NumPy数组中大于特定阈值元素的多项技术。通过对比基础循环、布尔索引、np.minimum、np.clip以及np.putmask等方法的执行效率,结合MRI图像处理的实际场景,推荐在需要原地修改或限制数值范围时优先使用内置函数,以实现代码简洁性与运行速度的最佳平衡。
本文介绍如何利用Python将多条SQL语句封装在BEGIN...END块中一次性提交,以减少数据库连接与网络传输开销,显著降低模型运行耗时。针对Oracle数据库唯一约束冲突(ORA-00001)问题,提供了基于字典去重并保留高权重因子的解决方案。同时补充了PostgreSQL中使用%s占位符时必须添加引号的注意事项,旨在提供高效且稳定的数据库交互方案。
本文介绍Python标准库linecache模块,通过getline方法快速获取文件指定行内容。该方法由traceback模块内部使用,支持从sys.path查找文件。若行号超出范围或文件不存在,均返回空字符串而不报错。针对大文件读取效率低的问题,提供了基于enumerate的手动遍历替代方案,需注意行号从1开始计数。
本文深入解析Python requests库中Session类的长连接机制,指出默认基于host的连接管理在多域名或子域名场景下的性能缺陷。通过自定义HTTPAdapter,结合scheme、主域名、IP及端口构建更精细的连接池键值,有效解决IP轮询和子域名复用问题,显著提升高并发爬虫及分布式系统的网络IO效率。
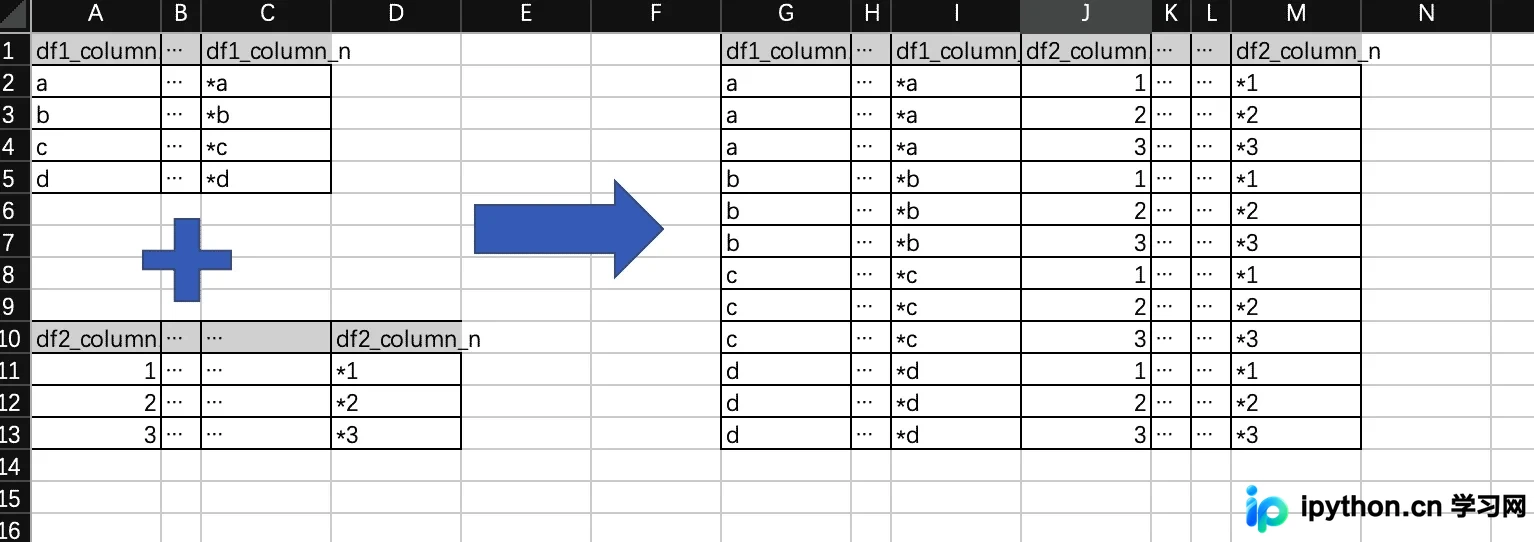
本文介绍如何在Python中高效计算两个Dataframe的笛卡尔积。通过对比双重循环法与基于Merge的优化法,展示了利用Pandas内置功能将时间复杂度从O(m*n)降低至O(n)的技巧,并提供了具体的代码实现与性能测试数据,帮助开发者解决大数据量下的合并性能瓶颈。
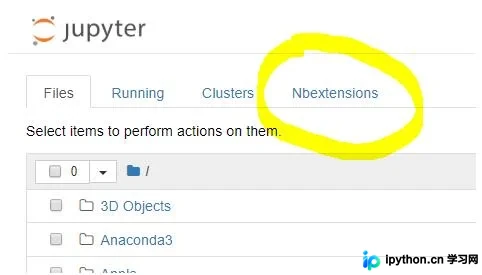
本文介绍在Jupyter Notebook中查看单元格运行时间的两种方法:通过安装jupyter_contrib_nbextensions启用Execute Time插件,以及使用%time和%%time Magic命令进行代码性能分析。详细解释了CPU时间与Wall time的区别,帮助用户优化代码执行效率。
本文探讨如何在Python中通过多线程技术加速耗时的For循环操作。针对大规模数据(如千万级记录)处理场景,通过示例展示如何将串行处理改为并行处理,利用multiprocessing.dummy模块中的ThreadPool实现并发执行,显著减少运行时间,并提供具体代码实现与性能对比结果。
本文介绍Django中F表达式在更新数据库字段时的应用。相比传统加载内存方式,F表达式直接生成SQL语句,显著提升大量数据更新性能。文章涵盖单对象与批量更新的代码示例,并重点强调更新后调用refresh_from_db()获取最新字段值的重要性,避免数据不一致问题。
本文深入解析Python中双下划线的魔法方法,涵盖__init__、__getattr__、__slots__及__enter__/__exit__等核心机制,并演示如何通过类方法、装饰器及元类实现单例模式,帮助开发者优化内存使用并掌握高级面向对象编程技巧。
本文深入解析Python中类属性的动态绑定机制,探讨实例调用类方法时的实时查找过程。通过对比实验量化动态绑定与静态绑定的性能差异,指出在低频次调用下开销可忽略,但在千万级循环中会产生显著时间损耗。同时分析动态绑定在灵活性上的优势,帮助开发者理解其适用场景与潜在影响。
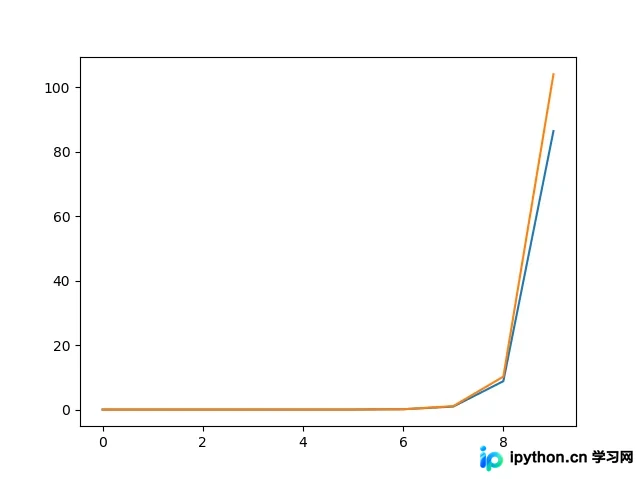
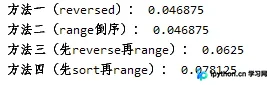
本文详细解析Python中列表倒序输出的四种常见方法,包括使用reversed()、range()、reverse()结合range以及sort()结合range。通过百万至亿级数据量的实测对比,分析各方法的时间效率与内存占用,指出reversed()因返回迭代器而在大数据量下更具优势,建议在实际开发中优先选用以优化性能。