

pandas.DataFrame.drop_duplicates 参数详解与去重实战

本文详细介绍pandas库中DataFrame.drop_duplicates函数的使用方法,重点解析subset、keep和inplace三个核心参数的具体含义与配置选项。通过实际代码示例,演示如何指定列进行去重、保留首尾重复项或完全删除重复数据,帮助开发者高效处理数据清洗中的重复值问题。
drop_duplicates 函数签名
如下所示:
DataFrame.drop_duplicates(subset=None, keep='first', inplace=False)
核心参数说明
subset参数用于指定考虑重复值的列,默认值为None表示检查所有列,即只要任意一列出现重复即视为重复数据。
keep参数接受first、last或False三个选项。first表示保留首次出现的重复数据,删除后续重复项;last表示保留最后一次出现的重复数据,删除之前的重复项;False则表示删除所有重复数据,不保留任何一行。默认值为first。
补充知识:python3删除数据重复值,只保留第一项。drop_duplicates()函数使用介绍
去重实战示例
原始数据如下:
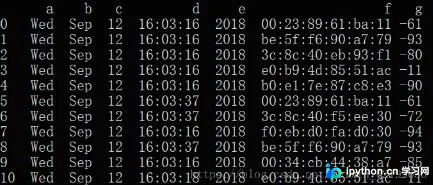
f 列的前3个数据都有重复项,现在要将重复值删去,只保留第一项或最后一项。
使用drop_duplicates()
drop_duplicates(self, subset=None, keep='first', inplace=False)
subset :如['a']代表a列中的重复值全部被删除
keep:保留第一个值,参数为first,last
inplace:是否替换原来的df,默认为False
代码实现与结果分析
import pandas as pd
data = pd.read_table("C:/Users/xujinhua/Desktop/aa/a.txt",header=None, names=['a','b','c','d','e','f','g'])
#读取文件数据,并将列命名为abcdef
data.drop_duplicates(subset='f', keep='first', inplace=True)
print(data)
结果:
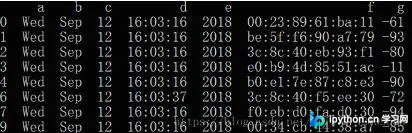
可以看到 f 列中的重复值都被删除,且保留了第一项
以上这篇pandas.DataFrame.drop_duplicates 用法介绍就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









