pandas DataFrame 新增列、行及数据筛选操作详解
本文详细介绍在 pandas 中如何对 DataFrame 进行列和行的增删改查。涵盖通过直接赋值、assign、insert 方法添加新列,利用 concat 进行水平或垂直连接,以及使用 append 添加行的技巧。同时讲解如何根据条件筛选特定列和行,修改列值及处理缺失数据,提供完整代码示例。
2026-10-15
7

本文详细介绍在 pandas 中如何对 DataFrame 进行列和行的增删改查。涵盖通过直接赋值、assign、insert 方法添加新列,利用 concat 进行水平或垂直连接,以及使用 append 添加行的技巧。同时讲解如何根据条件筛选特定列和行,修改列值及处理缺失数据,提供完整代码示例。
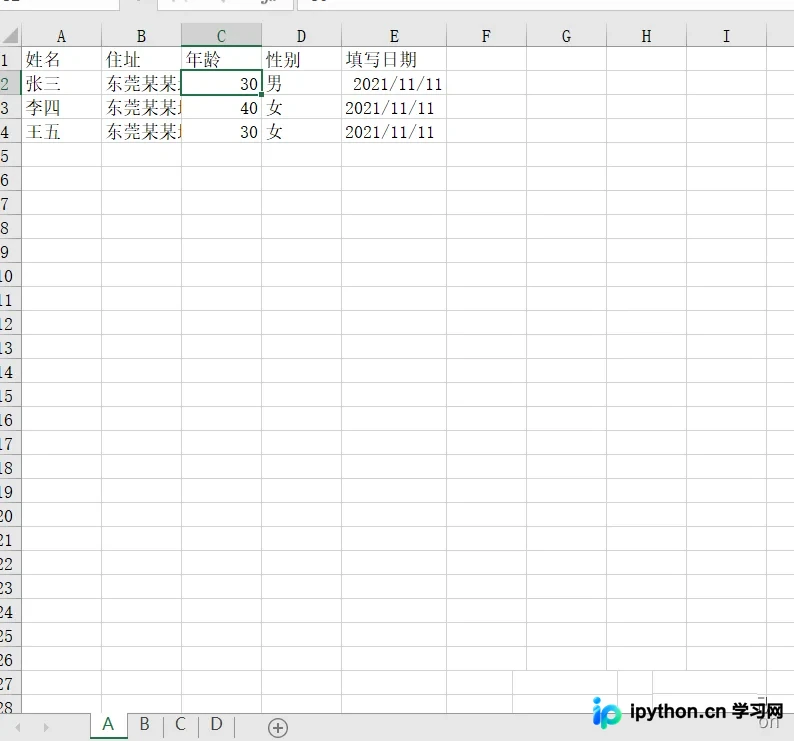
本文详解如何利用Python的Pandas库高效处理包含多个Sheet的Excel文件。通过sheet_name=None参数一次性读取所有工作表,遍历字典对象进行数据清洗(如新增列),并使用ExcelWriter将处理后的多份数据批量写入新Excel文件的对应Sheet中,实现自动化数据处理流程。
本文介绍了在 Python 中将数据写入 CSV 文件的两种常用方法。针对深度学习训练中每个 epoch 记录准确率的需求,分别演示了使用内置 csv 模块和 pandas 库进行追加写入的操作。重点讲解了如何处理追加模式下的表头重复问题,并提供了对应的代码示例与结果展示,帮助开发者快速实现日志数据的持久化存储。
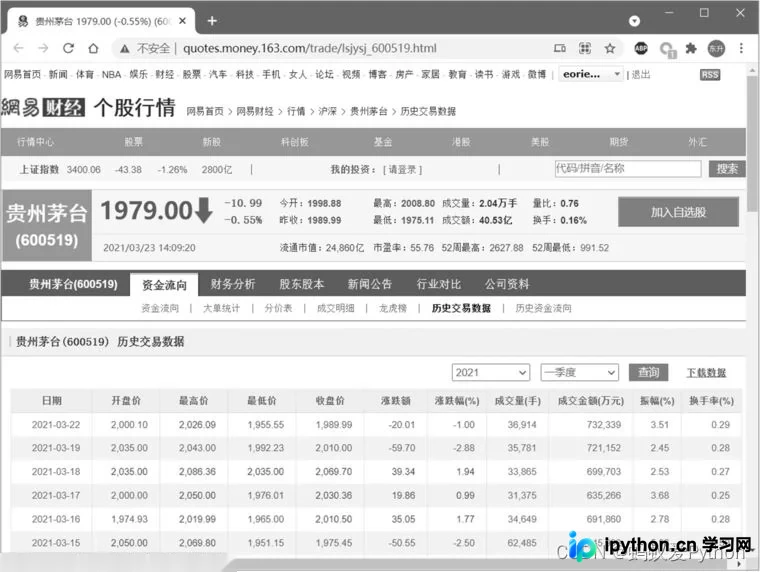
本文介绍如何使用Python获取并可视化贵州茅台股票的历史交易数据。通过网易财经下载CSV格式数据,利用Pandas进行时间范围筛选与排序,并结合Matplotlib库绘制成交量折线图及OHLC(开高低收)多线图表,直观展示股票交易趋势。
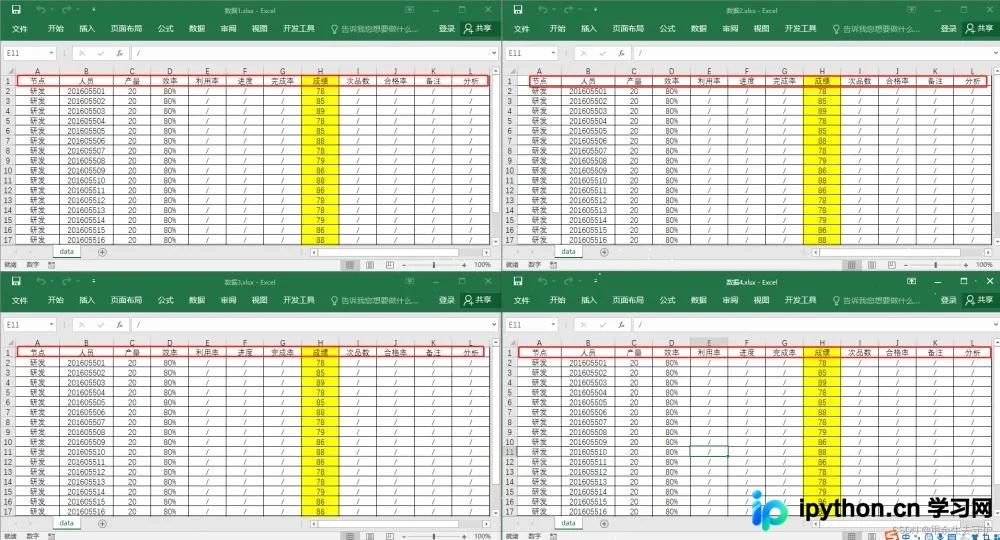
本文介绍如何使用Python脚本,按列索引从包含多个Excel文件的文件夹中提取指定列数据,并将结果汇总到一个新的Excel文件中。文章详细说明了代码注意事项,如文件夹内文件限制及结果文件处理,并提供了完整的Python实现代码示例,帮助开发者高效处理批量Excel数据。
本文详细介绍如何在Pandas DataFrame中插入新列。通过解析insert(loc, column, value)函数的核心参数,演示了将列插入首列、中间及末尾的具体代码示例。此外,补充了基于条件判断对特定数据子集进行列赋值的实用技巧,帮助开发者灵活处理表格数据结构。
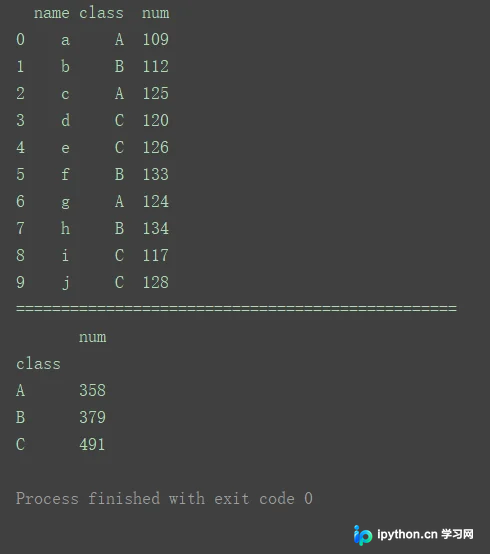
本文详细介绍Python中Pandas库DataFrame数据分组统计的核心函数groupby()。内容涵盖基础的一级与多级分类求和、指定列索引统计、分组数据迭代遍历,以及结合agg()函数实现多列不同聚合计算和自定义函数应用。此外,还演示了如何利用字典和Series对象进行灵活分组,帮助开发者高效处理复杂数据分析任务。
本文介绍在pandas中将DataFrame多列合并为一列的两种主要方法:使用+运算符直接拼接和使用str.cat方法。重点解析str.cat函数的参数sep、na_rep和join,处理数据类型转换、缺失值填充及长度不一致时的合并策略,并提供具体代码范例。
本文深入解析Python生态中十大核心库,涵盖数据处理、机器学习与可视化领域。从Pandas的数据清洗到NumPy的高效数组计算,再到Scikit-learn的建模与TensorFlow、Keras的深度神经网络实现,最后介绍Gradio、SciPy、Statsmodels、Plotly及Seaborn在模型部署、科学计算与动态可视化中的关键作用,助您构建完整的AI工作流。
本文详解Pandas中groupby的核心用法,涵盖单列与多列分组、多种聚合函数应用及自定义聚合。通过遍历groupby对象深入理解执行流程,并结合北京天气数据实例,演示如何计算月度最高温、均质指数等统计指标,帮助开发者掌握高效的数据分组处理技巧。
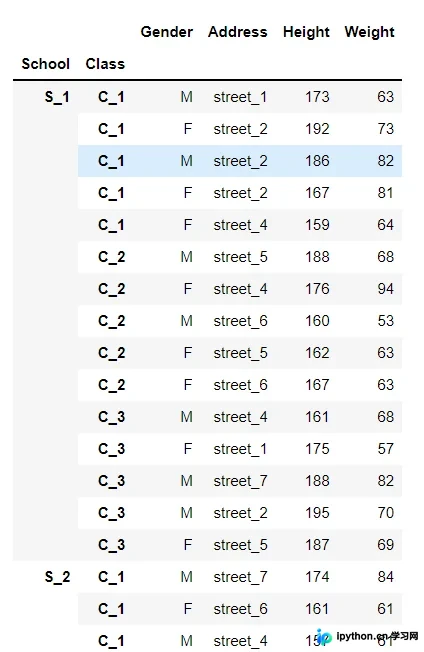
本文详解pandas中多级索引数据的提取技巧。通过重置索引为列并结合布尔条件或query方法,以及利用链式调用和元组索引直接取值,解决多层级数据查找问题。文章对比两种方法的操作步骤与注意事项,帮助开发者高效处理复杂索引结构。
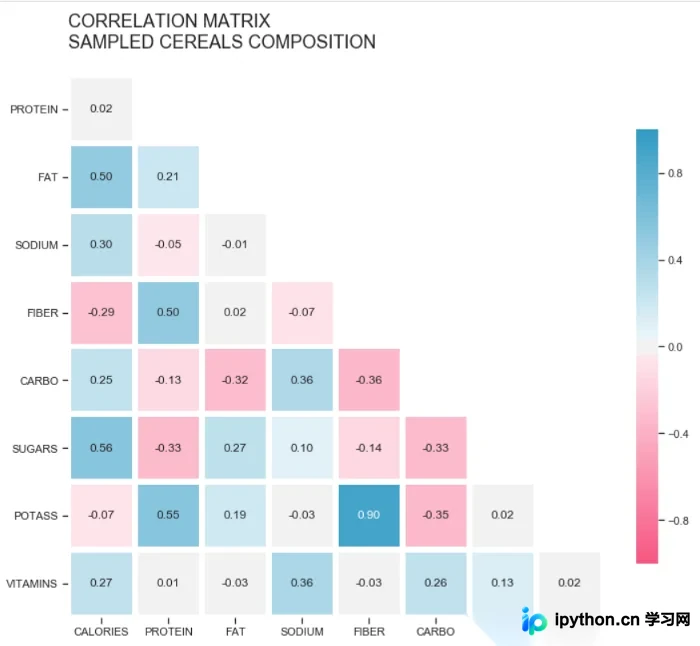
本文详细介绍如何使用Python的Seaborn库绘制高质量热力图。内容涵盖从导入Pandas和Numpy进行数据预处理开始,通过corr()计算相关性矩阵,利用Mask矩阵去除冗余上三角区域,以及调整参数显示具体数值。此外,还深入讲解了如何使用diverging_palette优化发散型调色板,提升视觉表现力,最终生成带有标题和格式优化的专业级相关性热力图。