利用Pandas读取表格行数据判断是否相同的方法
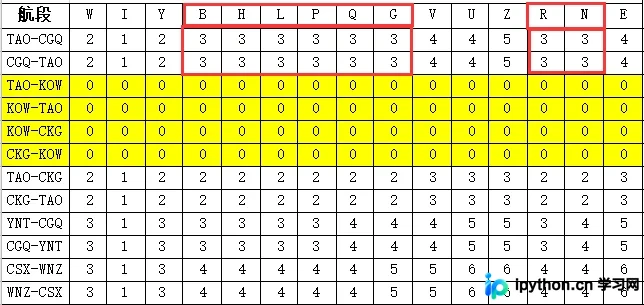
本文介绍如何使用Python的Pandas库自动化处理Excel表格数据。通过读取Excel文件,提取航线、舱位及价格信息,程序遍历每一行数据,找出数值相同的列索引,将对应的舱位字母合并,并提取返点价格。最终生成包含航线、合并舱位及价格的标准化结果列表,适用于供应链部门每周重复性数据清洗任务,替代手工操作。
2026-10-14
6

本文介绍如何使用Python的Pandas库自动化处理Excel表格数据。通过读取Excel文件,提取航线、舱位及价格信息,程序遍历每一行数据,找出数值相同的列索引,将对应的舱位字母合并,并提取返点价格。最终生成包含航线、合并舱位及价格的标准化结果列表,适用于供应链部门每周重复性数据清洗任务,替代手工操作。
本文介绍如何在Python中使用Pandas库高效实现DataFrame的行列转置。通过利用numpy内置矩阵转置方法,可显著提升处理速度,适用于数据长度不确定或需优化获取效率的场景。
本文详细介绍pandas中多层索引(MultiIndex)的创建方法,包括通过列表、numpy随机数及from_product函数构建Series和DataFrame。重点讲解利用[]和loc进行层级取值及切片操作,并演示sort_index按层级排序的具体用法,帮助开发者高效处理高维数据。
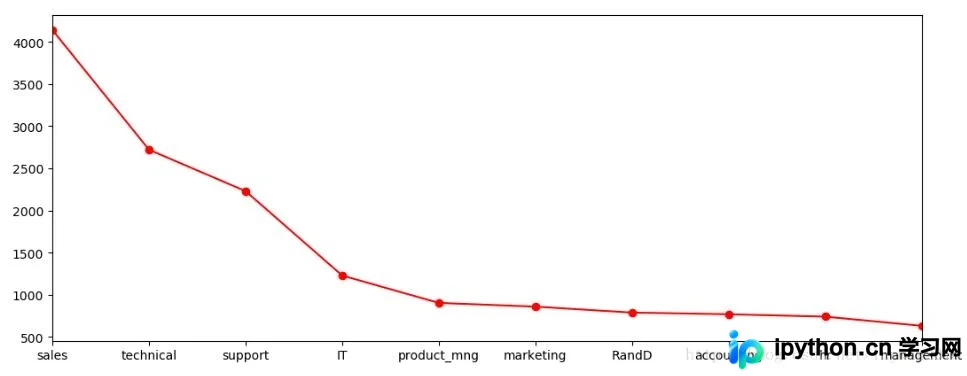
本文详解Python中matplotlib与pandas库的绘图方法。涵盖折线图、柱状图、饼图、箱型图及子图布局等常见统计图表的生成代码。重点解析帕累托分析、异常值注释及多条件筛选技巧,提供可直接运行的示例代码,帮助开发者快速掌握数据可视化核心技能。
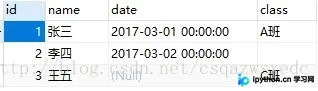
本文详解Python向MySQL插入NULL值的方法,区分%s占位符加不加引号的差异。深入对比数据库中NULL与空字符的区别,以及Python中None、Pandas中NaN与数据库NULL的对应关系,帮助开发者避免数据读取与写入时的类型错误。
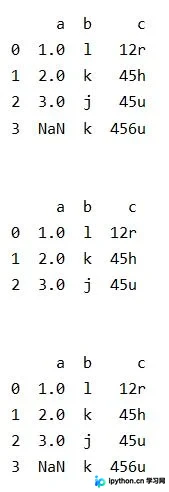
本文详细解析Python pandas库中dropna()与notnull()函数在处理DataFrame空值时的行为差异。通过对比全局操作与指定列操作的返回值类型(Series vs DataFrame)及过滤逻辑,帮助开发者准确选择空值处理策略,避免数据丢失或类型错误。
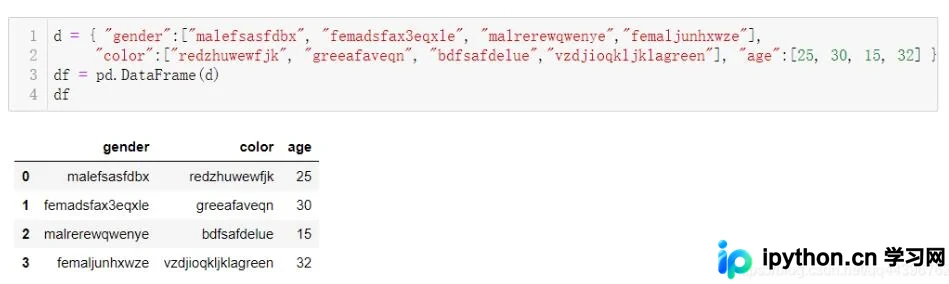
本文介绍利用 Pandas 和 fuzzywuzzy 进行数据模糊查询与替换的完整流程。涵盖从数据导入、清洗、筛选到多条件文本匹配的核心代码示例,重点解析如何通过列表推导式结合 str.contains() 实现高效的多条件模糊筛选,适用于大量文本数据的快速处理与标准化。
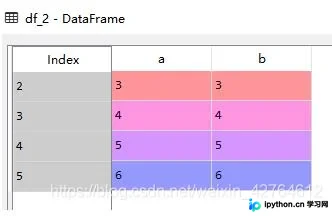
本文详细介绍 pandas 中 query() 函数的用法,涵盖基于列的代数式过滤、SQL 风格的 in/not in 操作以及包含外部变量引用的复杂表达式。通过具体代码示例解析 @x.name 等符号含义,帮助开发者高效实现 DataFrame 的条件筛选与数据提取。
本文介绍如何利用pandas的apply方法结合axis=1参数,对DataFrame的多列数据进行行级计算并生成新列。通过具体代码示例演示了如何定义lambda函数处理多列数据,并展示了从数据创建到结果输出的完整流程,帮助开发者高效实现复杂的数据处理需求。
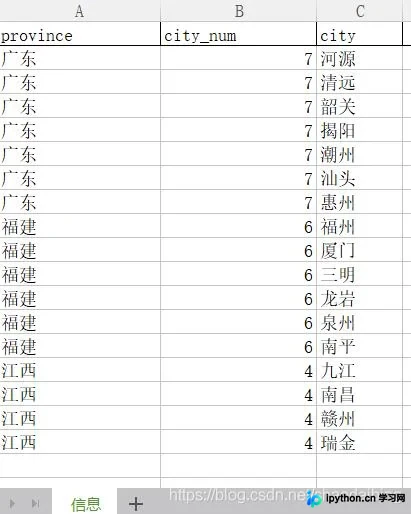
本文介绍如何利用Python自动实现Excel中相同数据区域的单元格合并。通过结合pandas进行数据分组定位,以及openpyxl执行具体的合并操作,解决了手动指定行列范围的繁琐问题。文章提供了完整的代码示例,并封装为基于tkinter的图形界面工具,提升了批量处理Excel文件的效率。
本文详细解析pandas中DataFrame的条件筛选方法。重点介绍使用布尔型DataFrame进行单条件与多条件筛选的正确写法,指出使用and/or运算符导致的ValueError错误及解决方案。深入对比loc、iloc及已弃用的ix方法的索引机制,说明标签索引与位置索引的区别,并演示如何结合逻辑表达式进行行列筛选。

本文详细介绍如何使用Python结合PySimpleGUI和Pandas库开发一款数据预处理小工具。通过构建图形用户界面,实现Excel文件的读取与预览,并自动化处理重复值、缺失值及异常值。文章涵盖界面布局设计、核心代码解析、数据处理逻辑及使用PyInstaller打包成可执行文件的全过程,旨在提供一键完成数据清洗的实用方案。