

pandas按条件筛选数据的实现

本文详细解析pandas中DataFrame的条件筛选方法。重点介绍使用布尔型DataFrame进行单条件与多条件筛选的正确写法,指出使用and/or运算符导致的ValueError错误及解决方案。深入对比loc、iloc及已弃用的ix方法的索引机制,说明标签索引与位置索引的区别,并演示如何结合逻辑表达式进行行列筛选。
在pandas中对DataFrame进行数据筛选的方法多种多样,后续会持续补充更多技巧。此处仅整理在实战中容易遇到的错误情况及对应解决方案。
1.使用布尔型DataFrame对数据进行筛选
使用单个条件对数据进行筛选,代码示例如下:
num_red=flags[flags['red']==1]使用多个条件组合对数据进行筛选,代码示例如下:
stripes_or_bars=flags[(flags['stripes']>=1) | (flags['bars']>=1)]以下是几种常见的错误写法:
错误代码一:
stripes_or_bars=flags[flags['stripes']>=1 or flags['bars']>=1]错误代码二:
stripes_or_bars=flags[flags['stripes']>=1 | flags['bars']>=1].错误代码三:
stripes_or_bars=flags[(flags['stripes']>=1) or (flags['bars']>=1)]上述三种错误代码均会抛出相同的异常:ValueError: The truth value of a Series is ambiguous. Use a.empty, a.bool(), a.item(), a.any() or a.all(). 中括号内的逻辑表达式解析机制尚不明确,但显然不能直接使用and、or及not运算符。
除了组合逻辑表达式外,使用返回布尔型值的函数同样可以实现数据筛选。具体示例如下:
import pandas as pd
import numpy as np
df=pd.DataFrame(np.array(range(10)).reshape((5,-1)))
df.columns=['0','1']
df=df[df['1'].isin([3,5,9])]
其生成的df结果如下:

2.iloc()方法、ix()方法和loc()方法的区别
首先,DataFrame通常包含两种类型的索引:一是位置索引,即系统默认从0开始的整数索引;二是标签索引,即在创建DataFrame时通过index关键字或其他相关方法自定义设置的索引。这两种索引同时存在。通常设置标签索引后,位置索引不再显示,但这并不意味着它不存在。
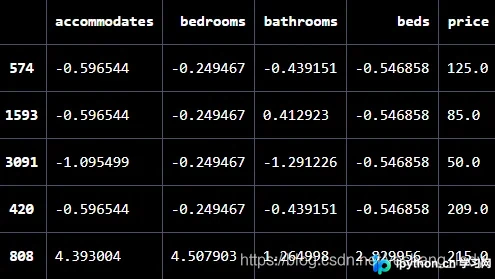
假设存在如下几行数据(截图部分仅为数据子集),显然,以下显示的索引为标签索引。同时,标签索引为574的行对应的位置索引为0,标签索引为1593的行对应的位置索引为2,依此类推。
先来看loc()方法,其API文档地址为http://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.loc.htm,函数名下方有一行解释:Access a group of rows and columns by label(s) or a boolean array.. loc[] is primarily label based, but may also be used with a boolean array.
代码一:
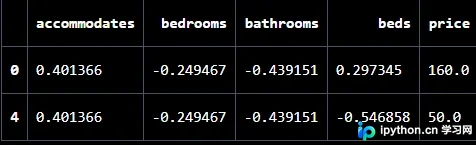
first_listing = normalized_listings.loc[[0,4]]结果如下,可以看出其输出的是DataFrame中标签索引为0和4的两行数据。注意,如果标签索引的类型为字符串,则在loc中也要用字符串的形式。
再来看iloc()方法,其API文档地址为http://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.iloc.html,函数名下方的解释为:Purely integer-location based indexing for selection by position. .iloc[] is primarily integer position based ( from 0 to length-1 of the axis), but may also be used with a boolean array.
代码二:
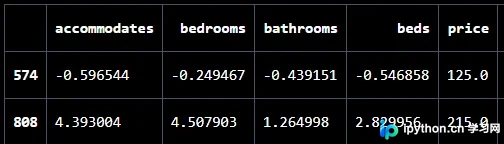
first_listing = normalized_listings.iloc[[0,4]]结果如下,可以看出其输出的是DataFrame中第0行和第4行的数据,即该方法按照位置索引取值。注意,使用位置索引时只能使用整数(integer position,bool类型除外)。
另外,还可以向loc和iloc中传入布尔序列,这样即可将前面介绍的逻辑表达式应用到loc和iloc中。下面来看看如何使用布尔序列?
import pandas as pd
data=pd.DataFrame(data={'col1':[1,2,3,5,10],'col2':[50,90,67,75,100]},\
         index=['a','b','c','d','e'])
print(data)
#iloc[]示例,iloc似乎不能直接使用逻辑表达式的结果,我这里将其转置成list之后就可以用了,原因暂且不明
data_1=data.iloc[list(data['col1']>5)]
print(data_1)
#loc[]示例,loc中可以直接使用逻辑表达式
data_2=data.loc[data['col1']>5]
print(data_2)
在iloc[]中,如果直接使用loc中的逻辑表达式而不进行list()转化的话,会提示ValueError: iLocation based boolean indexing cannot use an indexable as a mask错误。
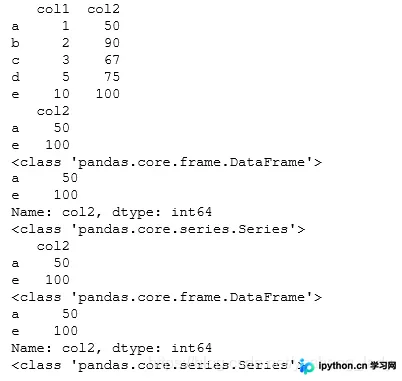
如果查看上述两段代码中得到的first_listing,我们会发现两处first_listing的类型均为DataFrame。loc和iloc除了能对行进行筛选,还可以筛选列。如果在loc和iloc中设定了对列的筛选,则筛选之后得到的数据可能是DataFrame类型,也有可能是Series类型。下面直接以代码运行结果进行说明。
import pandas as pd
data=pd.DataFrame(data={'col1':[1,2,3,5,10],'col2':[50,90,67,75,100]},\
         index=['a','b','c','d','e'])
print(data)
#iloc[]示例 ,在使用iloc的时候,[]里面无论是筛选行还是筛选列,都只能使用数字形式的行号或列号。
#这里如果使用‘col2',这里会报错
data_1=data.iloc[[0,4],[1]]#当需要筛选出多列或者希望返回的结果为DataFrame时,可以将列号用[]括起来。
print(data_1)
print(type(data_1))
data_2=data.iloc[[0,4],1]#当只需要筛选出其中的一列时可以只写一个列号,不加中括号,这种方法得到的是一个Series
print(data_2)
print(type(data_2))
#loc[]示例
data_3=data.loc[['a','e'],['col2']]
print(data_3)
print(type(data_3))
data_4=data.loc[['a','e'],'col2']
print(data_4)
print(type(data_4))
具体的代码执行结果如下:
最后看ix()方法,其API文档地址为http://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.ix.html,其解释为:A primarily label-location based indexer, with integer position fallback.
代码三:
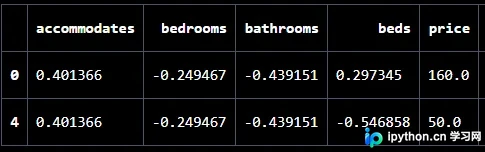
first_listing = normalized_listings.ix[[0,4]]结果如下,似乎与loc()方法的结果相同,但根据其给出的解释来看,它似乎是前两个方法的集合。
到此这篇关于pandas按条件筛选数据的实现的文章就介绍到这了,更多相关pandas 条件筛选 内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









