

Pandas 数据操作速查与多条件模糊查询实战

本文介绍利用 Pandas 和 fuzzywuzzy 进行数据模糊查询与替换的完整流程。涵盖从数据导入、清洗、筛选到多条件文本匹配的核心代码示例,重点解析如何通过列表推导式结合 str.contains() 实现高效的多条件模糊筛选,适用于大量文本数据的快速处理与标准化。
本文主要依赖 Pandas 与 fuzzywuzzy 两个工具库进行数据处理。
Pandas 是建立在 NumPy 基础之上的数据分析工具,专为处理大规模数据集设计,提供了丰富的数据处理函数与方法。
以下是 Pandas 的中文 API 参考文档链接。
缩写定义与包导入说明
本速查手册采用以下缩写规范:
df:代表任意 Pandas DataFrame 对象。
s:代表任意 Pandas Series 对象。
使用前需执行以下导入语句:
import pandas as pd
import numpy as np
数据导入方法
pd.read_csv(filename):从 CSV 文件读取数据。
pd.read_table(filename):从指定分隔符的文本文件读取数据。
pd.read_excel(filename):从 Excel 文件读取数据。
pd.read_sql(query, connection_object):从 SQL 表或数据库读取数据。
pd.read_json(json_string):从 JSON 格式字符串读取数据。
pd.read_html(url):解析 URL、字符串或 HTML 文件,提取其中的表格数据。
pd.read_clipboard():从系统剪贴板获取内容,并传递给 read_table() 处理。
pd.DataFrame(dict):从字典对象创建数据,字典的键作为列名,值作为数据。
数据导出方法
df.to_csv(filename):将数据导出至 CSV 文件。
df.to_excel(filename):将数据导出至 Excel 文件。
df.to_sql(table_name, connection_object):将数据导出至 SQL 表。
df.to_json(filename):以 JSON 格式将数据导出至文本文件。
创建测试对象示例
pd.DataFrame(np.random.rand(20,5)):创建一个包含 20 行 5 列随机数的 DataFrame 对象。
pd.Series(my_list):从可迭代对象 my_list 创建一个 Series 对象。
df.index = pd.date_range('1900/1/30', periods=df.shape[0]):添加日期索引。
查看与检查数据
df.head(n):查看 DataFrame 的前 n 行数据。
df.tail(n):查看 DataFrame 的最后 n 行数据。
df.shape():获取数据的行数和列数。
df.info():查看索引、数据类型及内存使用情况。
df.describe():生成数值型列的汇总统计信息。
s.value_counts(dropna=False):查看 Series 中唯一值及其出现次数。
df.apply(pd.Series.value_counts):查看 DataFrame 中每一列的唯一值及其计数。
数据选取操作
df[col]:根据列名返回该列,结果为 Series 形式。
df[[col1, col2]]:以 DataFrame 形式返回多列数据。
s.iloc[0]:按位置索引选取数据。
s.loc['index_one']:按标签索引选取数据。
df.iloc[0,:]:返回 DataFrame 的第一行。
df.iloc[0,0]:返回第一行第一列的元素。
df.values[:,:-1]:返回除最后一列外的所有数据。
df.query('[1, 2] not in c'):返回 c 列中不包含 1 和 2 的数据集。
数据清理技巧
df.columns = ['a','b','c']:重命名列名。
pd.isnull():检查 DataFrame 中的空值,返回布尔数组。
pd.notnull():检查 DataFrame 中的非空值,返回布尔数组。
df.dropna():删除所有包含空值的行。
df.dropna(axis=1):删除所有包含空值的列。
df.dropna(axis=1,thresh=n):删除非空值数量小于 n 的行。
df.fillna(x):用指定值 x 替换 DataFrame 中的所有空值。
s.astype(float):将 Series 的数据类型转换为 float。
s.replace(1,'one'):将所有等于 1 的值替换为 'one'。
s.replace([1,3],['one','three']):将 1 替换为 'one',3 替换为 'three'。
df.rename(columns=lambda x: x + 1):批量修改列名。
df.rename(columns={'old_name': 'new_ name'}):选择性修改列名。
df.set_index('column_one'):将指定列设置为索引。
df.rename(index=lambda x: x + 1):批量重命名索引标签。
数据处理:过滤、排序与分组
df[df[col] > 0.5]:筛选出 col 列值大于 0.5 的行。
df.sort_values(col1):按列 col1 排序,默认升序。
df.sort_values(col2, ascending=False):按列 col1 降序排序。
df.sort_values([col1,col2], ascending=[True,False]):先按 col1 升序,再按 col2 降序排序。
df.groupby(col):返回按列 col 分组的 GroupBy 对象。
df.groupby([col1,col2]):返回按多列分组的 GroupBy 对象。
df.groupby(col1)[col2]:返回按 col1 分组后 col2 列的均值。
df.pivot_table(index=col1, values=[col2,col3], aggfunc=max):创建数据透视表,按 col1 分组并计算 col2 和 col3 的最大值。
df.groupby(col1).agg(np.mean):返回按 col1 分组的所有列的均值。
data.apply(np.mean):对 DataFrame 每一列应用 np.mean 函数。
data.apply(np.max,axis=1):对 DataFrame 每一行应用 np.max 函数。
数据合并操作
df1.append(df2):将 df2 的行追加到 df1 末尾。
df.concat([df1, df2],axis=1):将 df2 的列追加到 df1 右侧。
df1.join(df2,on=col1,how='inner'):对 df1 和 df2 执行 SQL 风格的 join 操作。
数据统计函数
df.describe():查看数据值列的汇总统计。
df.mean():返回所有列的均值。
df.corr():返回列与列之间的相关系数。
df.count():返回每一列中非空值的个数。
df.max():返回每一列的最大值。
df.min():返回每一列的最小值。
df.median():返回每一列的中位数。
df.std():返回每一列的标准差。
以下是数据处理的相关代码实现。
#!/usr/bin/python
# -*- encoding: utf-8
import numpy as np
import pandas as pd
from fuzzywuzzy import fuzz
from fuzzywuzzy import process

def enum_row(row):
 print(row['state']) #对state这一列做枚举

def find_state_code(row):
 if row['state'] != 0:  # 如果这个state的名字存在,就用state的名字与states列表中的值选择一个最接近的,如果小于80分,直接舍弃,大于80才返回
 print(process.extractOne(row['state'], states, score_cutoff=80))

def capital(str): # 把str这个字符串,第一个字母大写,其余小写
 return str.capitalize()

def correct_state(row):
 if row['state'] != 0: # 如果这个state的名字存在,就用state的名字与states列表中的值选择一个最接近的,如果小于80分,直接舍弃,大于80才返回
 state = process.extractOne(row['state'], states, score_cutoff=80)
 if state: # 如果为真,则找到了一个相关性的州名
  state_name = state[0] # 选择用找到的这个州名数据
  return ' '.join(map(capital, state_name.split(' '))) # 先按空格分开(有的州名中间有空格)单词,然后每个单词首字母大写
 return row['state']

def fill_state_code(row):
 if row['state'] != 0:
 state = process.extractOne(row['state'], states, score_cutoff=80)
 if state:
  state_name = state[0]
  return state_to_code[state_name] # 返回这个州名的value,即缩写
 return ''

if __name__ == "__main__":
 pd.set_option('display.width', 200) # 横向最多显示多少个字符, 一般80不适合横向的屏幕,平时多用200.
 data = pd.read_excel('sales.xlsx', sheetname='sheet1', header=0) # 读取excel表
 print('data.head() = \n', data.head()) # 默认显示前五行
 print('data.tail() = \n', data.tail()) # tail显示后五行
 print('data.dtypes = \n', data.dtypes) # 数据类型
 print('data.columns = \n', data.columns)# 显示第一行行名
 for c in data.columns:
 print(c, end=' ') # 输出第一行行名,中间以空格隔开
 print() #相当于回车
 data['total'] = data['Jan'] + data['Feb'] + data['Mar'] # Jan、Feb、Mar三列的值相加得到一个total
 print(data.head())
 print(data['Jan'].sum()) # Jan这一列的值相加
 print(data['Jan'].min()) # Jan这一列的最小值
 print(data['Jan'].max()) # Jan这一列的最大值
 print(data['Jan'].mean()) # Jan这一列的平均值

 print('=============')
 # 添加一行
 s1 = data[['Jan', 'Feb', 'Mar', 'total']].sum() # s1包含四个值,分别是这四列的和
 print(s1)
 s2 = pd.DataFrame(data=s1)
 print(s2)
 print(s2.T)
 print(s2.T.reindex(columns=data.columns)) # 将s2进行转置输出
 # 即:
 s = pd.DataFrame(data=data[['Jan', 'Feb', 'Mar', 'total']].sum()).T
 s = s.reindex(columns=data.columns, fill_value=0)
 print(s)
 data = data.append(s, ignore_index=True)
 data = data.rename(index={15:'Total'})
 print(data.tail())

 # apply的使用
 print('==============apply的使用==========')
 data.apply(enum_row, axis=1)  # axis=0时对每一列做变换,axis=1时对每一行做变换

 # 事先写好以state为单位的编码字典
 state_to_code = {"VERMONT": "VT", "GEORGIA": "GA", "IOWA": "IA", "Armed Forces Pacific": "AP", "GUAM": "GU",
   "KANSAS": "KS", "FLORIDA": "FL", "AMERICAN SAMOA": "AS", "NORTH CAROLINA": "NC", "HAWAII": "HI",
   "NEW YORK": "NY", "CALIFORNIA": "CA", "ALABAMA": "AL", "IDAHO": "ID",
   "FEDERATED STATES OF MICRONESIA": "FM",
   "Armed Forces Americas": "AA", "DELAWARE": "DE", "ALASKA": "AK", "ILLINOIS": "IL",
   "Armed Forces Africa": "AE", "SOUTH DAKOTA": "SD", "CONNECTICUT": "CT", "MONTANA": "MT",
   "MASSACHUSETTS": "MA",
   "PUERTO RICO": "PR", "Armed Forces Canada": "AE", "NEW HAMPSHIRE": "NH", "MARYLAND": "MD",
   "NEW MEXICO": "NM",
   "MISSISSIPPI": "MS", "TENNESSEE": "TN", "PALAU": "PW", "COLORADO": "CO",
   "Armed Forces Middle East": "AE",
   "NEW JERSEY": "NJ", "UTAH": "UT", "MICHIGAN": "MI", "WEST VIRGINIA": "WV", "WASHINGTON": "WA",
   "MINNESOTA": "MN", "OREGON": "OR", "VIRGINIA": "VA", "VIRGIN ISLANDS": "VI",
   "MARSHALL ISLANDS": "MH",
   "WYOMING": "WY", "OHIO": "OH", "SOUTH CAROLINA": "SC", "INDIANA": "IN", "NEVADA": "NV",
   "LOUISIANA": "LA",
   "NORTHERN MARIANA ISLANDS": "MP", "NEBRASKA": "NE", "ARIZONA": "AZ", "WISCONSIN": "WI",
   "NORTH DAKOTA": "ND",
   "Armed Forces Europe": "AE", "PENNSYLVANIA": "PA", "OKLAHOMA": "OK", "KENTUCKY": "KY",
   "RHODE ISLAND": "RI",
   "DISTRICT OF COLUMBIA": "DC", "ARKANSAS": "AR", "MISSOURI": "MO", "TEXAS": "TX", "MAINE": "ME"}
 states = list(state_to_code.keys()) # 把字典中的key拿出来放到states列表中
 print(fuzz.ratio('Python Package', 'PythonPackage')) #计算Python Package与PythonPackage的相似度
 print(process.extract('Mississippi', states)) # Mississippi与states中哪个最接近,并且列出相似比,不考虑大小写
 print(process.extract('Mississipi', states, limit=1)) # limit=1代表只取最接近的一个
 print(process.extractOne('Mississipi', states)) # extractOne代表只取最接近的一个
 data.apply(find_state_code, axis=1) #apply表示对每一行(axis=1)的数据做find_state_code的变换

 print('Before Correct State:\n', data['state']) # 打印修改之前的state
 data['state'] = data.apply(correct_state, axis=1) # 检测每一行,并对其修改
 print('After Correct State:\n', data['state'])
 data.insert(5, 'State Code', np.nan) # 插入State Code这一列,为这一列州名的缩写
 data['State Code'] = data.apply(fill_state_code, axis=1)
 print(data)

 # group by
 print('==============group by================')
 print(data.groupby('State Code'))
 print('All Columns:\n')
 print(data.groupby('State Code').sum()) # 按州名缩写划分,并将同样州名的数字相加
 print('Short Columns:\n')
 print(data[['State Code', 'Jan', 'Feb', 'Mar', 'total']].groupby('State Code').sum())

 # 写入文件
 data.to_excel('sales_result.xls', sheet_name='Sheet1', index=False)
补充:Pandas 基于多条件文本的模糊查询,涉及 list 与 str.contains() 的使用。
对于文本的模糊查询,可以使用 str.contains() 函数。但当面临几十个甚至上百个查询条件时,逐一查询效率低下。
解决思路如下:
1. 将所有查询条件构建为一个列表。
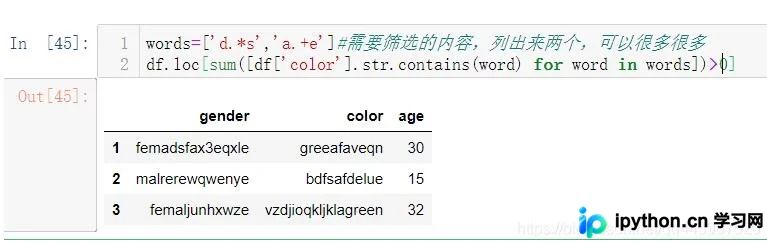
2. 利用列表推导式结合 str.contains() 函数和 sum() 函数进行求和计算。
3. 通过 loc 方法筛选出符合条件的文本内容。
创建步骤演示
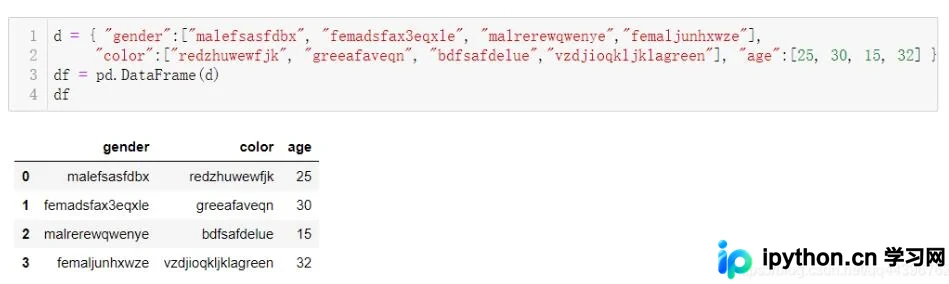
首先创建需要筛选的内容 words 列表,随后执行筛选操作。
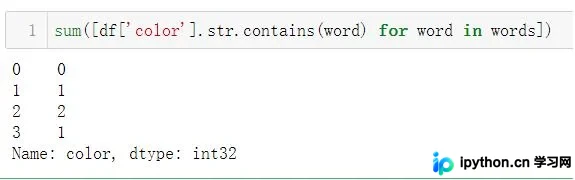
下方展示了 sum 函数内部内容的最终形态,其中 1 和 2 对应 True,0 对应 False。
后续计划编写更简洁的多条件模糊筛选方案。
以上为个人经验分享,旨在提供参考。如有错误或疏漏,欢迎指正。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









