

Python数据预处理:共线性检测与处理实战
本文详解Python中数据共线性的成因、检测方法(如VIF、相关系数)及处理方案。通过岭回归、逐步回归和主成分回归等算法实战,展示如何利用sklearn库解决多重共线性问题,提升模型稳定性与预测精度。
2026-10-13
6

本文详解Python中数据共线性的成因、检测方法(如VIF、相关系数)及处理方案。通过岭回归、逐步回归和主成分回归等算法实战,展示如何利用sklearn库解决多重共线性问题,提升模型稳定性与预测精度。
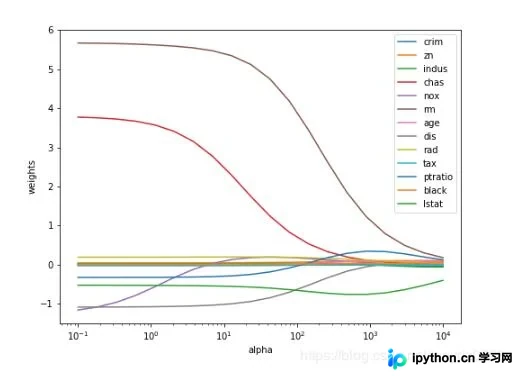
本文详细演示了如何使用Python和SPSS进行多元线性回归分析。通过电厂数据案例,分别采用梯度下降法和sklearn库中的最小二乘法求解回归参数,并对比SPSS结果。文章涵盖数据预处理、损失函数构建、参数迭代优化及模型验证全过程,展示不同方法在参数精度与收敛速度上的一致性。
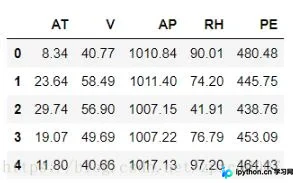
本文通过sklearn演示线性回归案例,分析波士顿房价数据的欠拟合问题。介绍如何使用Pipeline构建多项式特征以优化模型,对比不同degree下的训练与测试得分,揭示过拟合风险。最后深入比较梯度下降与正规方程两种求解方式的适用场景与优缺点,为模型选择提供参考。
本文介绍在 TensorFlow 中通过固定随机数种子来确保神经网络训练结果可复现的方法。针对参数初始化和数据读取中的随机操作,使用 tf.set_random_seed 函数设置统一种子,从而在输入数据相同的情况下获得一致的训练输出。
本文提供使用 TensorFlow 批量生成多个 TFRecord 文件的完整代码示例。通过设定 shard 数量和每个 shard 的数据量,遍历指定目录下的图片资源,调整尺寸并序列化写入多个 TFRecord 文件,适用于大规模图像数据的模型训练准备。
本文详细介绍 TensorFlow 中三种数据读取方式,重点讲解如何使用 TFRecord 格式保存和读取图片数据。通过 Slim 库实现高效的数据序列化与反序列化,涵盖从文件路径获取、参数配置到批量读取的完整流程,适用于大规模图像数据集的训练与验证。
本文介绍Python中逻辑回归分类器的实现方法。逻辑回归通过最大似然概率构建方程,利用牛顿梯度上升求解参数。其优势在于计算成本低且易于理解,但可能面临欠拟合风险。文章提供了适用于多维数据集的完整代码模板,涵盖Sigmoid定义、参数迭代及预测函数,适合初学者快速上手。
本文详细介绍如何将现有的 TensorFlow .pb 分类模型转换为适用于移动端的 .lite 格式。通过编译 TensorFlow 源码获取 TOCO 工具,并使用命令行参数指定输入输出节点、形状及数据类型完成转换。文章还提供了查找未知节点的方法,并对比了转换前后模型在 Android 设备上的大小与推理速度,展示 Lite 格式的加速效果。
本文针对 TensorFlow 中 Variable 变量直接赋值失败的问题进行解析。通过对比错误代码与修正后的代码,展示了正确的赋值方式。文章指出直接赋值无法更新变量值,并提供了避免使用占位符的简洁解决方案,帮助开发者高效完成变量状态更新。
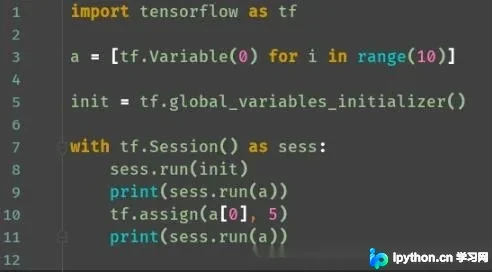
本文详细解析TensorFlow中卷积操作的梯度反向传播机制,涵盖Valid和Same两种填充模式。通过具体示例展示如何对未知输入张量和未知卷积核分别求导,并介绍tf.nn.conv2d_backprop_input与tf.nn.conv2d_backprop_filter函数的使用方法及代码实现,帮助开发者深入理解卷积层训练过程中的梯度计算逻辑。
本文分析了在使用Keras(后端为TensorFlow)进行实验时,因版本不匹配导致服务器端实验结果异常的问题。通过对比不同环境下的版本组合,发现将服务器端的Keras降级至2.0.8并与TensorFlow 1.4.0配合使用可恢复正常运行。文章提供了版本兼容性参考链接,并强调了CUDA、cuDNN及库版本匹配的重要性。
本文详细介绍TensorFlow 2.0中矩阵与向量的基本运算方法。涵盖矩阵加法、乘法、减法及标量除法的具体实现,重点解析矩阵乘法中数据类型一致性要求及axes参数配置,提供完整代码示例与注意事项,帮助开发者快速掌握基础张量操作。