

解决Tensorflow训练速度随步数增加而变慢的问题
本文分析Tensorflow训练过程中因重复加载图结构导致速度变慢的原因,并提供两种解决方案:将模型结构载入全局或置于会话外部。通过对比测试数据,展示优化后训练时间的均衡性,帮助开发者避免图爆炸问题,提升训练效率。
2026-10-13
6

本文分析Tensorflow训练过程中因重复加载图结构导致速度变慢的原因,并提供两种解决方案:将模型结构载入全局或置于会话外部。通过对比测试数据,展示优化后训练时间的均衡性,帮助开发者避免图爆炸问题,提升训练效率。
本文针对TensorFlow在使用GPU训练时出现CPU占用率过高且无法调用显卡的问题,分析其原因为TensorFlow GPU版本与服务器CUDA及CuDNN版本不匹配。通过检查当前CUDA和CuDNN版本,并在官网下载对应版本的TensorFlow-GPU进行重新安装,从而解决该兼容性问题,确保模型训练能正常利用GPU加速。
本文介绍在 TensorFlow 中如何仅初始化未初始化的变量。通过 tf.global_variables() 获取全局变量列表,利用 tf.is_variable_initialized 判断状态,筛选出未初始化变量,最后使用 tf.variables_initializer 进行批量初始化。
本文详解TensorFlow中tf.Variable的创建、类型形状固定机制及值修改方法。介绍global_variables_initializer全局初始化与initialized_value依赖初始化的使用场景,结合代码示例说明如何在Session中正确启动Graph并完成变量赋值操作。
本文介绍如何在TensorFlow中通过自定义损失函数来优化商品销量预测模型。传统均方误差可能忽略成本与利润差异,本文通过设定不同预测偏差的惩罚系数,使模型更贴合实际商业利益。结合具体代码示例,展示如何利用tf.greater和tf.where构建非对称损失函数,并验证其对预测结果的影响。
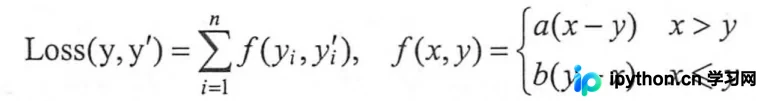
本文介绍TensorFlow中tf.train.exponential_decay函数的用法。该函数通过设置初始学习率、衰减系数和衰减步数,实现学习率的指数级下降。文章详细解析了staircase参数对连续衰减与阶梯状衰减的影响,并展示了global_step作为变量自动更新和作为占位符手动feed的两种典型应用形态,帮助开发者优化模型训练过程。
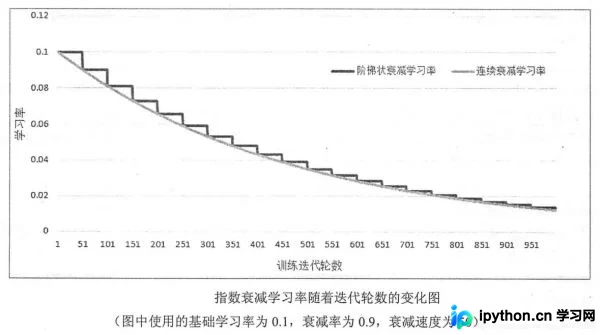
本文深入解析TensorFlow中两种常用的梯度下降优化技术:指数衰减学习率与滑动平均参数更新。通过tf.train.exponential_decay函数实现学习率的动态调整,结合tf.train.ExponentialMovingAverage保持模型稳定性,帮助开发者提升模型收敛速度与泛化能力。
本文通过TensorFlow代码实例,演示如何使用tf.gradients函数计算梯度。以矩阵乘法为例,解析变量w1对结果res的导数计算过程,并展示梯度裁剪的实现方式,帮助开发者理解梯度反向传播的基本原理。
本文介绍TensorFlow中两种自定义反向传播梯度的方法。第一种通过tf.RegisterGradient注册新梯度并使用gradient_override_map覆盖原操作,适用于不可导节点如符号函数的平滑近似。第二种利用tf.stop_gradient阻断前向梯度传播,实现前向与反向函数的解耦,常用于梯度反转场景。文章提供具体代码示例及注意事项,帮助开发者灵活控制梯度流。

本文介绍在TensorFlow中通过tf.gradients()函数查看梯度的方法。针对模型训练时Loss不收敛的情况,分析梯度消失(趋近0)和梯度爆炸(数值过大)的原因,并给出调整权重初始化或使用ResNet等结构的建议。
本文详细介绍如何使用TensorFlow构建简单的多层神经网络来解决XOR(异或)线性不可分问题。通过定义输入输出、权重初始化、ReLU激活函数及Adam优化器,逐步演示模型训练过程。文章包含完整Python代码示例,并分析学习率与迭代次数对损失函数的影响,帮助初学者理解神经网络的基本原理与调参技巧。

在使用 Python 和 TensorFlow 进行 GPU 模型训练时,默认配置会占用全部显存,可能导致多进程任务崩溃。本文介绍两种限制显存的方法:一是按比例预留固定显存(如 50%),二是开启自适应增长模式。通过配置 ConfigProto 对象,可有效避免显存溢出,提升多进程管理的稳定性与资源利用率。