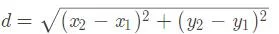TensorFlow 指定 GPU 与动态分配显存设置
本文介绍如何在 TensorFlow 中指定使用的 GPU 并动态分配显存。通过命令行设置 CUDA_VISIBLE_DEVICES 环境变量可限制可见 GPU,使用 nvidia-smi 查看状态。在 Python 代码中,通过修改 os.environ 和配置 tf.ConfigProto 的 allow_growth 属性,实现按需分配显存,避免内存溢出。
2026-10-13
6

本文介绍如何在 TensorFlow 中指定使用的 GPU 并动态分配显存。通过命令行设置 CUDA_VISIBLE_DEVICES 环境变量可限制可见 GPU,使用 nvidia-smi 查看状态。在 Python 代码中,通过修改 os.environ 和配置 tf.ConfigProto 的 allow_growth 属性,实现按需分配显存,避免内存溢出。
本文通过TensorFlow代码示例,深入解析梯度下降法中var_list参数的作用。默认情况下,优化器会同时更新权重矩阵W([784,10])和偏置b。实验对比显示,若仅更新权重W,模型准确率约为0.9187,影响有限;而若仅更新偏置b,准确率骤降至0.1135,效果显著变差。这证明了在Softmax回归中,合理分配W和b的更新策略对模型性能至关重要。
本文介绍在TensorFlow中实现部分模型参数梯度更新的两种方法。第一种通过变量作用域筛选需优化的变量,第二种利用tf.stop_gradient()函数冻结特定层。结合矩阵部分行或列更新的示例,详细解析如何在迁移学习和Embedding场景中保持预训练参数不变并微调特定层。
本文介绍如何使用TensorFlow查看CKPT文件中各节点变量的名称。通过Python脚本读取模型文件,获取变量到形状映射,并打印出所有节点名称。
本文深入解析TensorFlow中张量的提取与赋值操作。详细讲解tf.gather和tf.gather_nd从指定位置收集数值的方法,以及tf.scatter_nd和tf.scatter_nd_update将更新值写入张量的机制。通过函数原型、参数说明及代码示例,阐明索引维度与输出形状的关系,帮助开发者掌握高效处理张量数据的核心技巧。
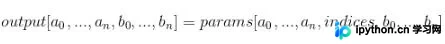
本文介绍使用Python实现人脸识别验证的完整流程。通过结合face_recognition库进行特征提取,利用TensorFlow构建神经网络模型进行训练,并将数据持久化至MongoDB。代码示例展示了从注册、特征比对到最终验证的逻辑,并指出当前方案在部分遮挡场景下可能存在识别率波动的问题,供开发者参考优化。
本文详细介绍TensorFlow中tf.summary系列函数的用法,涵盖scalar、histogram、image等常用接口。通过示例解析如何记录训练指标、保存日志及利用TensorBoard进行可视化分析,帮助开发者高效监控模型训练过程。
在 TensorFlow 中使用自定义 Loss 或优化器时,直接初始化部分变量可能导致优化器内部生成的新变量未被包含在初始化列表中,从而引发报错。本文介绍通过集合运算筛选出新增变量的方法,确保自定义优化器相关变量被正确初始化,解决部分变量初始化时的兼容性问题。
本文介绍如何利用 TensorFlow 的 pywrap_tensorflow 模块读取保存的 CKPT 模型文件。通过 NewCheckpointReader 获取变量形状映射,并遍历打印变量名称及具体张量值,适用于模型训练后的调试与验证场景。
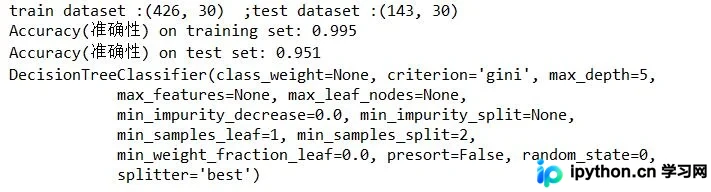
本文基于Python与sklearn库,使用乳腺癌数据集演示决策树模型的实现。重点探讨criterion(信息熵与基尼不纯度)及max_depth参数对模型性能的影响。通过可视化训练集与测试集得分,深入分析决策树深度增加导致的过拟合现象,并提供初步的参数调整结论。
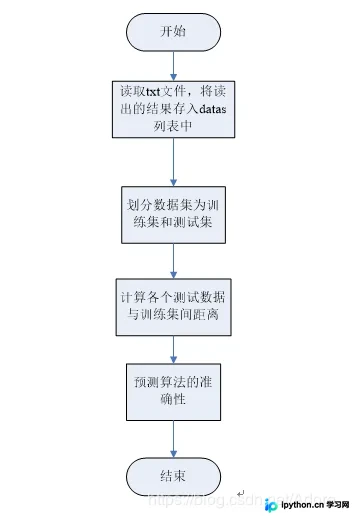
本文详细讲解如何使用原生Python代码实现K近邻(KNN)分类算法。通过处理鸢尾花(Iris)数据集,演示了数据读取、7:3训练测试集划分、距离计算及预测准确性的完整流程。文章包含算法原理、代码实现细节及可视化分析,适合机器学习初学者参考。
本文详细介绍如何使用Python的sklearn库实现KNN(K-Nearest Neighbors)分类算法。内容涵盖算法原理、核心步骤、距离计算方式及参数设置,并通过鸢尾花数据集的代码示例演示训练与预测过程,帮助读者快速掌握该基础分类模型的应用。