基于Numpy的RNN前向传播原理实现
本文通过纯Numpy库从零实现循环神经网络(RNN)的前向传播过程,旨在帮助开发者深入理解RNN内部数据流动与状态更新机制。代码未包含梯度下降与反向传播,仅聚焦于前向计算逻辑,适用于学习RNN基础原理及手动推导网络结构,不支持GPU加速。
2026-10-14
6

本文通过纯Numpy库从零实现循环神经网络(RNN)的前向传播过程,旨在帮助开发者深入理解RNN内部数据流动与状态更新机制。代码未包含梯度下降与反向传播,仅聚焦于前向计算逻辑,适用于学习RNN基础原理及手动推导网络结构,不支持GPU加速。
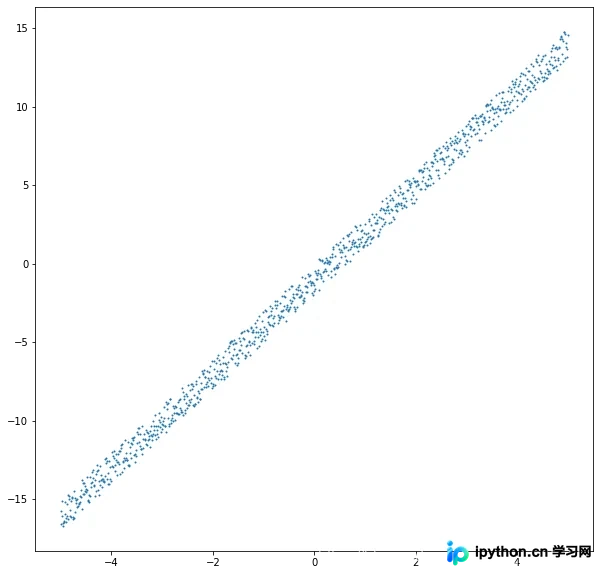
本文详细讲解如何利用Python实现最小二乘法和梯度下降算法。通过生成模拟数据,分别使用sympy求解偏导方程组和迭代优化方法计算参数a和b。对比两种方法的计算过程与结果,展示其在线性回归中的应用及代码实现细节。
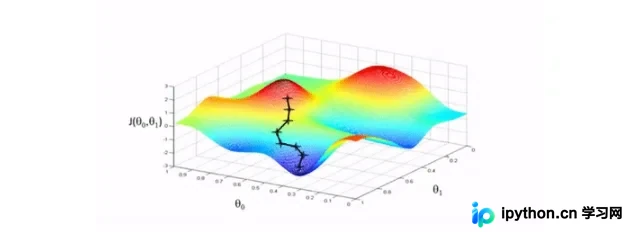
本文深入解析神经网络中的反向传播算法,阐述其通过计算成本函数对权重和偏置的偏导数来优化模型的核心原理。结合Python代码示例,详细演示Sigmoid与ReLU激活函数的导数计算,并提供完整的BP算法实现案例,帮助开发者掌握深度学习的基础训练机制。
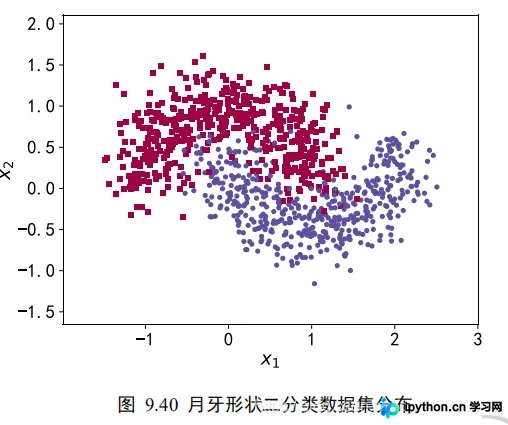
本文通过TensorFlow实战演示如何识别并解决过拟合问题。实验对比了不同网络层数、Dropout层数量及L2正则化系数对模型决策边界的影响。通过月牙数据集可视化,直观展示增加网络容量易导致过拟合,而合理引入Dropout和L2正则化能有效平滑决策边界,提升模型泛化能力。
本文详细解析使用Python实现决策树算法的全过程,重点介绍基于ID3算法在MNIST手写数字数据集上的应用。内容涵盖数据加载、二值化处理、树构建逻辑及准确率评估,展示了未剪枝ID3模型在60000条训练数据下的85.9%正确率及356秒运行耗时,为理解决策树原理与代码实现提供完整参考。
本文详细解析如何使用Python实现感知机模型。通过自定义PerceptronToby类展示权重更新逻辑,并结合Sklearn库进行对比测试。文章涵盖数据预处理、模型训练及准确率评估,适合希望深入理解感知机原理及实际应用的开发者参考。
本文详细介绍如何利用TensorFlow的tf.data API从多个CSV文件构建高效的数据集。通过list_files、interleave并行读取、skip跳过表头以及map解析字段等步骤,实现从原始文件到可训练张量的转换。文章包含完整代码示例及batch_size、steps_per_epoch等关键参数的配置说明,适用于机器学习模型训练前的数据预处理环节。
本文系统梳理Python深度学习中的四种核心激活函数:Sigmoid、Tanh、ReLU和SoftMax。通过数学公式、Python代码实现及函数图像,详细解析各函数的值域、梯度特性及适用场景,重点对比Sigmoid与Tanh的梯度消失问题,以及ReLU在收敛速度上的优势,并探讨SoftMax在多分类概率转化中的应用与数值稳定性处理。
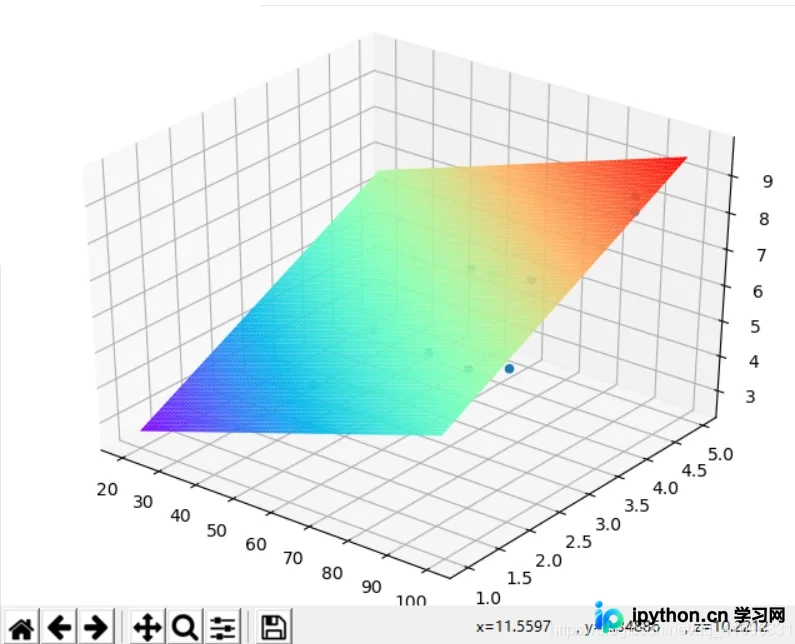
本文详细介绍如何使用Python实现梯度下降算法。通过SymPy库进行符号变量定义与偏导数自动求解,结合Matplotlib绘制3D散点图与拟合平面,直观验证算法结果。文章涵盖Python版本选择、数据集构建及核心代码实现,适合机器学习初学者参考。
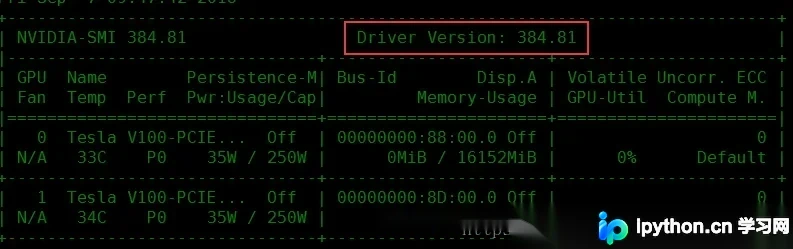
本文详解TensorFlow不同版本对Python、编译器及CUDA/cuDNN的具体要求,提供Windows与Linux端的官方配置参考。重点解析“CUDA driver version is insufficient”报错原因,通过nvidia-smi与pip list命令核对驱动与运行时版本,并给出降级cudatoolkit以匹配GPU驱动的完整解决步骤。
本文介绍如何在Python中使用pandas处理数据,并结合sklearn库进行数据集划分。详细讲解train_test_split函数的随机划分方法及KFold交叉验证的原理与参数设置,包括shuffle和random_state的影响,帮助开发者优化模型训练流程。
本文详细解析Python中print函数的刷新机制,通过\r和end参数实现单行结果动态更新,解决位数变化导致的显示错乱问题。同时介绍tqdm库的安装与基础用法,展示如何在列表遍历和字符串处理中添加可视化进度条,适用于机器学习训练过程中的Loss和Accuracy实时监控场景。