

Python读取HDFS Parquet文件及小文件合并指南
本文介绍Python读取HDFS上Parquet格式数据的多种方案,包括hdfs3、hdfs和pyhdfs库的使用及HA配置。同时提供PySpark中利用coalesce函数合并小文件、优化存储效率的实用代码示例。
2026-10-14
6

本文介绍Python读取HDFS上Parquet格式数据的多种方案,包括hdfs3、hdfs和pyhdfs库的使用及HA配置。同时提供PySpark中利用coalesce函数合并小文件、优化存储效率的实用代码示例。
本文详细演示了如何使用Python和SPSS进行多元线性回归分析。通过电厂数据案例,分别采用梯度下降法和sklearn库中的最小二乘法求解回归参数,并对比SPSS结果。文章涵盖数据预处理、损失函数构建、参数迭代优化及模型验证全过程,展示不同方法在参数精度与收敛速度上的一致性。
本文详细介绍如何使用Python的Seaborn库绘制热力图。涵盖基础热图生成、颜色映射调整、坐标轴标签设置、数值注释添加以及网格线配置。此外,还深入讲解了聚类热图(Clustermap)的实现方法,包括自定义颜色、保存高分辨率图片等高级技巧,帮助开发者高效完成多维数据可视化任务。
本文全面介绍 NumPy 数组的核心操作方法,涵盖从基础安装到高级应用的完整流程。详细讲解如何使用 append、insert 和 delete 方法动态增删元素,利用 sort 进行排序及归一化数据处理。同时演示数组切片、索引访问、类型转换及 CSV 导出技巧,帮助开发者高效掌握 NumPy 在科学计算与机器学习中的基础应用。
本文详细解析 k-means 聚类算法的核心思想,涵盖从随机初始化聚类中心到迭代更新均值的完整流程。通过 Python 代码展示如何利用 numpy 和 matplotlib 实现聚类过程及结果可视化,帮助开发者理解算法逻辑并快速上手应用。
本文详细介绍 Jupyter Notebook 的安装、启动及核心操作。涵盖 Anaconda 与 pip 安装方法,解析 Notebook 架构与内核机制,演示代码与 Markdown 单元格使用,并深入讲解 Magic 命令及常用快捷键,帮助数据爱好者高效进行数据挖掘与建模。
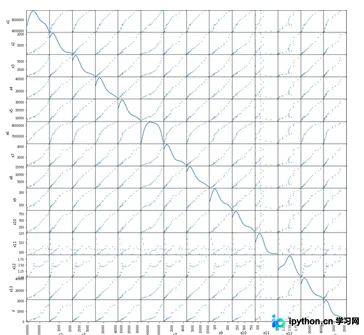
本文详细介绍pandas中scatter_matrix函数的用法,涵盖frame、alpha、figsize、diagonal等关键参数。通过sklearn的iris样本进行实战演示,展示如何配置颜色、标记及直方图选项,生成特征间关系的矩阵散点图,帮助开发者快速掌握多维数据的可视化技巧。
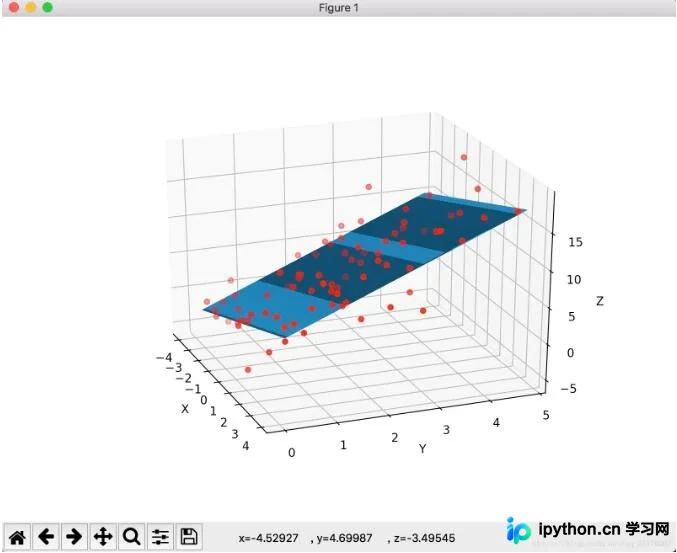
本文介绍如何利用Python3的Axes3D库绘制三维线性回归模型。通过生成两个不相关的特征数据,使用最小二乘法求解参数,并绘制网格曲面与散点图,直观展示机器学习算法的建模过程。
本文提供使用Python实现梯度下降算法和逻辑回归的完整代码。通过Iris数据集演示数据预处理、Sigmoid函数定义及随机梯度下降优化过程,并展示模型预测与结果保存方法,供开发者参考学习。
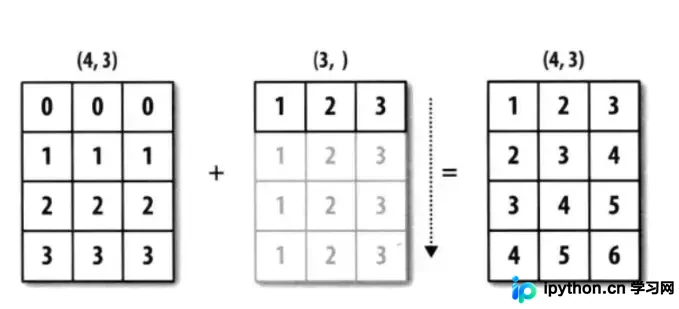
本文深入解析 NumPy 与 TensorFlow 中的 Broadcasting 广播机制。通过标量、二维及三维数组的具体案例,详细阐述后缘维度匹配规则、形状扩展逻辑及常见报错处理,帮助开发者高效进行张量运算。
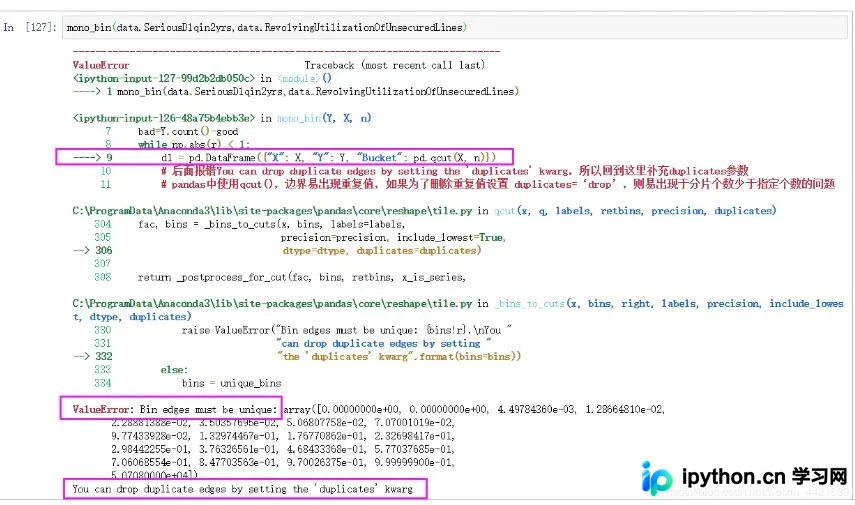
本文详细解析pandas.cut与pandas.qcut两个函数的参数与区别,涵盖等宽与等深分箱原理。针对信用风控建模中常见的qcut边界重复报错,提供设置duplicates='drop'的解决方案,并展示变量离散化及WOE计算的实际代码示例。
本文详细介绍Python中NumPy库的基础操作,涵盖数组与矩阵的创建方法、元素级与矩阵级运算规则、常用统计函数以及高效的索引与切片技巧。适合机器学习初学者掌握数据处理核心技能,通过具体代码示例解析广播机制、累加累乘及多维数组访问方式。