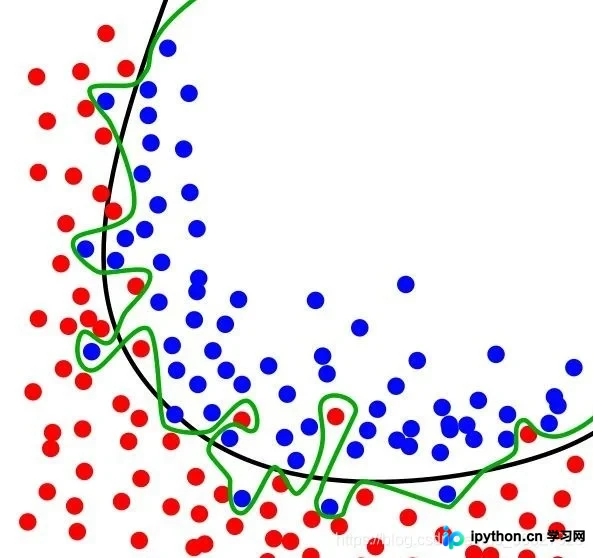
Python使用dabl几行代码实现数据处理分析及ML自动化
dabl是Python开源数据分析基线库,通过几行代码自动完成数据预处理、特征可视化及基线模型训练。本文介绍其核心功能,包括自动识别数据类型、执行探索性数据分析(EDA)及返回最佳预测模型,旨在简化机器学习开发流程。
2026-10-15
6

dabl是Python开源数据分析基线库,通过几行代码自动完成数据预处理、特征可视化及基线模型训练。本文介绍其核心功能,包括自动识别数据类型、执行探索性数据分析(EDA)及返回最佳预测模型,旨在简化机器学习开发流程。
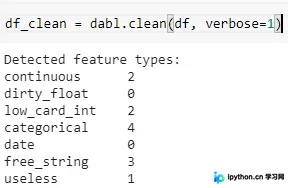
本文总结了pandas初学者在处理大规模数据集时常见的六个错误,包括使用read_csv读取大文件、未利用矢量化操作、未优化数据类型、忽略DataFrame样式设置、保存为CSV格式以及不阅读文档。通过对比实验,展示了使用datatable、NumPy矢量化、类型压缩及Parquet/Feather格式带来的显著性能提升,帮助开发者避免常见陷阱,提高数据处理效率。
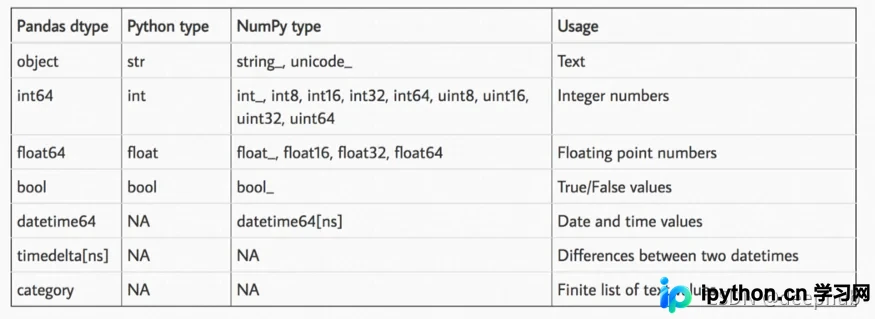
本文深入解析TensorFlow的自动求导(Automatic Differentiation)原理,阐述其如何结合符号与数值求导优势。重点介绍tf.GradientTape()在即时执行模式下的应用,通过y=x^2实例演示梯度计算流程,并解析math_grad.py中RegisterGradient装饰器的作用,帮助开发者理解模型训练中的梯度反向传播机制。
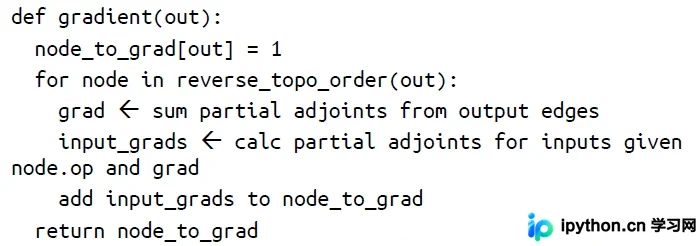
学习Python对电脑配置要求因方向而异。基础语法和Web开发普通办公电脑即可;大数据开发需大内存(至少8G)以支持虚拟机集群;AI与深度学习需高性能GPU(如1080Ti或更高)及强劲CPU。建议根据学习阶段选择合适硬件,并预留升级空间。
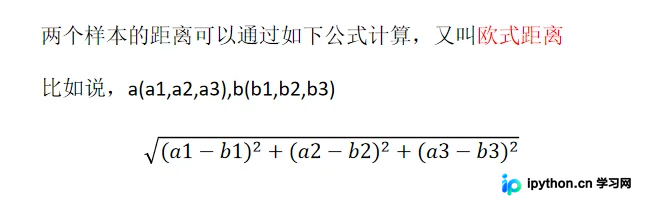
本文详解Python中K近邻算法(KNN)的核心原理、优缺点及API调用方法。通过预测酒店入住位置的完整案例,演示从数据清洗、时间特征工程、标准化到模型训练与评估的全流程,帮助开发者掌握KNN在小规模数据集上的实际应用。
本文深入解析Python机器学习中的随机梯度下降法(SGD)。对比全批量梯度下降法,阐述SGD在计算效率与稳定性上的权衡。通过美国问答社区数据预测案例,展示使用NumPy和Pandas实现SGD的完整代码流程,包括数据预处理、参数初始化及模型评估,帮助开发者掌握优化算法的实际应用。
本文介绍在Python中使用Pandas库对两个表格进行内容模糊匹配的方法。方法一通过全连接后筛选,逻辑简单但内存消耗大;方法二利用字典遍历,适合大数据集。文章提供了具体的代码实现、步骤解析及结果展示,帮助开发者高效处理文本匹配任务。
本文介绍如何利用OpenCV的ml模块中的KNearest算法实现标准数字识别。通过图像预处理、自适应阈值化及轮廓提取构建训练集,保存特征数据后加载模型进行预测。文中提供完整的Python代码示例,涵盖从数据生成到识别输出的全过程,适合OpenCV初学者参考学习。
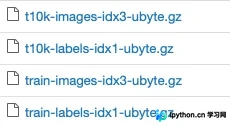
本文详解使用Python从本地读取MNIST手写数字数据集的方法。涵盖.gz压缩格式与解压缩后.ubyte格式的两种读取策略,解析文件头Magic Number与样本数量结构,提供训练集与测试集的完整加载代码及验证步骤,适用于机器学习入门与模型训练准备。
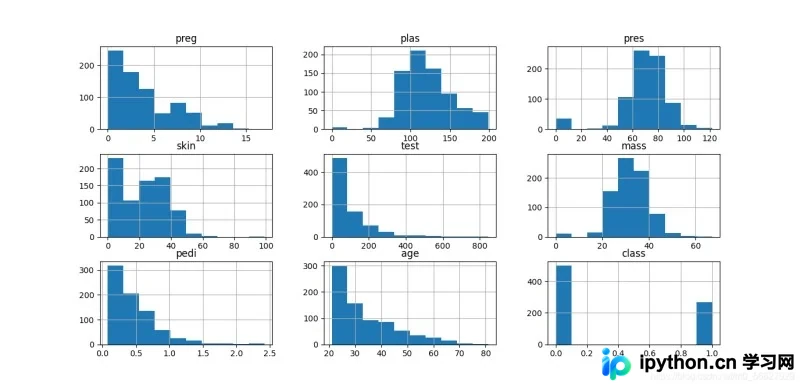
本文详解Python机器学习中的数据理解环节,涵盖使用Python标准库、Numpy及Pandas导入CSV数据的方法,重点推荐Pandas。通过查看前10行、维度、类型及描述性统计深入理解数据,并利用相关矩阵和高斯分布分析特征关系,最后借助Matplotlib进行直方图、密度图等可视化操作,为模型构建奠定基础。
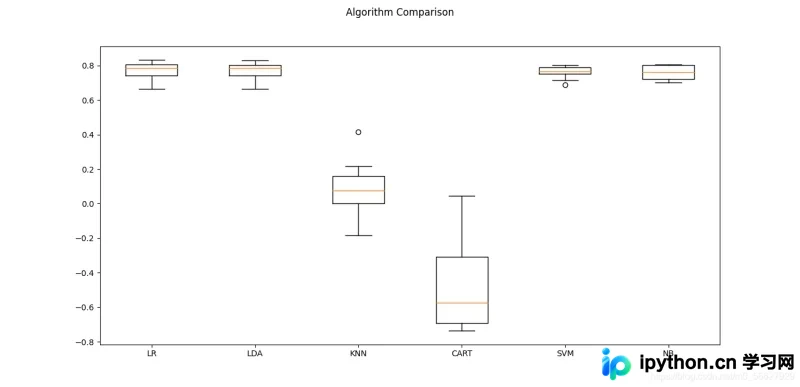
本文详细介绍在Python机器学习项目中如何进行算法审查。通过逻辑回归、LDA、KNN、SVM等分类算法,以及线性、岭、套索、弹性网络等回归算法的对比实验,展示如何利用scikit-learn进行10折交叉验证。文章提供了完整的代码模板和评估结果,帮助开发者科学选择最优算法。
本文深入解析Python机器学习中的模型评估与数据集分离技术。详细对比了训练集/测试集简单划分、K折交叉验证、弃一交叉验证及重复随机分离四种方法,并探讨了分类准确度、分类报告、平均绝对误差、均方误差及判定系数等核心评估指标,帮助开发者选择最优模型验证策略。