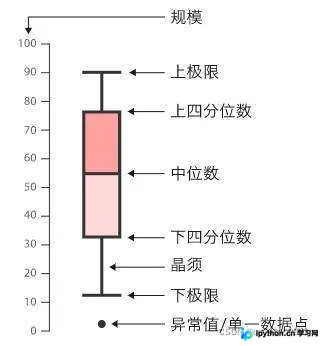
使用Seaborn进行NBA球员数据可视化与相关性分析
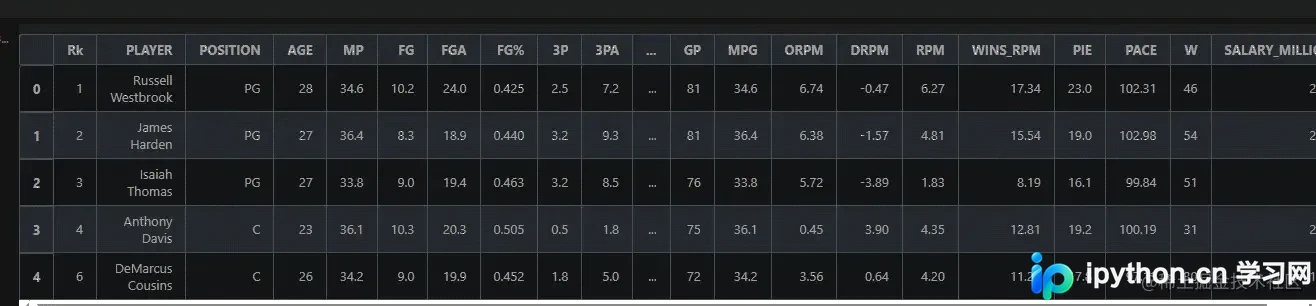
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
2026-10-16
4

本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
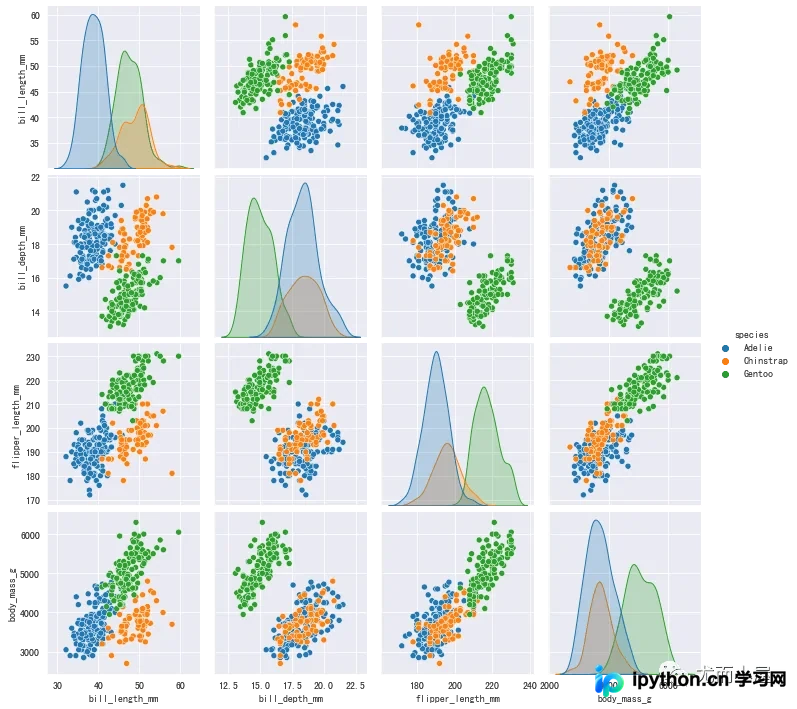
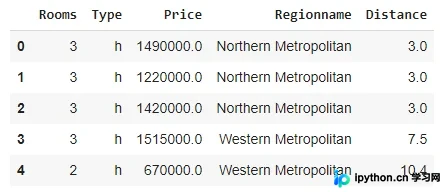
本文详细解析Seaborn库中pairplot函数的核心参数与用法。通过导入默认数据集,演示了kind、hue、diag_kind、palette等关键参数的配置方法,涵盖散点、KDE、直方图及回归等多种图形类型。文章提供了关于颜色控制、标记样式、尺寸调整、变量筛选及缺失值处理的完整代码示例,帮助用户快速掌握绘制高质量双变量关系图的技术。
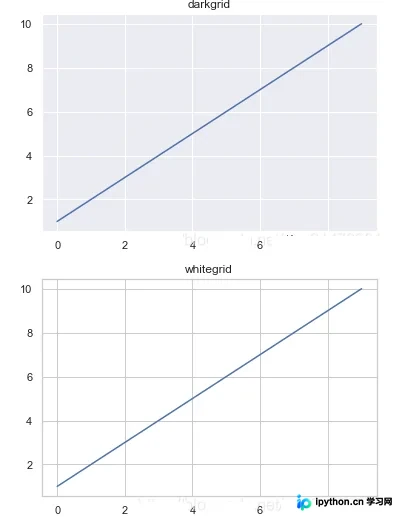
本文详细介绍Python中seaborn库的图形外观设置方法。涵盖使用set_style配置五种背景风格,通过axes_style结合with语句为不同子图应用独立样式,以及利用despine函数控制外框显示。此外,还讲解了plotting_context与set_context对图形缩放的四种模式调整,最后演示如何同时配置背景、缩放及调色板。
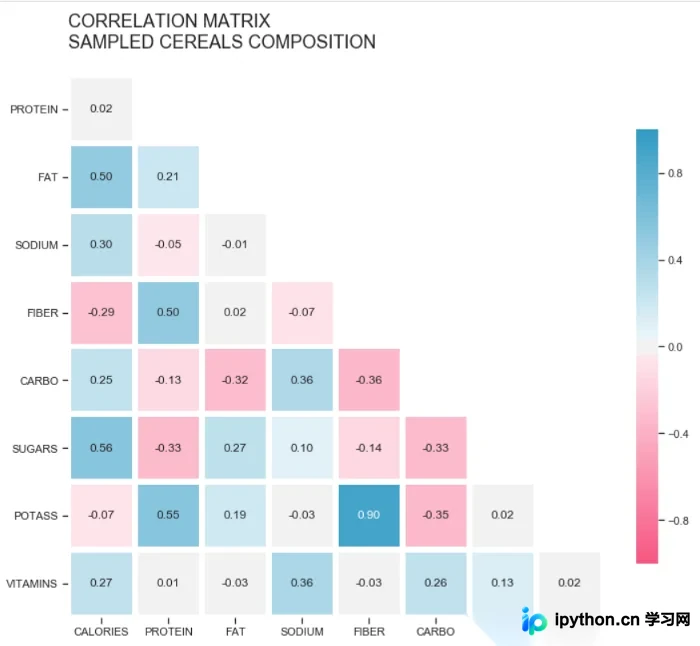
本文详细介绍如何使用Python的Seaborn库绘制高质量热力图。内容涵盖从导入Pandas和Numpy进行数据预处理开始,通过corr()计算相关性矩阵,利用Mask矩阵去除冗余上三角区域,以及调整参数显示具体数值。此外,还深入讲解了如何使用diverging_palette优化发散型调色板,提升视觉表现力,最终生成带有标题和格式优化的专业级相关性热力图。
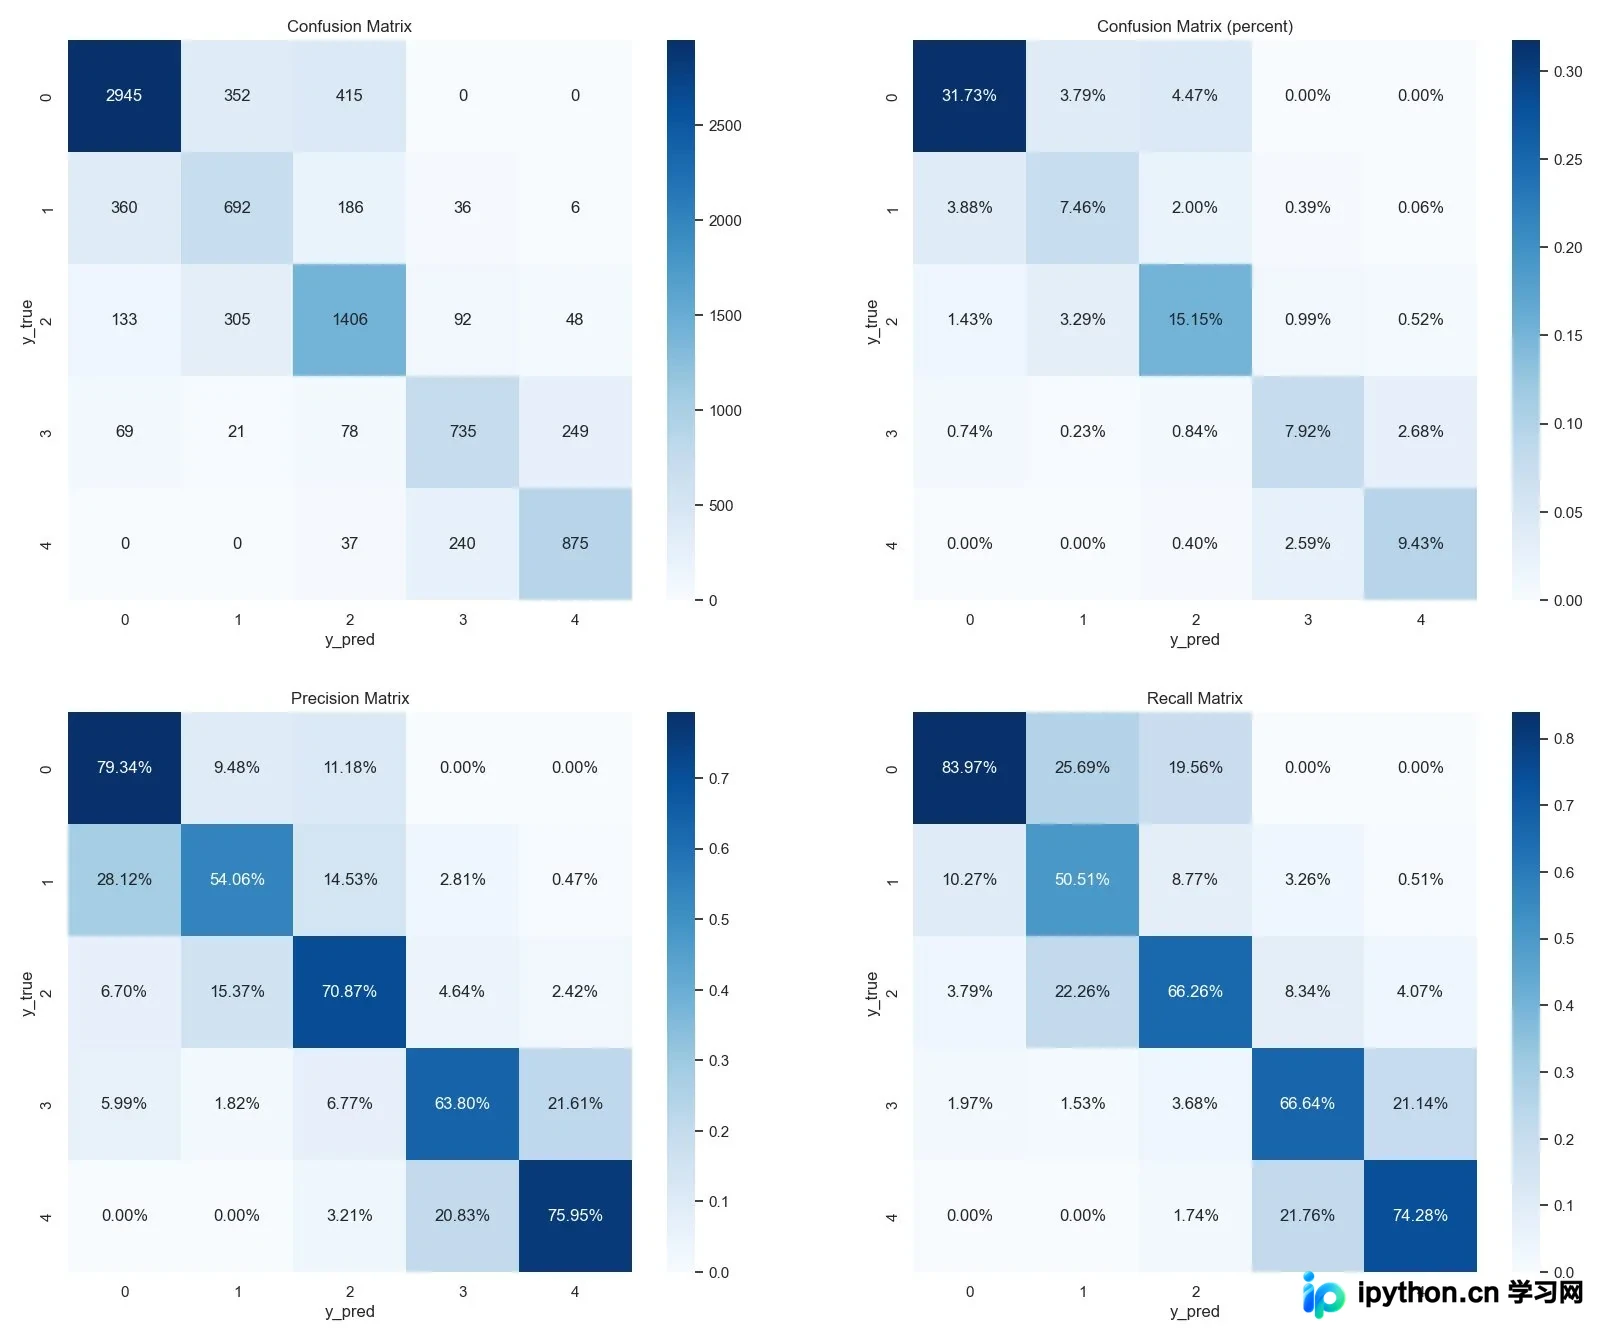
本文介绍如何利用Python的Seaborn库绘制多分类任务下的混淆矩阵及其衍生指标图。通过计算准确率、精准率、召回率和F1分数,生成原始计数、百分比、召回率、精准率及F1矩阵的可视化图表,帮助开发者直观评估模型在多标签场景下的表现。
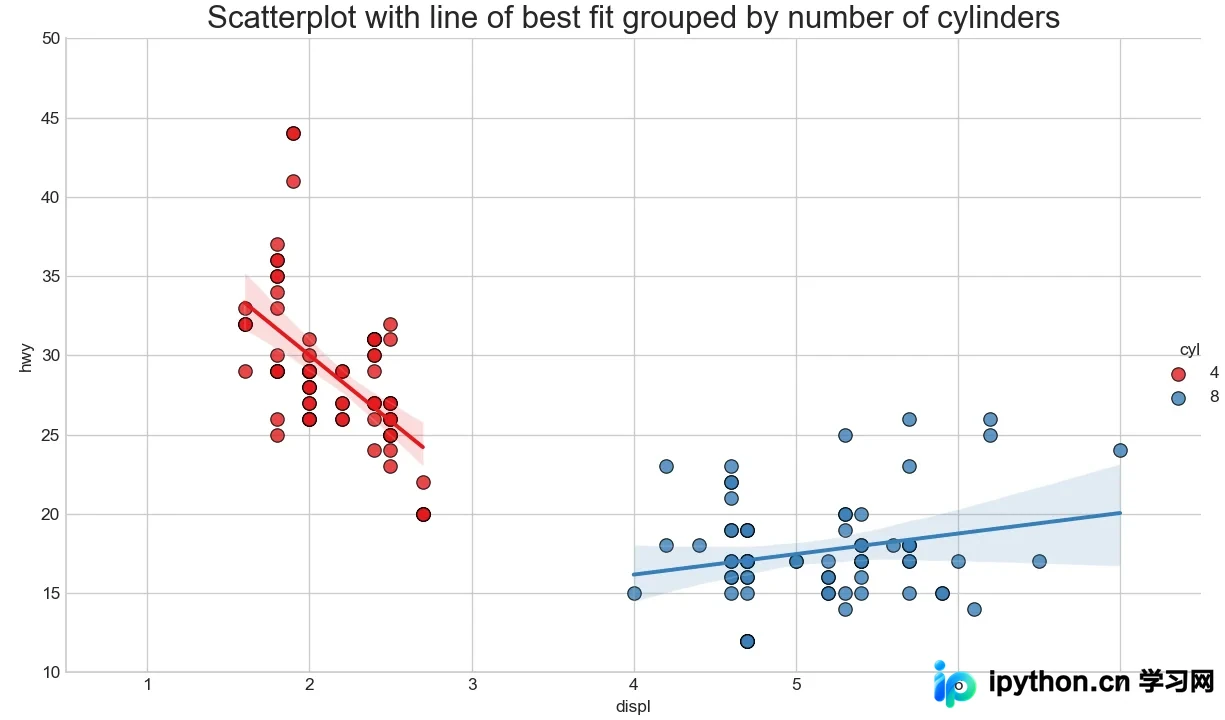
本文介绍如何使用Python的Seaborn库进行数据可视化。通过lmplot函数在散点图中添加线性拟合趋势线,直观展示变量间的相关性;利用GridSpec布局绘制边缘直方图,同时呈现双变量关系及单变量分布。代码示例基于mpg数据集,涵盖环境配置、数据筛选及图表美化,适用于数据探索性分析。
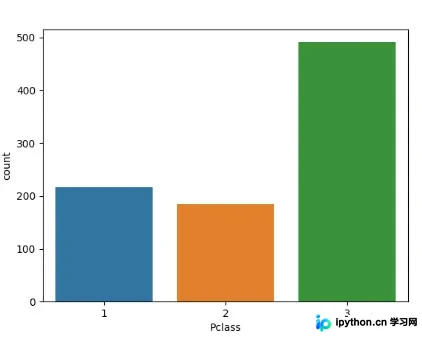
本文详细介绍Python中Seaborn库的countplot函数,用于绘制类别特征的频数统计条形图。文章解析了x、y、hue、data、order、palette等核心参数的用法,并通过Titanic数据集演示了如何绘制基础条形图、分组条形图、自定义排序与配色,以及如何在子图中组合展示。
本文通过10个具体示例,详细讲解如何使用Python的Seaborn库绘制分布图。内容涵盖直方图、核密度估计(KDE)图和经验累积分布函数(Ecdf)图的创建与参数调整,包括处理异常值、分类变量分组及二维分布等场景,帮助读者掌握数据探索中的关键可视化技巧。
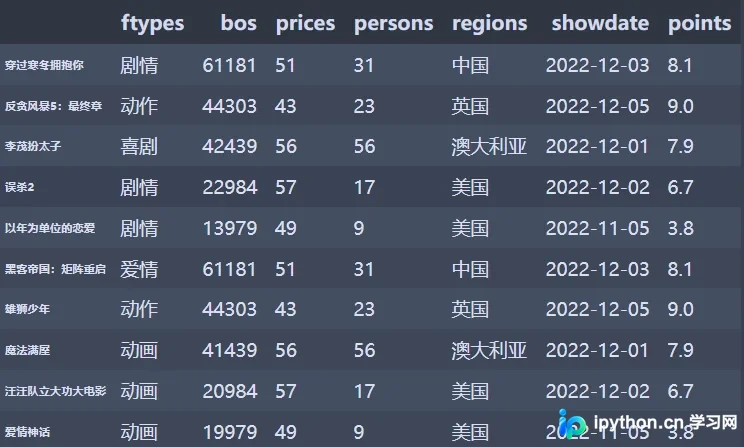
本文详解Python中Seaborn库的高级绘图应用。内容涵盖环境配置、调色板设定,并演示折线图、柱状图、直方图、点图、箱线图及小提琴图的绘制方法。通过电影票房数据实例,展示如何处理文本与数值转换,实现多维数据的直观可视化分析。
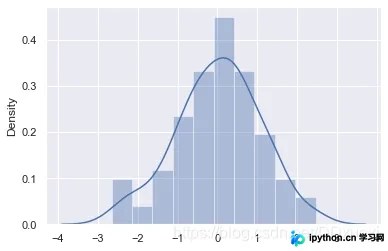
本文详细介绍Python中Seaborn库的distplot()函数,涵盖hist、kde、rug、fit、bins等核心参数的使用方法。通过代码示例解析如何控制直方图与核密度估计的显示,调整坐标轴标签及分布拟合,帮助开发者快速掌握数据分布可视化技巧。
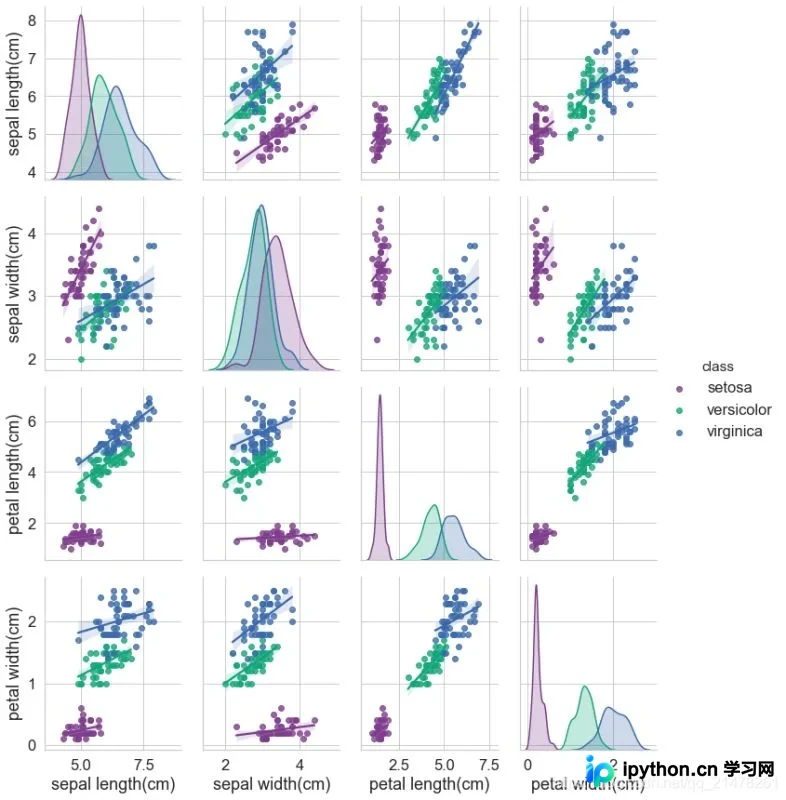
本文详细解析Python中seaborn库绘制矩阵图的两种核心方法:pairplot与PairGrid。通过鸢尾花数据集示例,演示如何配置颜色、变量子集、对角线与非对角线图形类型及趋势线,并对比两者的灵活性与适用场景,帮助开发者快速掌握多维数据可视化技巧。
本文介绍如何使用Python的Seaborn库绘制数值箱型图,通过Boss直聘八个城市的算法岗位数据,展示不同职位的薪资分布。文章涵盖数据清洗、导入及绘图代码,重点解析箱线图、散点图叠加及辅助线的实现,帮助读者掌握多类别连续数据的对比分析方法。