Python数据重采样实战:使用SMOTE解决类不平衡问题
数据重采样是处理机器学习类不平衡问题的关键技术。通过调整数据集样本分布,可防止模型偏向多数类。本文将详解SMOTE等核心原理,并提供基于Python imblearn库的操作代码,帮助开发者快速构建平衡数据集以提升模型训练效果。
2026-10-11
6

数据重采样是处理机器学习类不平衡问题的关键技术。通过调整数据集样本分布,可防止模型偏向多数类。本文将详解SMOTE等核心原理,并提供基于Python imblearn库的操作代码,帮助开发者快速构建平衡数据集以提升模型训练效果。
本文介绍如何使用 Python 将数据集按指定比例随机划分为训练集和测试集。通过读取 CSV 文件并跳过表头,利用 random.sample 函数选取测试集数据,剩余部分即为训练集。该方法适用于简单的机器学习数据预处理场景,帮助快速构建模型训练环境。
数据预处理是提升机器学习模型性能的关键环节。本文详细介绍基于Python与scikit-learn的核心预处理步骤,涵盖缺失值智能填充、异常值统计检测、分类变量独热与顺序编码,以及数值特征的标准化与归一化转换。结合可直接运行的代码示例,提供从原始数据到模型就绪数据的完整操作指引。
大数据开发常面临语言选择难题。Python凭借简洁语法、丰富的数据科学库及胶水语言特性,成为入门首选。相比Java在商业逻辑和底层性能上的优势,Python在快速开发、算法验证及AI生态中表现更佳。本文解析两者差异,助您做出合理选择。
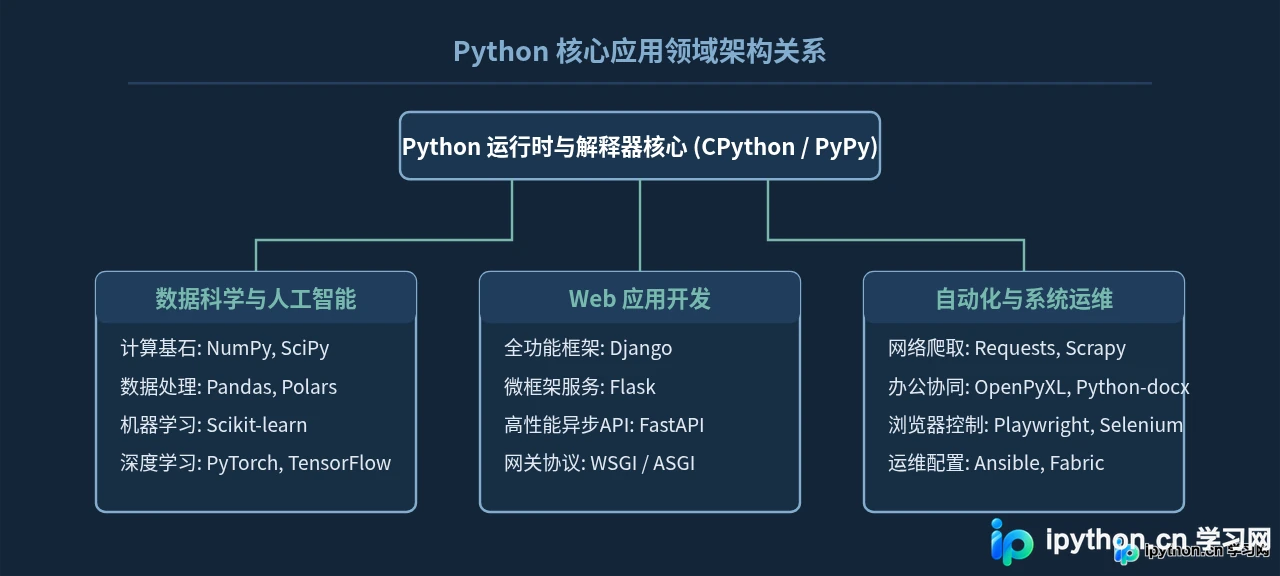
深入解析Python在数据科学、Web开发和日常办公及运维自动化三大核心领域的实际应用形态、典型技术栈、代码工作流与选型考量。
深入对比数据科学从业者常用的Python开发工具Jupyter Lab与Spyder,解析交互式探索与集中式工程调试的核心差异、操作流程与选型依据。
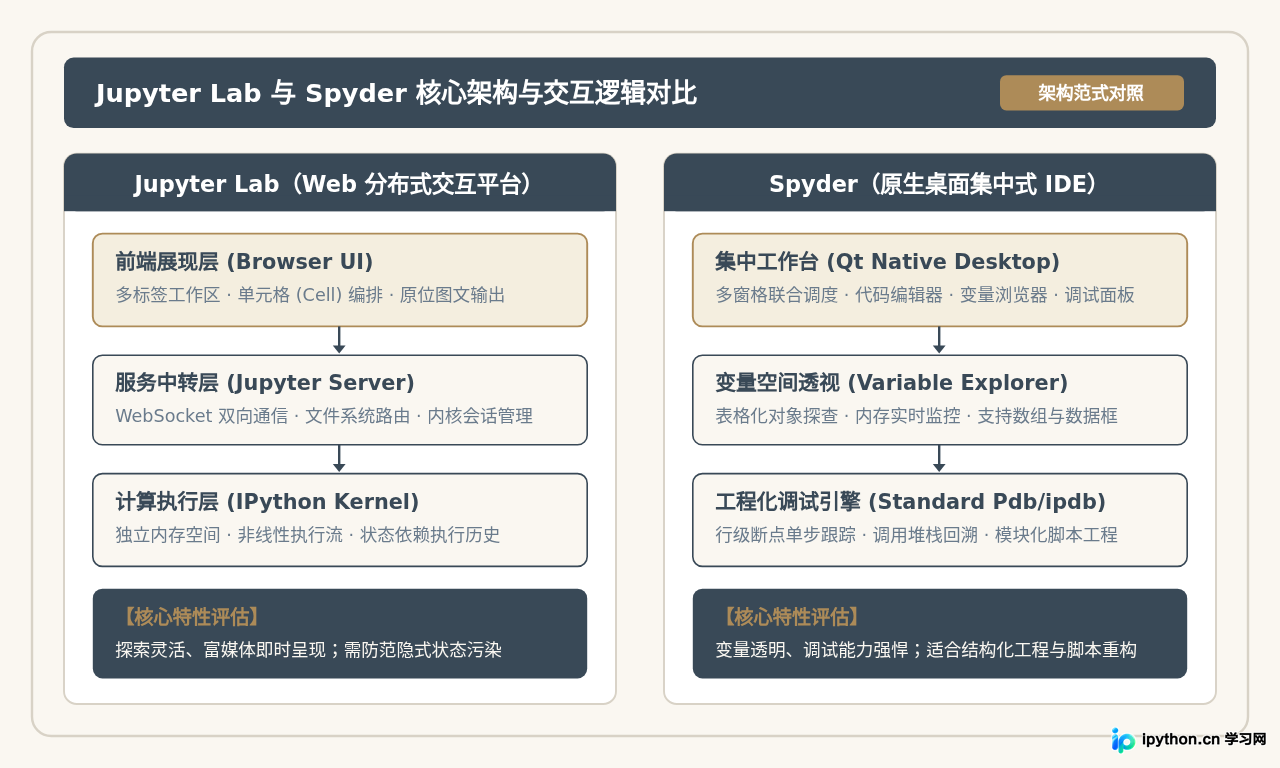
本文深入解析人工智能专业的核心课程体系,重点剖析线性代数、概率论等数学基础的实际应用价值,并客观评估编程与算法的学习难度。通过拆解从理论推导到工程落地的完整路径,帮助读者厘清AI专业的真实门槛,判断自身是否适合投身这一领域。
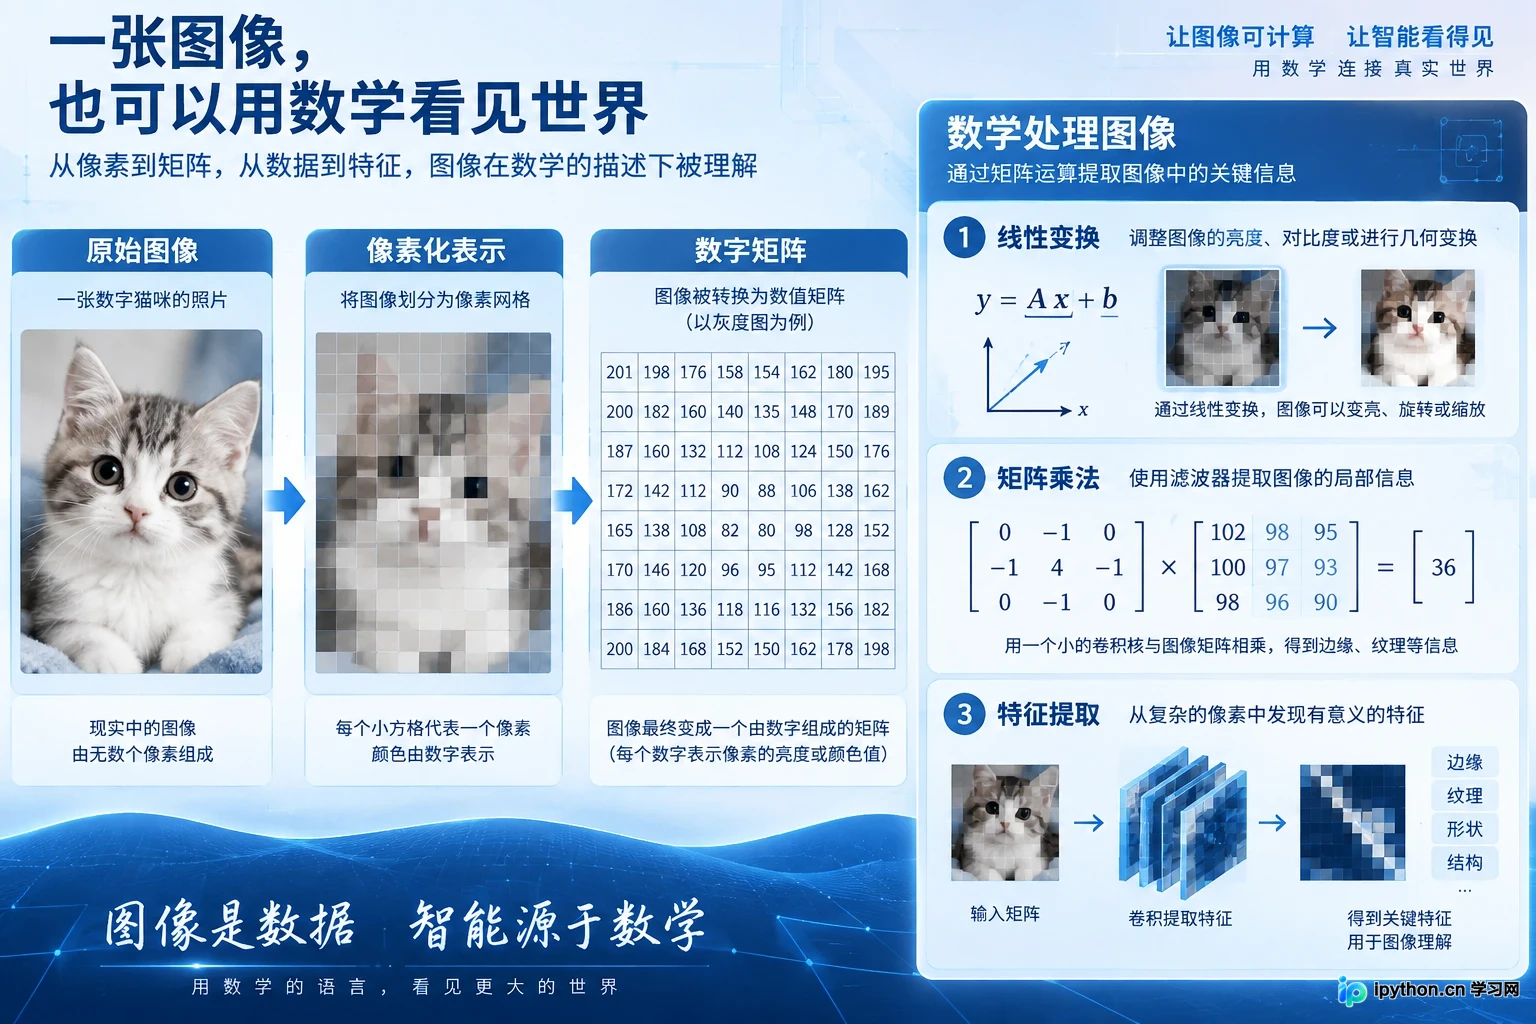
本文深入分析人工智能专业本科生与研究生在就业市场中的真实竞争力差异。通过拆解算法岗、开发岗等不同职业路径的门槛,揭示学历对起薪、晋升及核心研发机会的影响,帮助读者理性判断是否必须考研。
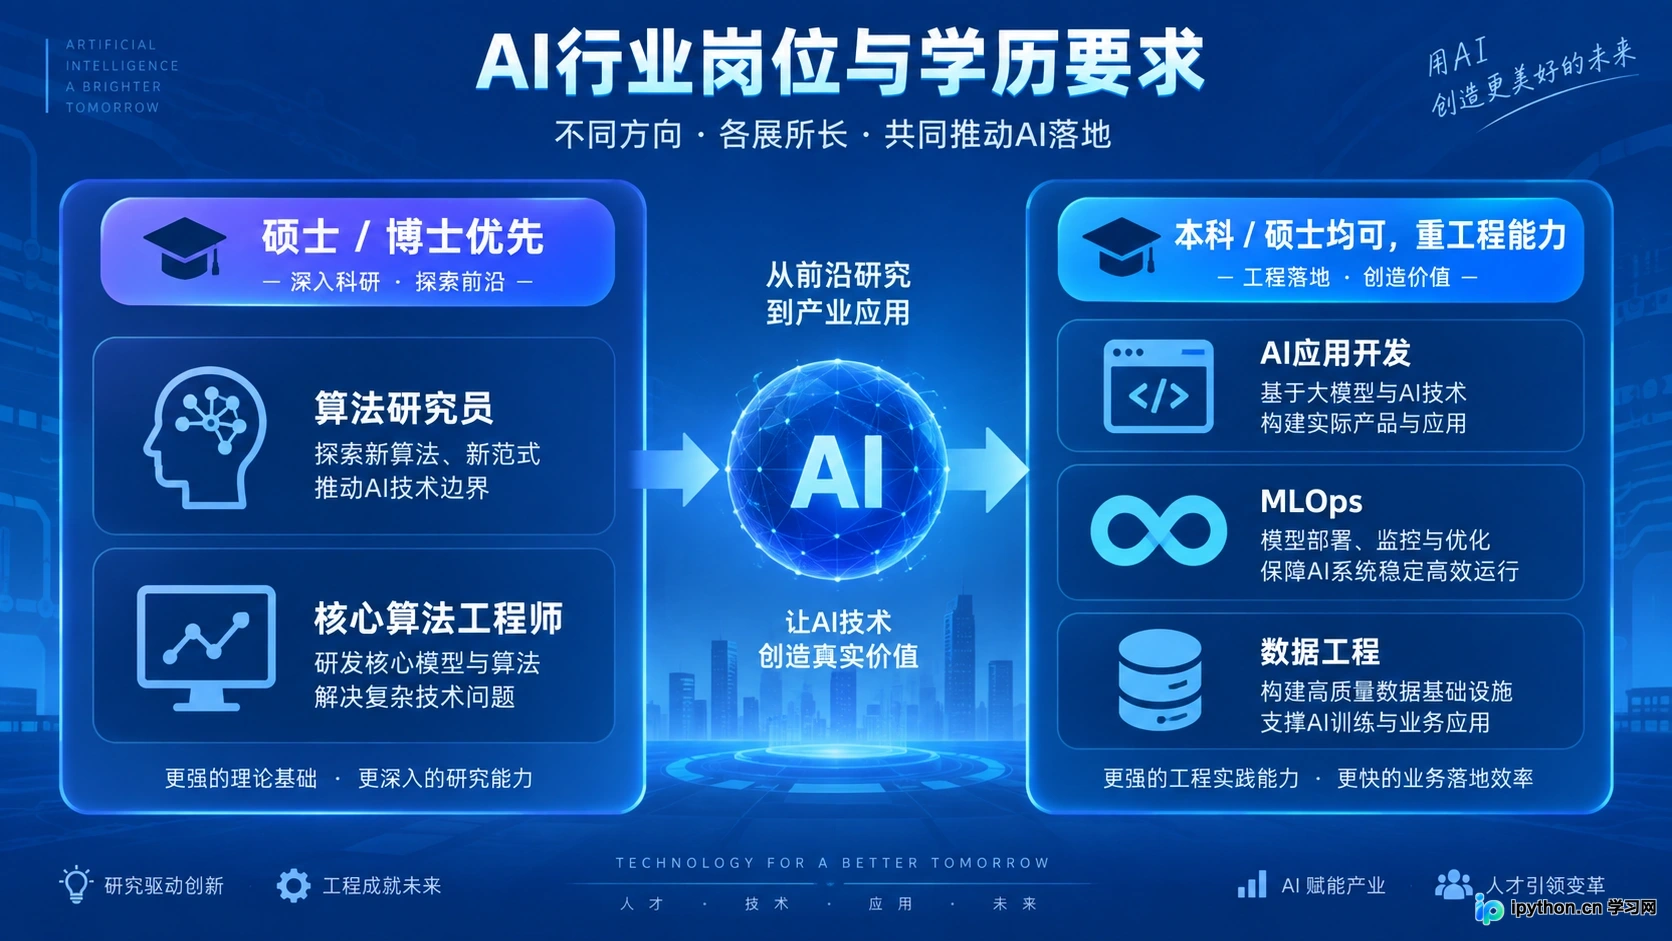
人工智能专业并非全面饱和,而是呈现结构性失衡。初级算法岗位竞争激烈,但具备工程落地能力、跨学科背景及垂直行业经验的复合型人才依然稀缺。本文通过分析招聘市场现状,指出从“调参侠”向“AI工程师”转型的必要性,为从业者提供破局思路。
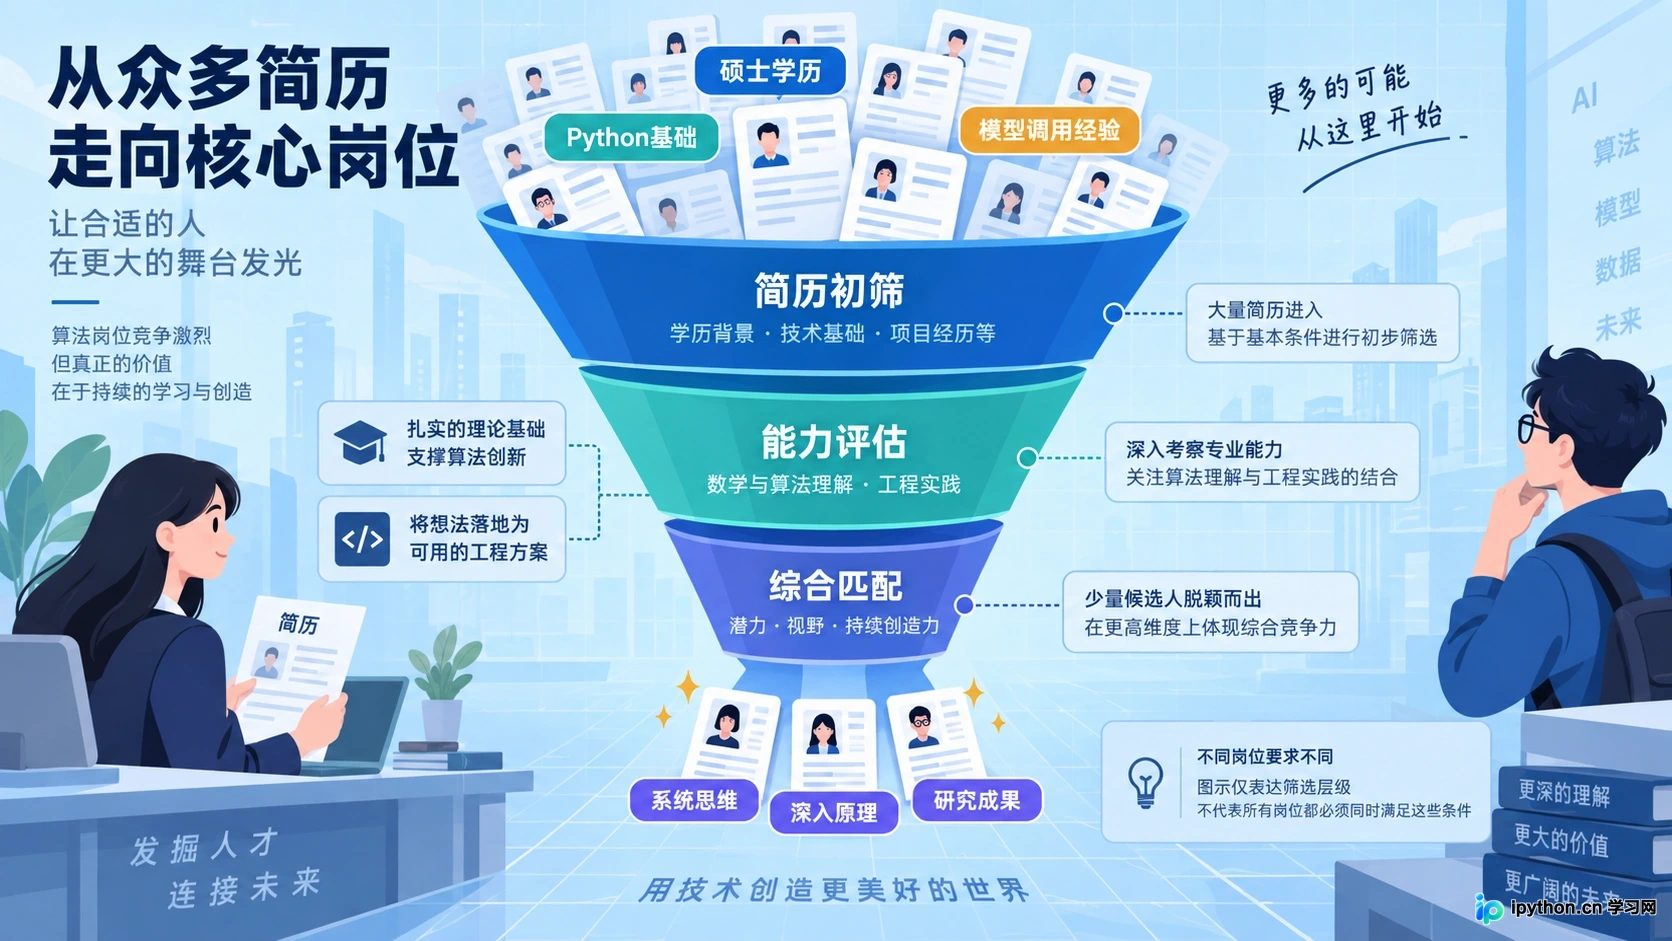
本文探讨普通二本院校人工智能专业学生的职业发展路径。分析院校层次在求职初期的筛选作用,对比学历背景与个人能力在长期发展中的权重,提供从基础夯实到项目实战的具体建议,帮助非顶尖院校学生打破就业壁垒。
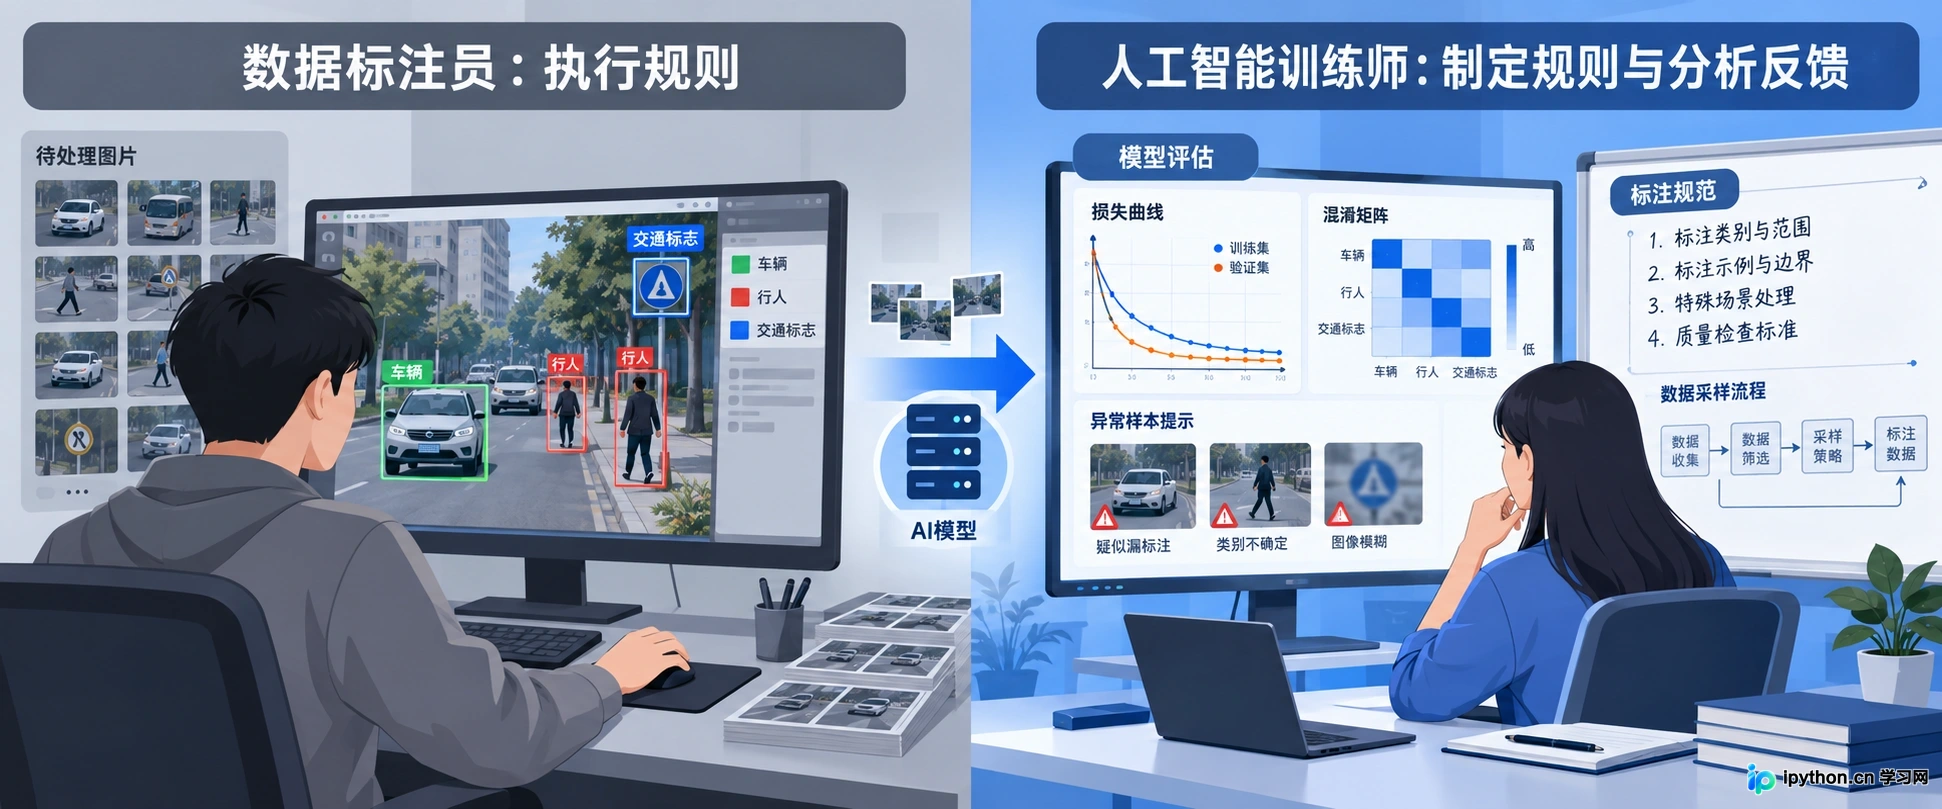
本文深入剖析人工智能训练师与数据标注员在职责、技能要求及职业路径上的本质差异。通过具体工作场景对比,揭示从“数据加工”到“模型优化”的跃迁逻辑,帮助从业者明确职业定位,避免陷入低水平重复劳动的误区,为向高阶AI岗位转型提供清晰指引。
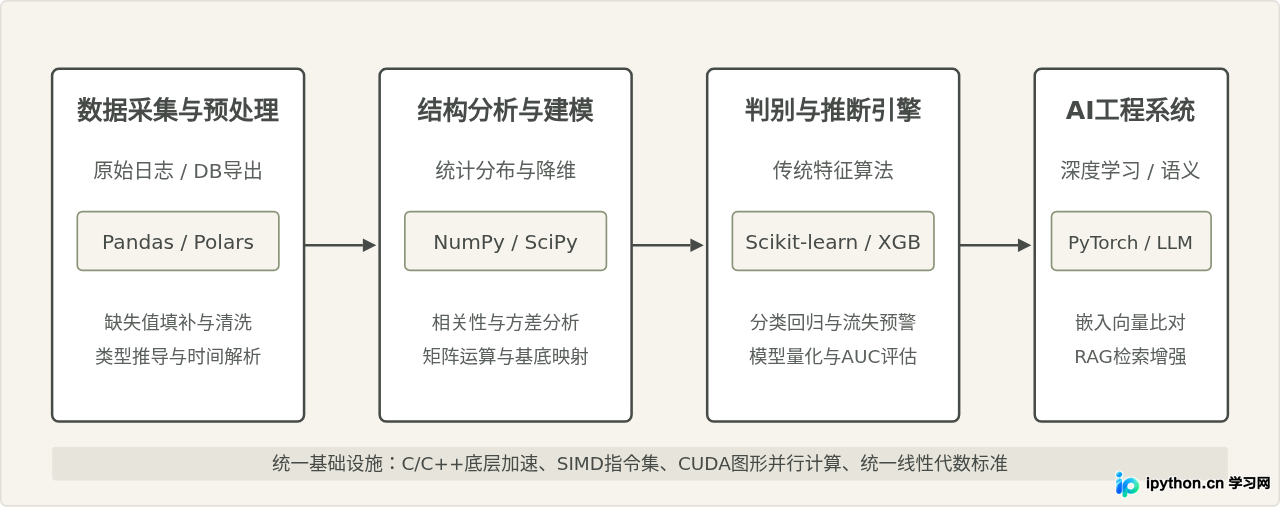
深入解析Python在数据分析与人工智能领域的核心应用场景,涵盖数据清洗、指标建模、经典机器学习及大模型工程,提供完整可落地的代码示例与架构图解。