

Python scikit-learn 线性回归实战:波士顿房价预测详解

本文基于Python scikit-learn库,通过波士顿房价数据集演示线性回归算法的完整应用流程。内容涵盖数据导入、特征工程、模型构建及预测评估,详细解析如何加载内置数据、探索特征分布、拟合线性回归模型并计算均方误差,为初学者提供从理论到代码落地的清晰指引。
一、概述
近年来,在大数据热潮的推动下,机器学习算法已逐渐进入大众视野。即便不熟悉底层理论,许多人也能熟练说出几个知名算法的名称。尽管算法种类繁多,但真正能在特定场景下表现优异并得到广泛应用的算法并不多。随着社区实践的深入,部分算法因效果显著而获得持续支持与优化,逐渐成为主流选择。
以分类算法为例,主要可分为线性与非线性两类。线性算法包括逻辑回归、朴素贝叶斯和最大熵等,其优势在于训练与预测效率较高,但对特征的质量依赖极强,要求数据在特征空间中具备线性可分性。因此,使用线性算法需投入大量精力进行特征工程,通过选择、变换或组合特征来提升区分度。相比之下,非线性算法(如随机森林、决策树、神经网络和核机器等)能够构建复杂的分类边界,从而更好地拟合数据分布。
在特征选定后,如何评估哪种算法效果更佳?这往往没有定论,实践是检验算法优劣的唯一标准。然而,逐一编写多个机器学习模型代码既耗时又低效。鉴于此,机器学习社区倡导“不重复造轮子”的理念,针对成熟算法提供了丰富的开源库,大幅节省了开发者的调研与实现时间。
鉴于Python在数据科学领域的广泛应用,scikit-learn作为其核心机器学习库,凭借接口简洁、抽象良好及文档完善等优势备受推崇。本文旨在封装多种机器学习算法进行对比测试,以便分析优劣。当然,针对特定算法的超参数调优同样至关重要。
二、Scikit-learn的Python实践
本文将利用线性回归算法对波士顿房价数据进行预测。该数据集记录了波士顿郊区住房价值的相关信息,是机器学习中常用的基准数据集之一。
第一步:Python库导入
%matplotlib inline
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import sklearn
第二步:数据获取与理解
波士顿数据集是scikit-learn的内置资源,可直接调用使用。
from sklearn.datasets import load_boston
boston = load_boston()
print(boston.keys())
dict_keys(['data', 'target', 'feature_names', 'DESCR'])
print(boston.data.shape)
(506, 13)
print(boston.feature_names)
['CRIM' 'ZN' 'INDUS' 'CHAS' 'NOX' 'RM' 'AGE' 'DIS' 'RAD' 'TAX' 'PTRATIO' 'B' 'LSTAT']
结论:波士顿数据集包含506个样本,共14个特征(含目标变量)。
print(boston.DESCR)
bos = pd.DataFrame(boston.data)
print(bos.head())
    0   1   2  3   4   5   6    7  8   9   10 \
0 0.00632 18.0 2.31 0.0 0.538 6.575 65.2 4.0900 1.0 296.0 15.3
1 0.02731  0.0 7.07 0.0 0.469 6.421 78.9 4.9671 2.0 242.0 17.8
2 0.02729  0.0 7.07 0.0 0.469 7.185 61.1 4.9671 2.0 242.0 17.8
3 0.03237  0.0 2.18 0.0 0.458 6.998 45.8 6.0622 3.0 222.0 18.7
4 0.06905  0.0 2.18 0.0 0.458 7.147 54.2 6.0622 3.0 222.0 18.7
    11  12
0 396.90 4.98
1 396.90 9.14
2 392.83 4.03
3 394.63 2.94
4 396.90 5.33
bos.columns = boston.feature_names
print(bos.head())
print(boston.target[:5])
bos['PRICE'] = boston.target
bos.head()
第三步:数据模型构建——线性回归
from sklearn.linear_model import LinearRegression
X = bos.drop('PRICE', axis=1)
lm = LinearRegression()
lm
lm.fit(X, bos.PRICE)
print('线性回归算法w值:', lm.coef_)
print('线性回归算法b值: ', lm.intercept_)
import matplotlib.font_manager as fm
myfont = fm.FontProperties(fname='C:/Windows/Fonts/msyh.ttc')
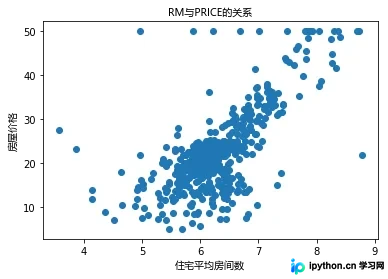
plt.scatter(bos.RM, bos.PRICE)
plt.xlabel(u'住宅平均房间数', fontproperties=myfont)
plt.ylabel(u'房屋价格', fontproperties=myfont)
plt.title(u'RM与PRICE的关系', fontproperties=myfont)
plt.show()
第四步:数据模型应用——预测房价
lm.predict(X)[0:5]
array([ 30.00821269, 25.0298606 , 30.5702317 , 28.60814055, 27.94288232])
mse = np.mean((bos.PRICE - lm.predict(X)) ** 2)
print(mse)
21.897779217687486
总结
1 使用.DESCR探索波士顿数据集,业务目标是预测波士顿郊区住房的房价;
2 使用scikit-learn针对整个数据集拟合线性回归模型,并计算均方误差。
思考环节
1 对数据集分割成训练数据集和测试数据集
2 训练数据集训练线性回归模型,利用线性回归模型对测试数据集进行预测
3 计算训练模型的MSE和测试数据集预测结果的MSE
4 绘制测试数据集的残差图
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









