

Python使用NLTK进行自然语言处理入门指南

本文详解Python中NLTK库的基础应用,涵盖环境配置、分句与分词操作。重点解析WordPunctTokenizer与regexp_tokenize的使用,并针对NLTK 3.1+版本中compile_regexp_to_noncapturing废弃导致的兼容性问题,提供修正后的正则分词代码方案,帮助开发者高效进行文本预处理。
自然语言处理(NLP)是计算机科学和人工智能领域的重要分支。NLTK(Natural Language Toolkit,自然语言工具包)是基于Python的流行类库,也是当前NLP编程与开发中最常用的工具之一。在NLP研究与应用中,合理调用NLTK提供的函数能显著提升效率。本文将通过具体实例介绍NLTK的使用方法。
NLTK
NLTK(Natural Language Toolkit,自然语言处理工具包)是NLP领域最常用的Python库。
NLTK是一个开源项目,包含Python模块、数据集和教程,旨在支持NLP的研究与开发。该库由Steven Bird和Edward Loper在宾夕法尼亚大学计算机和信息科学系开发。NLTK包含图形演示和示例数据,其提供的教程解释了工具包所支持的语言处理任务背后的基本概念。
开发环境方面,本文使用的Python版本为最新的3.5.1,NLTK版本为3.2。Python的安装过程不在本文讨论范围内。您可以从NLTK官网http://www.nltk.org/获取最新版本。使用pip指令下载和安装NLTK包是最简便的方法。
完成上述步骤后,工作尚未结束。NLTK由多个子包构成。此时运行Python,输入以下指令(首先需导入NLTK包):
>>> import nltk
>>> nltk.download()
随后,Python Launcher会弹出界面,建议选择安装所有Packages,以避免日后反复安装,并为后续开发提供稳定环境。部分包的Status显示“out of date”,通常无需理会,这基本不影响使用与开发。
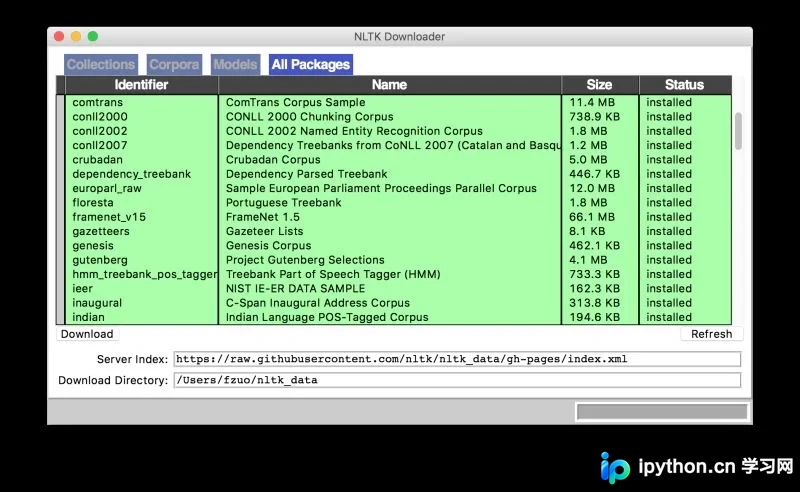
安装成功后,我们进行初步测试。本文主要涉及自然语言处理中最常用、最基础的预处理(pre-processing)过程,结合机器学习的高级应用将在后续文章中介绍。
1、SentencesSegment(分句)
假设我们有一段文本,希望将其分割为单个句子。此时可以使用NLTK中的punkt sentencesegmenter。示例代码如下:
>>> sent_tokenizer = nltk.data.load('tokenizers/punkt/english.pickle')
>>> paragraph = "The first time I heard that song was in Hawaii on radio.
... I was just a kid, and loved it very much! What a fantastic song!"
>>> sentences = sent_tokenizer.tokenize(paragraph)
>>> sentences
['The first time I heard that song was in Hawaii on radio.',
 'I was just a kid, and loved it very much!',
 'What a fantastic song!']
由此,我们成功将一段话分句。
2、SentencesSegment(分词)
接下来,我们将每个句子进一步切割为单词。最简单的方法是使用NLTK包中的WordPuncttokenizer。示例代码如下:
>>> from nltk.tokenize import WordPunctTokenizer
>>> sentence = "Are you old enough to remember Michael Jackson attending
... the Grammys with Brooke Shields and Webster sat on his lap during the show?"
>>> words = WordPunctTokenizer().tokenize(sentence)
>>> words
['Are', 'you', 'old', 'enough', 'to', 'remember', 'Michael', 'Jackson', 'attending',
 'the', 'Grammys', 'with', 'Brooke', 'Shields', 'and', 'Webster', 'sat', 'on', 'his',
 'lap', 'during', 'the', 'show', '?']
我们的分词任务完成良好。除了WordPunct tokenizer外,NLTK还提供另外三种分词方法:TreebankWordTokenizer、PunktWordTokenizer和WhitespaceTokenizer,用法与WordPunct tokenizer类似。然而,对于复杂词型,WordPunct tokenizer往往力不从心。此时需借助正则表达式的强大能力,使用函数regexp_tokenize()。见下文示例:
>>> text = 'That U.S.A. poster-print costs $12.40...'
目前市面上参考的Python下NLP书籍由Steven Bird、Ewan Klein、Edward Loper编写的《Python 自然语言处理》。该书编写时间距今近十年,由于软件包更新等原因,在新环境下部分代码无法正常运行。以下举书中代码out of date的例子(对上述句子进行分词),并给出解决办法。首先看书中节录:
>>> text = 'That U.S.A. poster-print costs $12.40...'
>>> pattern = r'''''(?x)  # set flag to allow verbose regexps
...   ([A-Z]\.)+    # abbreviations, e.g. U.S.A.
...  | \w+(-\w+)*    # words with optional internal hyphens
...  | \$?\d+(\.\d+)?%? # currency and percentages, e.g. $12.40, 82%
...  | \.\.\.      # ellipsis
...  | [][.,;"'?():-_`] # these are separate tokens; includes ], [
... '''
>>> nltk.regexp_tokenize(text, pattern)
我们预期的输出结果如下:
['That', 'U.S.A.', 'poster-print', 'costs', '$12.40', '...']
但实际得到的输出却是这样的(注意所使用的NLTK版本):
[('', '', ''),
 ('A.', '', ''),
 ('', '-print', ''),
 ('', '', ''),
 ('', '', '.40'),
 ('', '', '')]
出现此问题是因为nltk.internals.compile_regexp_to_noncapturing()在V3.1版本的NLTK中已被废弃(尽管更早版本仍可运行)。为此,我们将之前定义的pattern稍作修改:
pattern = r"""(?x)          # set flag to allow verbose regexps
       (?:[A-Z]\.)+      # abbreviations, e.g. U.S.A.
       |\d+(?:\.\d+)?%?    # numbers, incl. currency and percentages
       |\w+(?:[-']\w+)*    # words w/ optional internal hyphens/apostrophe
       |\.\.\.        # ellipsis
       |(?:[.,;"'?():-_`])  # special characters with meanings
      """
再次执行前述语句,即可得到:
>>> nltk.regexp_tokenize(text, pattern)
['That', 'U.S.A.', 'poster-print', 'costs', '12.40', '...']
以上是对NLTK这一自然语言处理工具包的初步探索。日后主页君将结合机器学习方法探讨更深入的应用。最后,我想说《Python 自然语言处理》仍是当前非常值得推荐的讲述利用NLTK和Python进行自然语言处理技术的书籍。
总结
以上就是本文关于Python编程使用NLTK进行自然语言处理详解的全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站:
python中requests库session对象的妙用详解
13个最常用的Python深度学习库介绍
python爬虫系列Selenium定向爬取虎扑篮球图片详解
如有不足之处,欢迎留言指出。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









